保守中AIエージェント · コンテキストエンジニアリング · Python
doc-processing-toolkit
複数のモデルプロバイダーに対応した、AIエージェントのためのPythonフレームワーク。ツール、永続的なセッション、コスト追跡を備えています。
約9分で読めます
- 1つのAgent APIで扱うモデルプロバイダー
- 4
- レジストリに登録されたモデル(v0.5.4時点、2026年10月)
- 107
- v0.5.4のリリース時に合格したオフラインのユニットテスト(2026年10月)
- 9,834
使用技術
- Python
- Pydantic
- MCP
- Anthropic API
- OpenAI API
- Google Gemini API
- Fireworks
- pytest
- MkDocs
開発の背景
取り組んでいた顧客プロジェクトでは、同じ基盤部分が繰り返し必要になっていました。複数のモデルプロバイダーの呼び出し、モデルが呼び出せるツール、構造化出力、ストリーミング、そしてコストをある程度制御する仕組みです。それをプロジェクトごとに作り直すのは時間がかかり、ミスも起きやすいため、2025年10月に独自のフレームワークを作り始めました。出発点はドキュメント処理で、名前はそこから来ています。その後、ドキュメントパイプライン、リサーチアシスタント、ブラウザーやデスクトップを操作するエージェント、音声セッション、マルチエージェントシステムなど、さまざまな種類のAIエージェントのための汎用フレームワークへと成長しました。
LangChainのような既製のエージェントフレームワークを使うこともできましたが、自分で書くことを選びました。各プロバイダー自身のSDKはわかりやすく、ドキュメントも充実しています。また、AIコーディングツールを使えば、プロジェクトに必要な層を書くのにそれほど手間はかかりません。自作のフレームワークには自分が使うコードしか含まれず、私が変更したときにしか変わりません。費用を払っている顧客がそのソフトウェアに頼っている場合、これは重要です。サードパーティのフレームワークが更新されると、私のコードの動作が変わる可能性があるからです。toolkitの依存関係は、各プロバイダーのSDKと、Pydanticなどのいくつかの汎用ライブラリです。
ドキュメントサイトをご覧ください。ドキュメントは公開していますが、ソースコードは非公開です。toolkitはPyPIでは公開しておらず、アプリケーションは非公開のGitリポジトリからリリースタグを指定してインストールします。詳しく知りたい場合は、LinkedInでつながってください(お問い合わせをご覧ください)。
プロバイダー、モデル、ツール
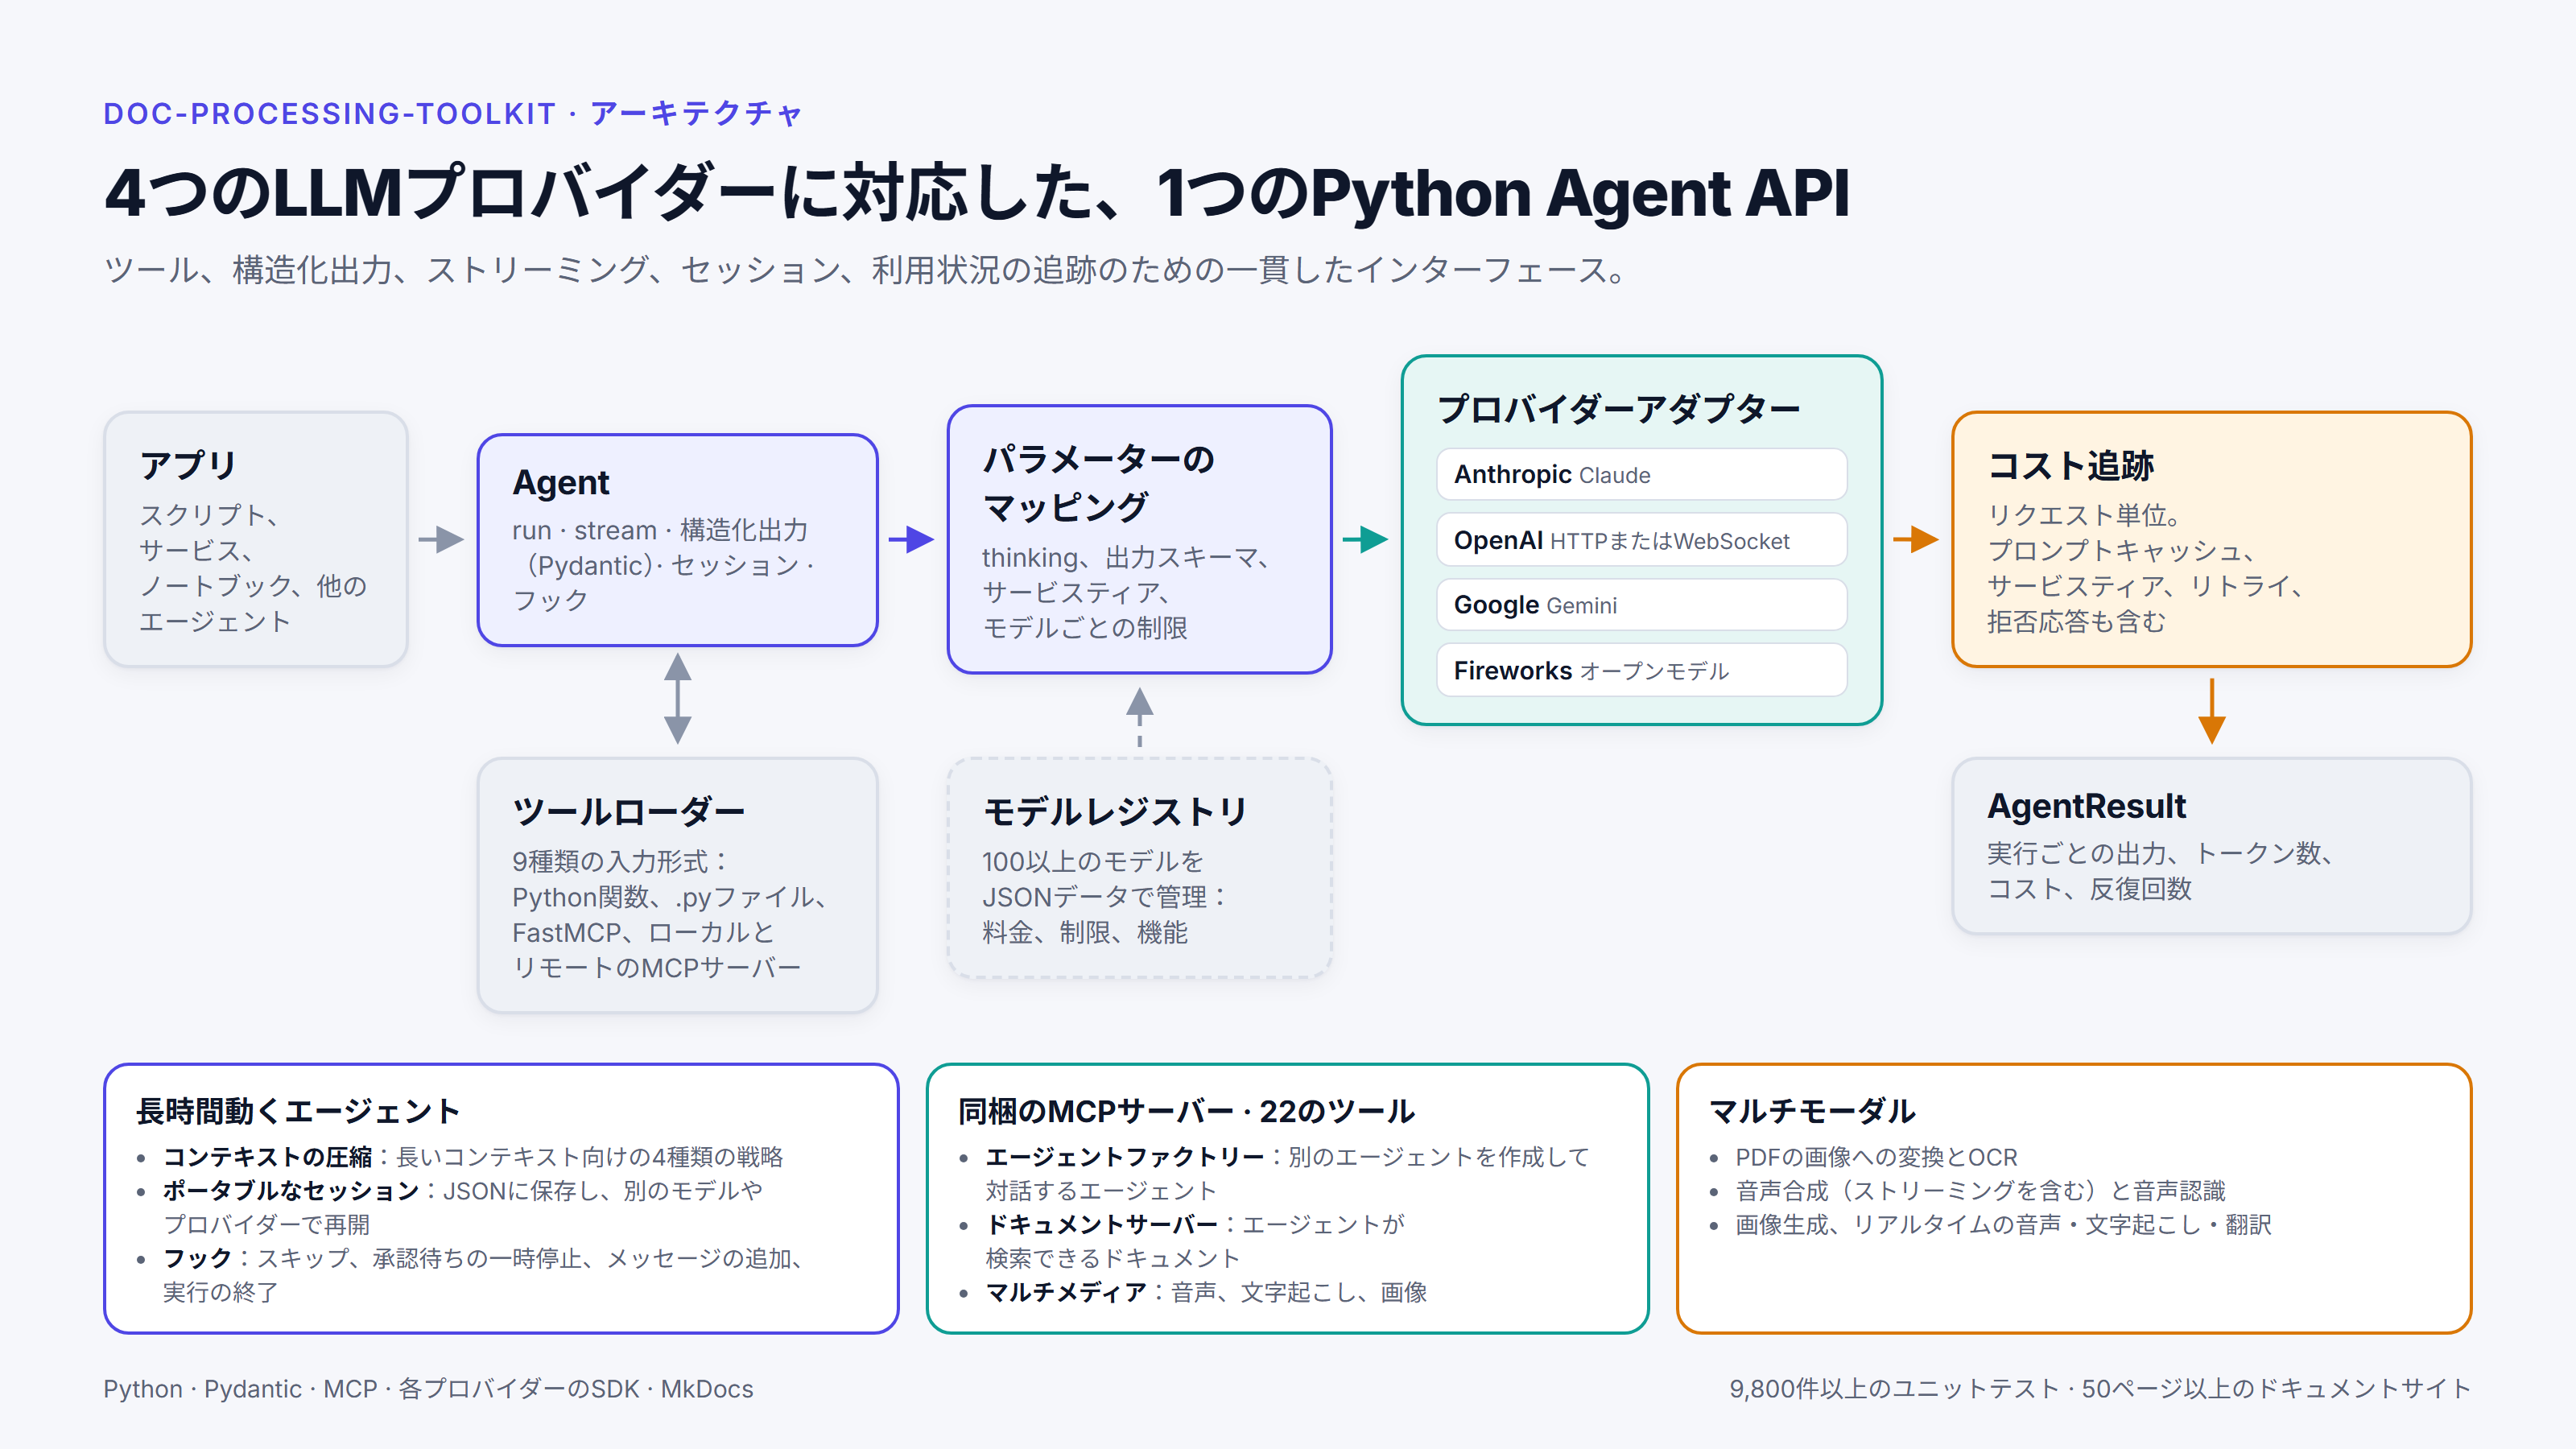
アプリケーションは、モデル名、指示、ツールのリストを指定してAgentを作成し、メッセージを渡して実行します。実行は1回の呼び出しでも、ストリームでもかまいません。結果には、出力とあわせてトークン数とコストが含まれます。同じインターフェースがAnthropic、OpenAI、Google Gemini、Fireworks(オープンモデルをホストするサービス)で動きます。車がエンジンを載せ替えられるように、アプリケーションはプロバイダーを切り替えられます。アプリケーションの他の部分はそのままで、エージェントを別のプロバイダーに移すときは、おおむねモデル名を変えるだけで済みます。
インターフェースの裏側には、モデルレジストリがあります。各モデルの料金、制限、機能を記録したJSONファイルです。v0.5.4(2026年10月)時点で、画像、音声、リアルタイムのモデルを含む107のモデルが登録されています。レジストリはデータなので、新しいモデルの多くはコードを一切変えずに追加できます。
ツールは、9種類の入力形式で渡せます。@toolデコレーターを付けた普通のPython関数から、ローカルやリモートのMCPサーバーまで対応しています。MCP (Model Context Protocol) は、AIアプリケーションを、別のサーバーが提供するツールやデータに接続するためのオープンな標準です。構造化出力はどのプロバイダーでもPydanticで検証し、ストリーミングは4つのプロバイダーすべてで同じように動作します。
toolkitは、マルチモーダルな処理にも対応しています。PDFの画像への変換、OCR、音声の入力と出力、画像の生成と編集、リアルタイム音声セッションです。また、独自のMCPサーバーもいくつか同梱しており、その中には、あるエージェントが別のエージェントを作成して対話できるようにするエージェントファクトリーも含まれます。
セッションと承認
長時間動くエージェントや、クリック、入力、ブラウジングを行うエージェントには、状態を保存しておく場所と、アプリケーションが介入できる明確なポイントが必要です。
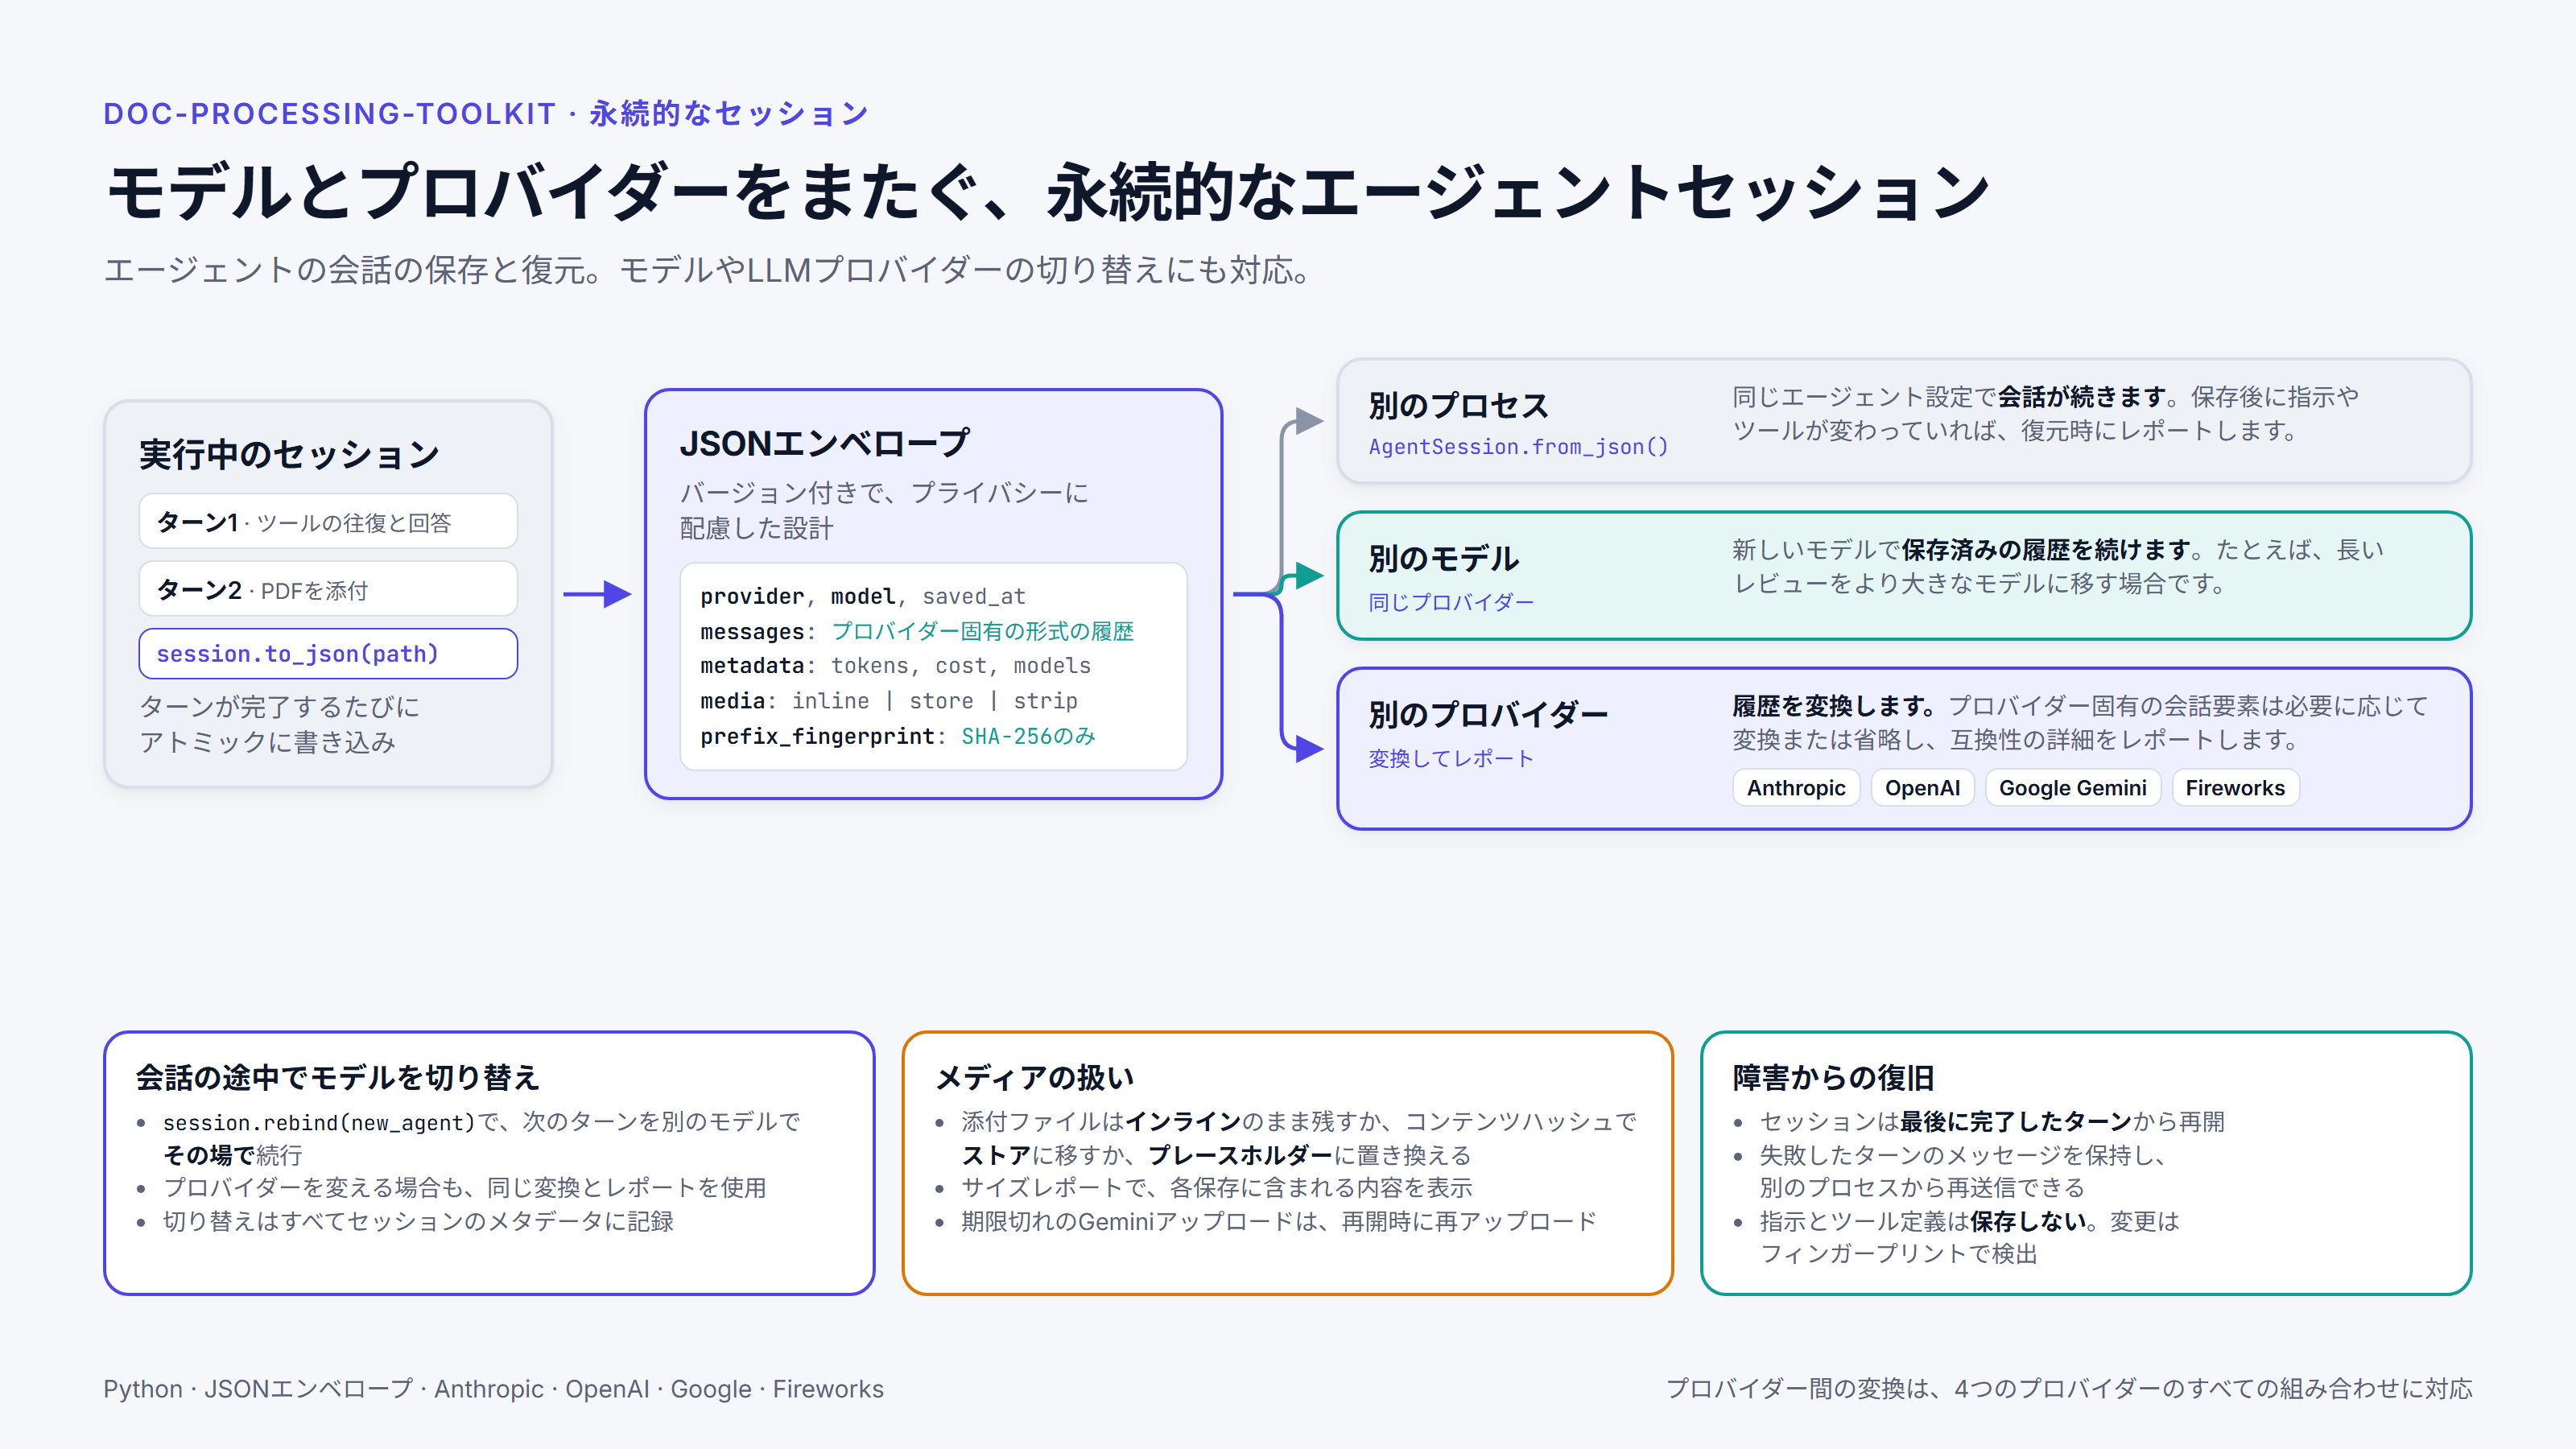
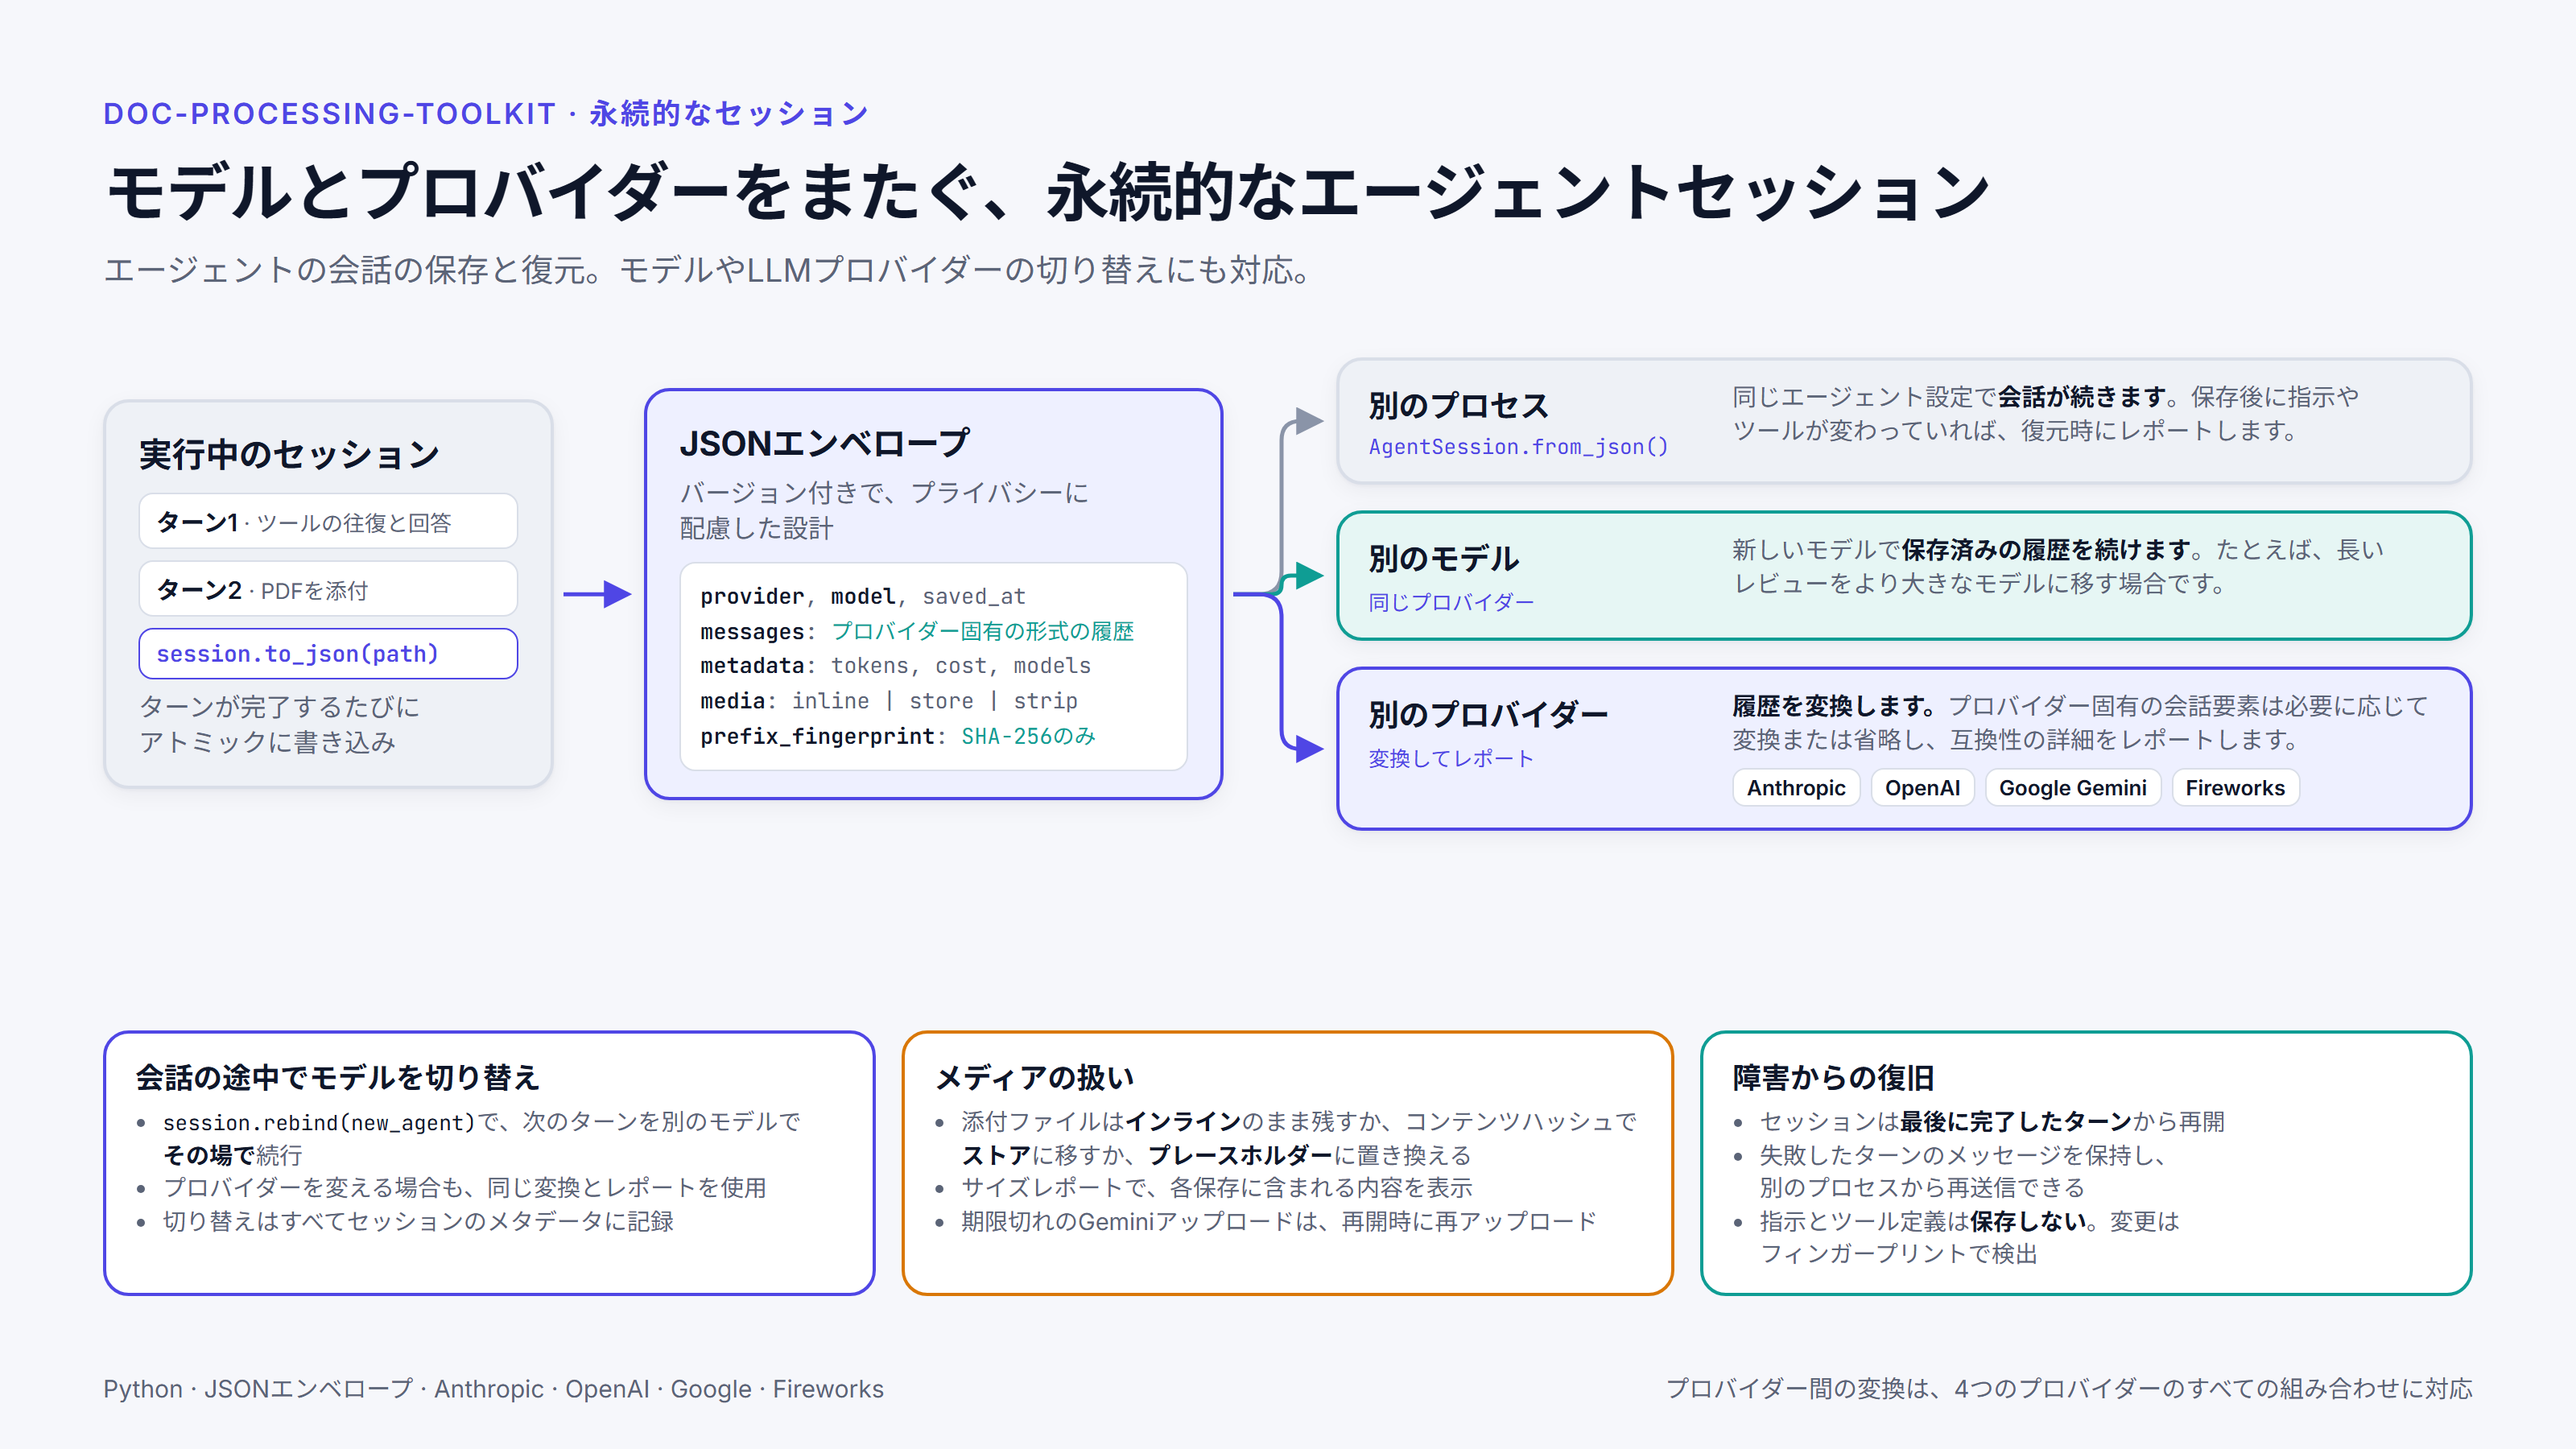
長い会話はモデルのコンテキストウィンドウに収まらなくなることがあるため、toolkitには、呼び出しの前やツールの往復の合間に履歴を短くする、4種類の圧縮戦略があります。セッションは、これに永続性を加えます。セッションはターンが完了するたびにJSONに保存されるので、会話は後から別のプロセス、別のモデル、別のプロバイダーで続けられます。プロバイダー間で移すときは、toolkitが履歴を変換し、引き継げなかった内容をレポートします。
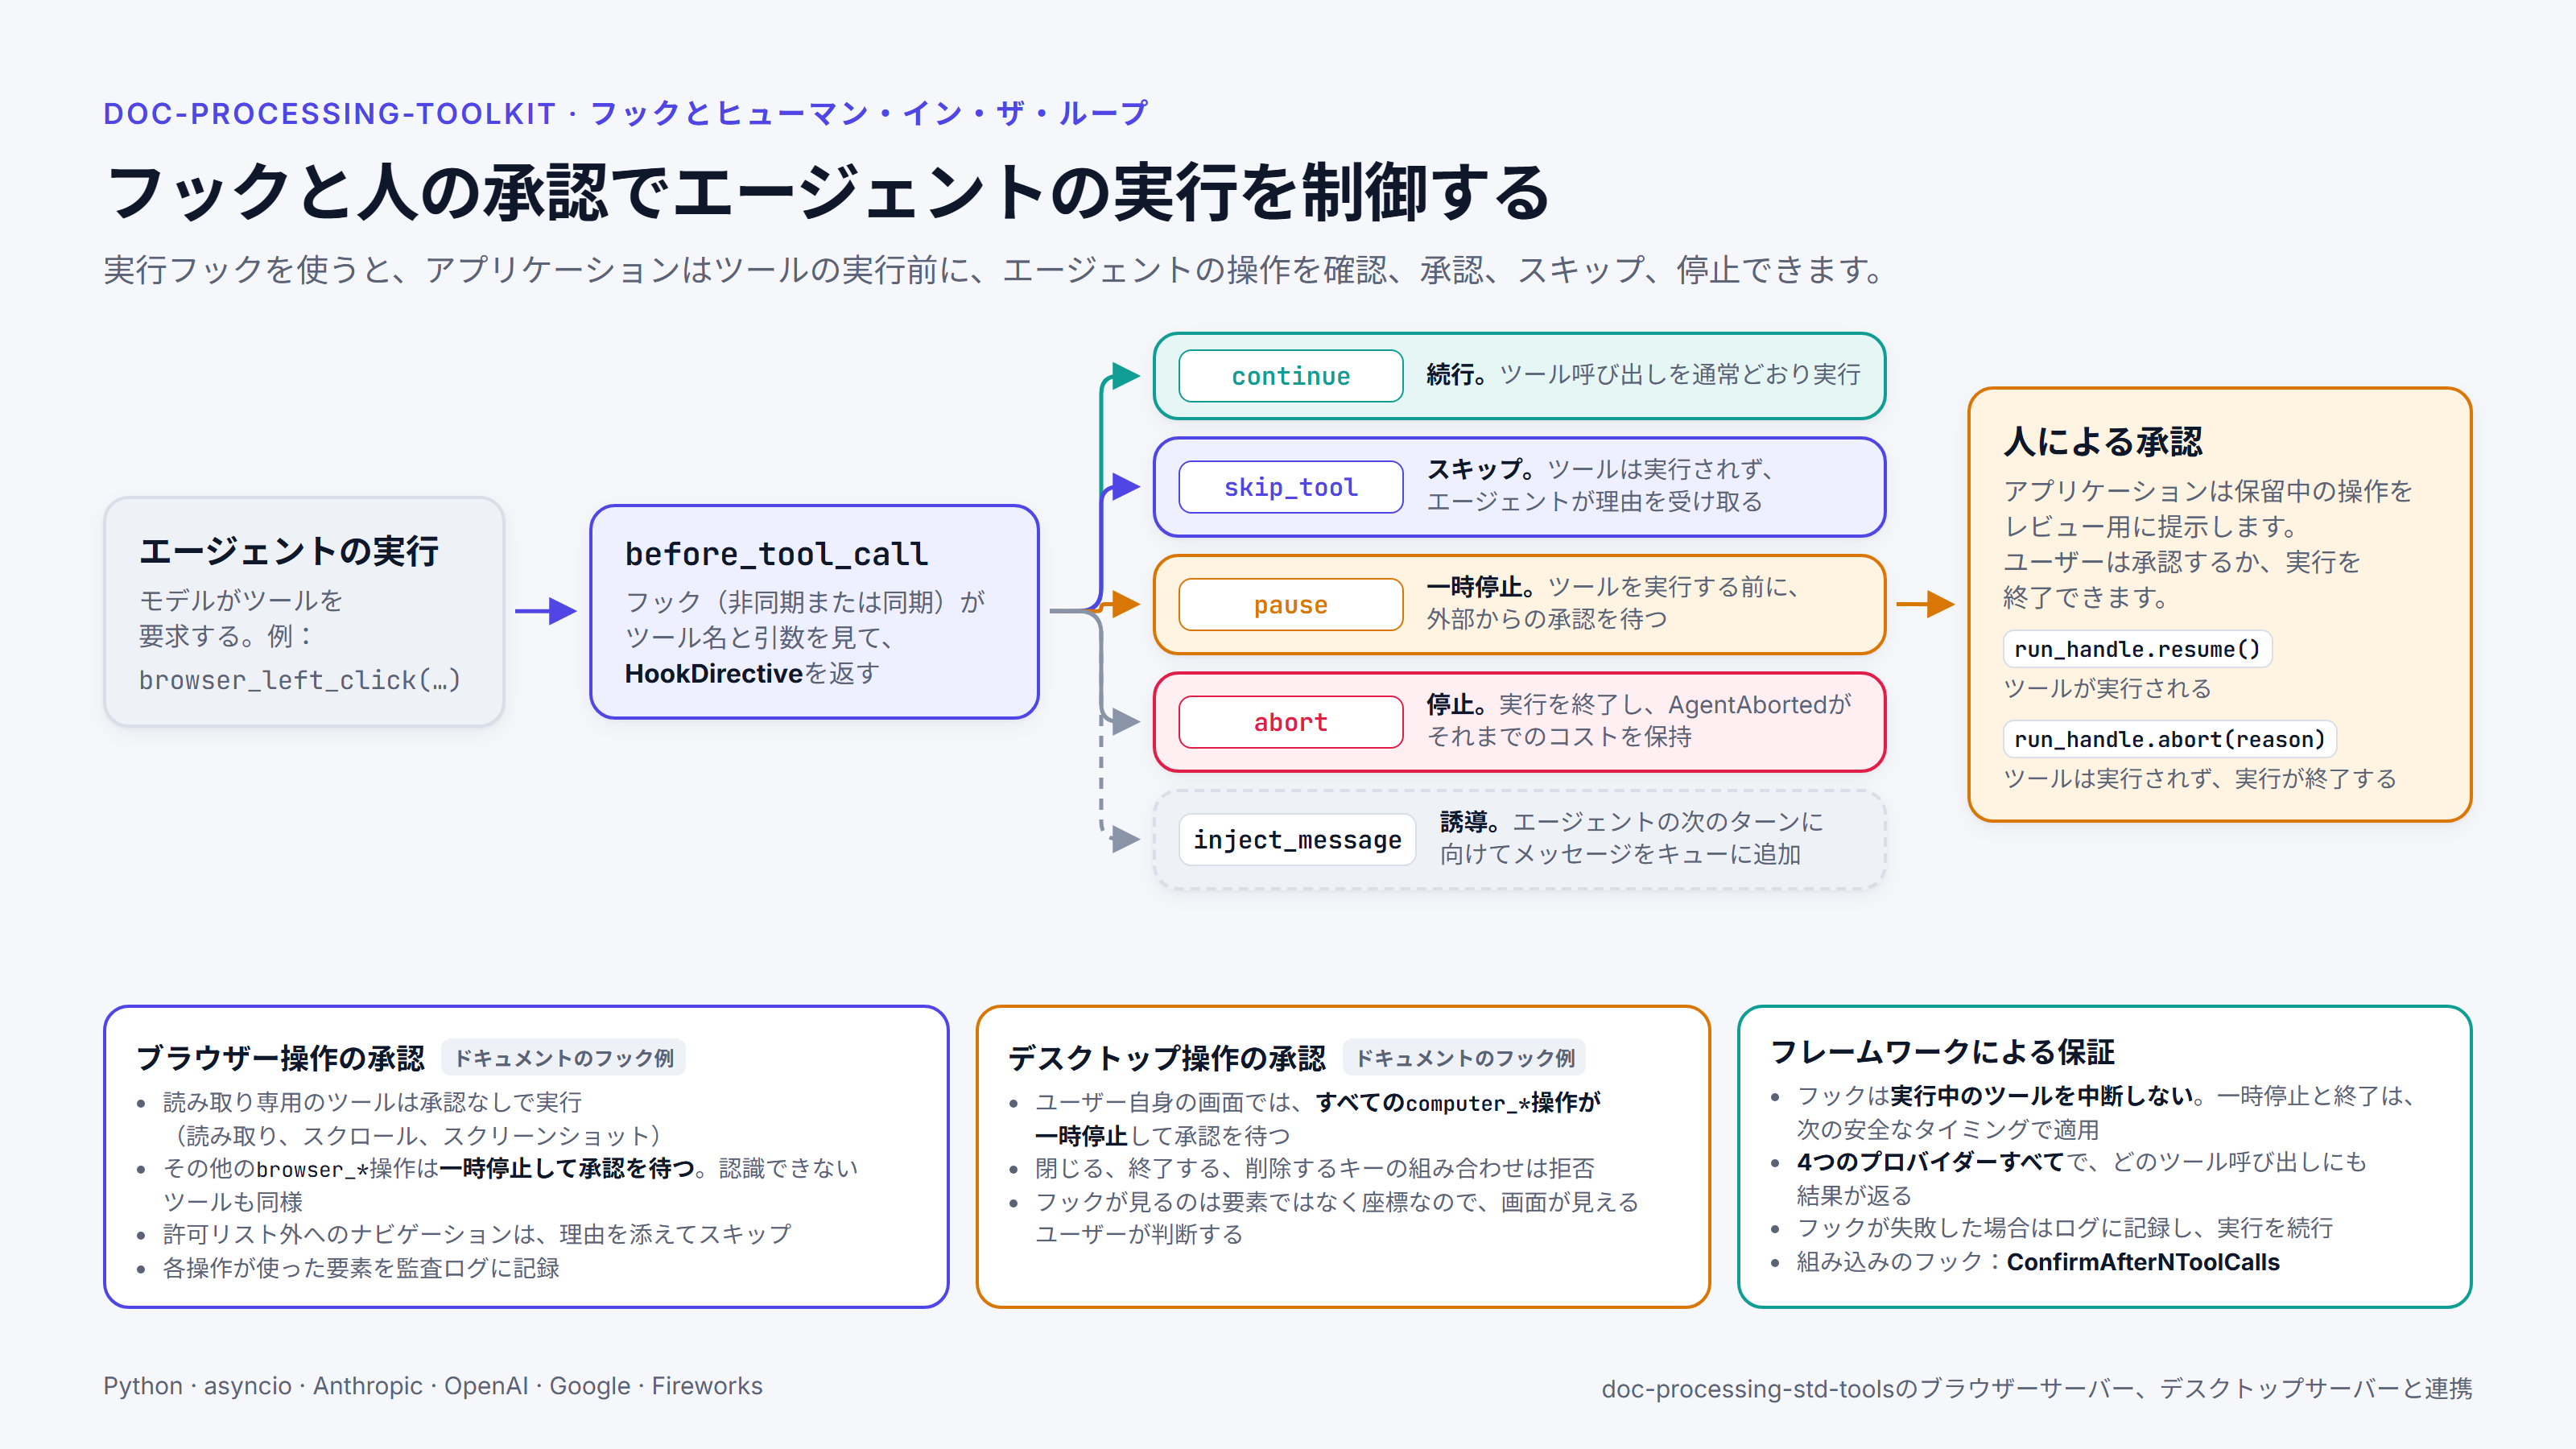
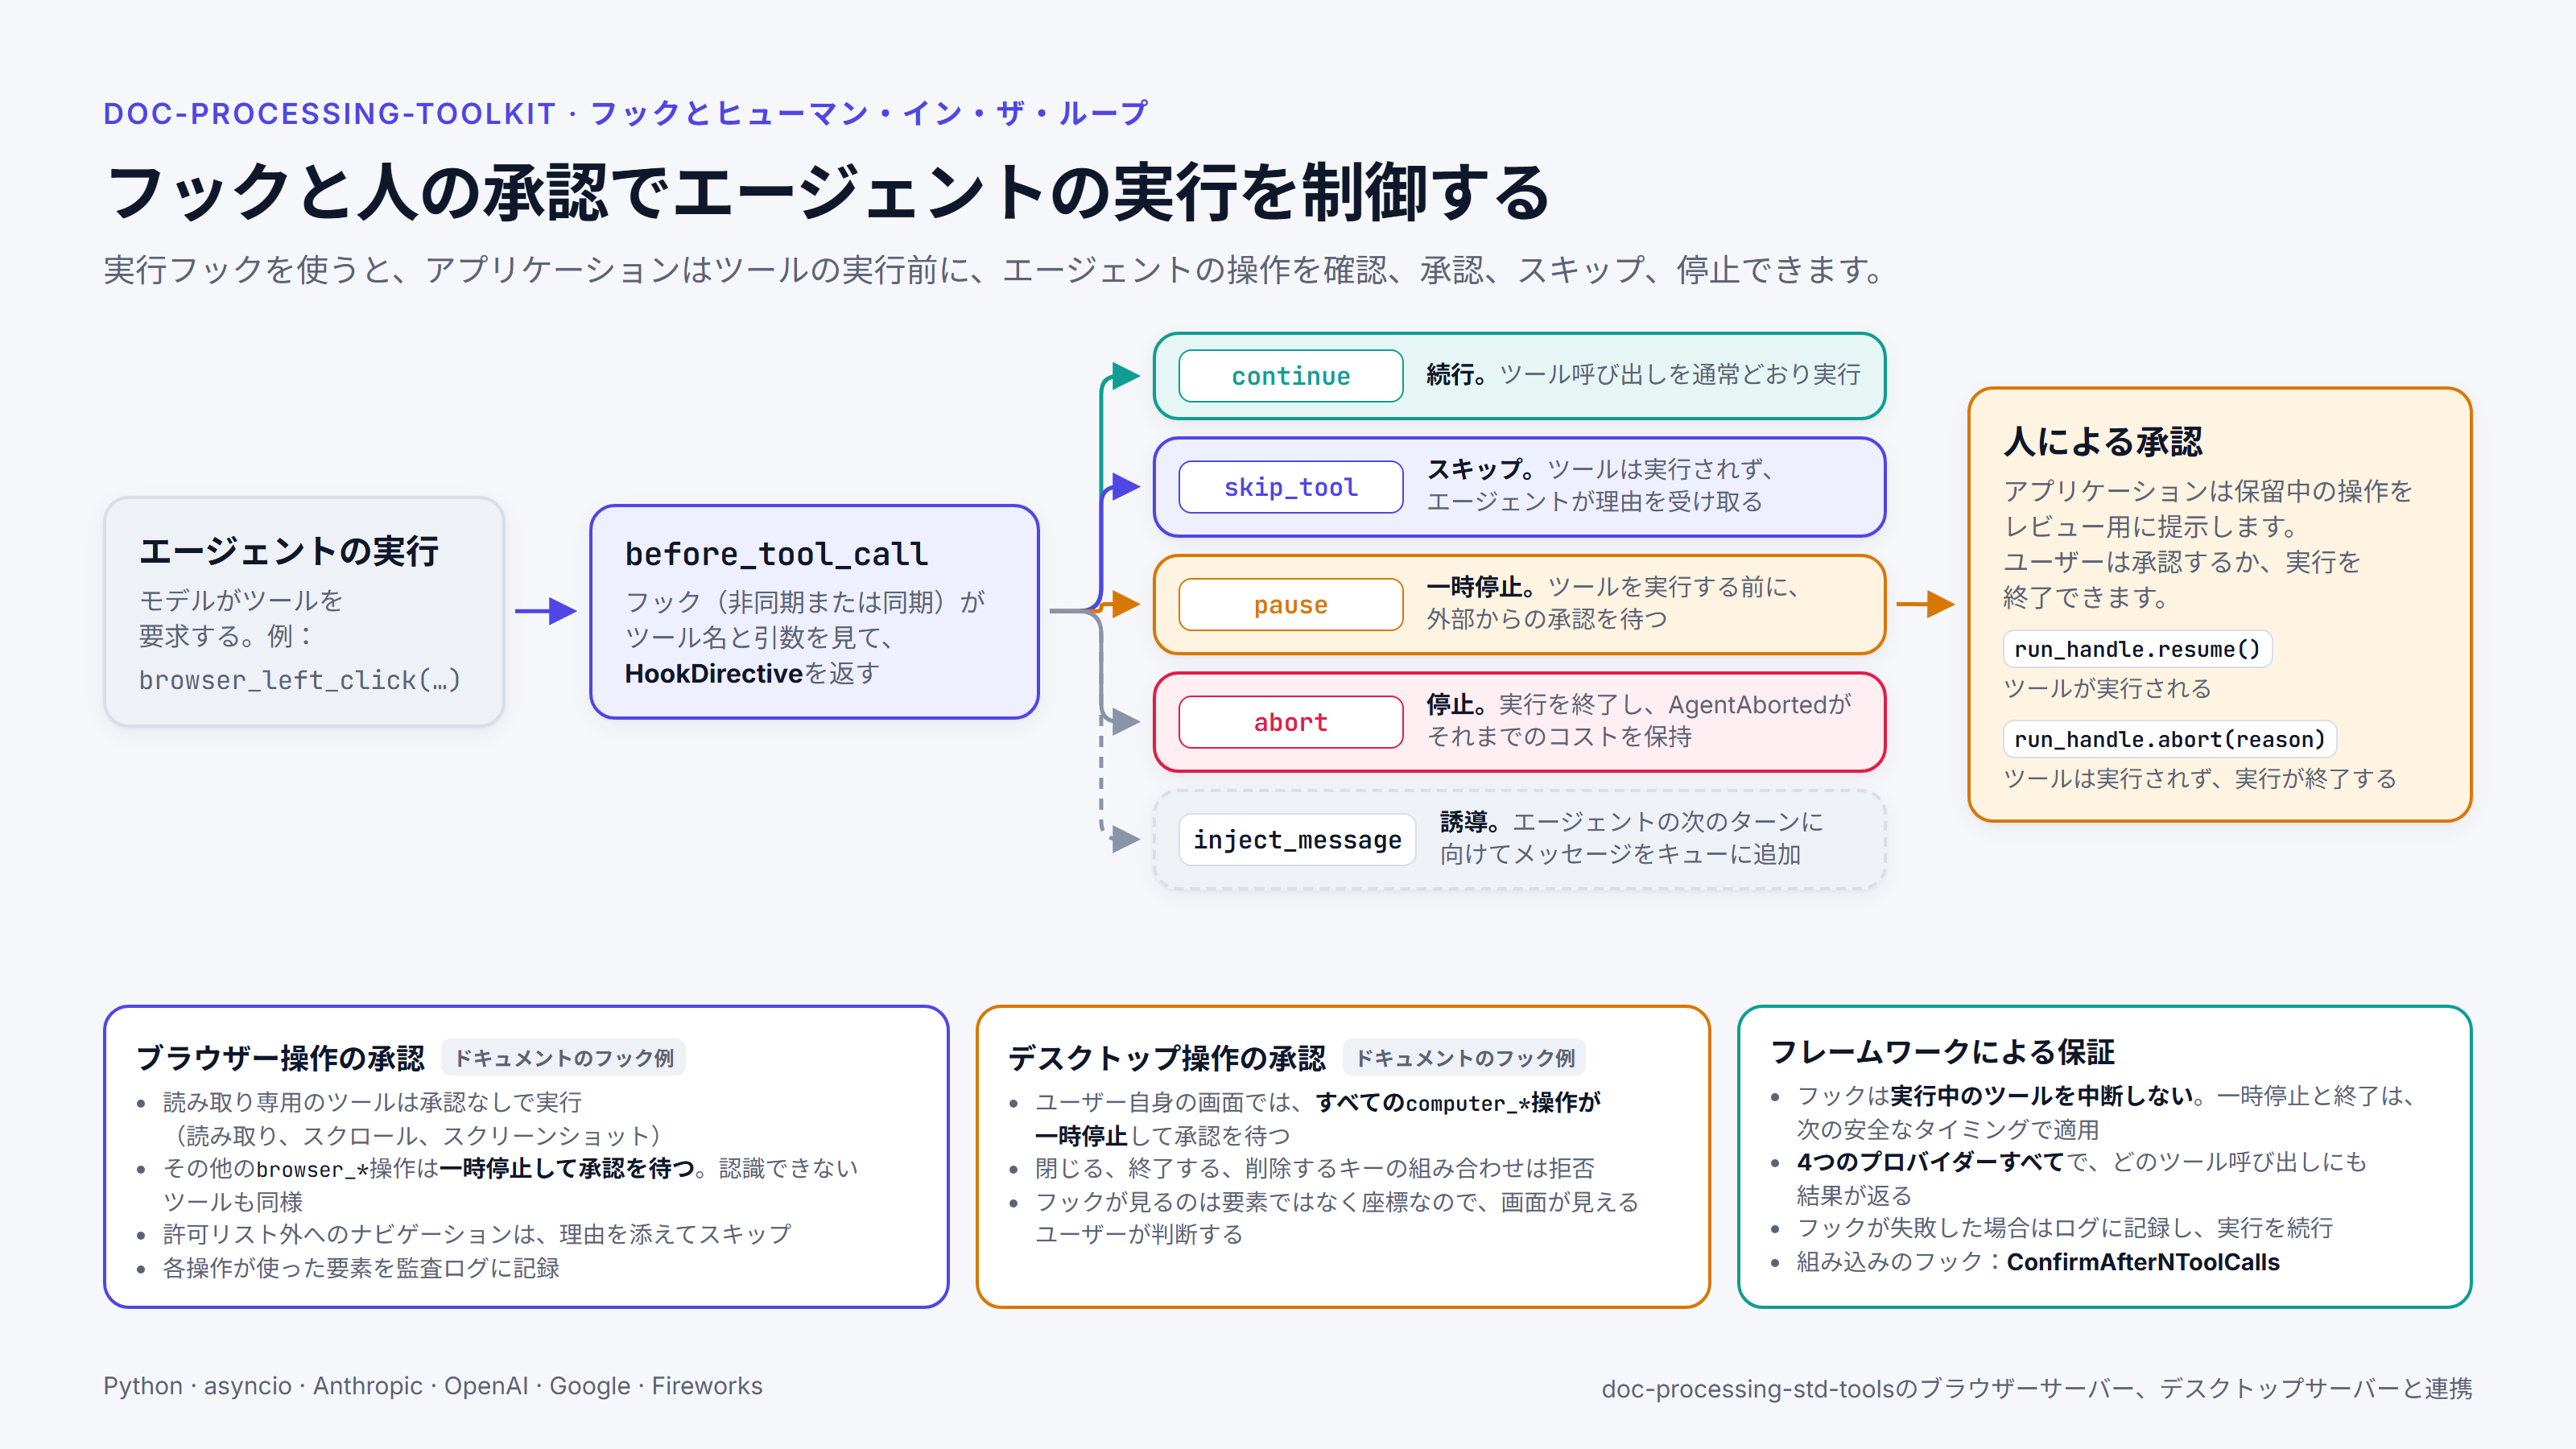
実行フックは、ツールを呼び出す前に毎回動きます。フックでは、呼び出しをそのまま実行する、モデルが読める理由を添えてスキップする、人の承認を待って一時停止する、実行を終了する、エージェントの次のターンに向けてメッセージをキューに入れる、のいずれかができます。ドキュメントには、ブラウザーやデスクトップを操作するエージェント向けの承認フックの例を載せており、アプリケーションは自らの方針に合わせてこれを調整できます。ブラウザー用の例では、フックが認識できない操作はすべて、人が承認するまで待機します。
コスト追跡
コスト追跡は、最初からtoolkitに組み込みました。toolkitは、プロンプトキャッシュ、サービスティア、リトライ、拒否応答まで含めて、リクエストごとのコストを記録します。トークンの数え方は、プロバイダーによって少しずつ異なります。たとえばGeminiは、thinkingトークン(モデルが回答する前の推論に使うトークン)を別に報告するため、コストを計算する前に出力トークンに加える必要があります。一方、OpenAIとAnthropicは、すでに出力トークン数にこれを含めています。自分のコストログを請求額と突き合わせるのが難しいのは、こうした小さな違いがあるためです。
2026年4月、ある本番ジョブについて、プロバイダーの請求額が私のコストログの金額の約6倍になりました。調査の結果、長時間の実行中にタイムアウトし、その後リトライされたリクエストが原因と見られました。請求額からは、それらの試行が課金されていたことがうかがえましたが、利用データが残っていなかったため、ログには記録されていませんでした。この件から生まれた主な変更は、ストリーミングです。4つのプロバイダーすべてをストリーミングに切り替えたので、途中で失敗したり止まったりしたリクエストでも、たいていは利用データが残ってコストが記録され、長いリクエストがアイドルタイムアウトに引っかかる可能性も低くなりました。また、明示的なタイムアウトを設定し、失敗した試行のコストも記録するようにしました。その後の数か月で、コスト計算のさらなる抜けを見つけて修正しました。コストを推定せざるを得ない場合、toolkitはその数字が推定値であることを明示します。
詳しい経緯は『6倍の乖離:LLMのコストログを請求額と突き合わせる』に書きました。
活用先
toolkitは、私が日本の顧客企業向けに設計・構築した日英バイリンガルAIドキュメントプラットフォームのエージェントランタイムです。このプラットフォームは、2026年6月から本番運用されています。2025年に構築したリサーチエージェントは、toolkitの初期の、プロジェクト専用のバージョンの上で動いていました。
また、MCPツールサーバーをまとめた私の別のライブラリ、doc-processing-std-toolsとともに、共同開発者と開発中のパーソナルAIプラットフォームの出発点にもなっています。このプラットフォームは、より長いタスクをこなし、小さなアプリを作るエージェントのためのもので、仮称はAI App Builderです。
開発の進め方
toolkitの各部分は、仕様書から始まります。アーキテクチャと全体設計の最初の草案は自分で書き、それをAIと一緒に繰り返し練り直して、Markdownの最終的な仕様書に仕上げます。テストと実装は、この仕様書に従います。現時点では、これが作業の中で最も時間のかかる部分です。変更のレビューと、何をリリースするかの判断も私が行います。実装、テスト、レビューの多くには、コーディングエージェントを使っています。実装の大部分はClaude Codeが担い、OpenAI Codexは主に批判的なレビュアーとして働き、GitHub Copilotがプルリクエストをレビューします。重要な変更は、受け入れ基準を記した計画書から始めます。そして可能な場合は、コードを書く前にその基準をテストにします。
ゴールデンファイルには、toolkitがプロバイダーに送るリクエストのコピーが保存されており、モデルが受け取る内容に意図しない変更があれば検出できます。v0.5.4時点でゴールデンファイルは112個あり、記録されたリクエストボディは1,000件を超えます。リリース前には、オフラインのユニットテスト(v0.5.4時点で9,834件)、ライブの統合テストとエンドツーエンドテストのスイート、そして支出上限を設けたうえでの実際のモデルに対するライブチェックに合格する必要があります。この手法については『仕様ファースト、テストファースト:AIコーディングエージェントでAIシステムを構築する方法』に書きました。
簡単な例
公開しているクイックスタートにある、ツールの例です。
from doc_processing_toolkit import Agent, tool

@tool
def add(a: int, b: int) -> int:
    return a + b

agent = Agent(
    model="gpt-6-luna",
    instructions="Use tools when needed.",
    tools=[add],
)

result = agent.run_sync("Add 7 and 8")
print(result.output)@toolデコレーターは、普通のPython関数を、モデルが呼び出せるツールに変えます。同じエージェントを別のプロバイダーで動かす場合、通常はモデル名を変えるだけです。ウォークスルーやライブデモをご希望の場合は、お問い合わせください。
プロジェクトのその他の画像