開発ログ
6倍の乖離:LLMのコストログを請求額と突き合わせる
タイムアウトしたリクエストとリトライの費用がLLMのリクエストログから漏れていた経緯と、コストをより正確に追跡するために行った変更をまとめます。
 執筆 ロナク・ゾエブ
公開 更新 約15分で読めます
2026年4月上旬、顧客向けのドキュメント処理ジョブを確認していたところ、プロバイダーの請求額が、私のアプリケーションのコストログの約6倍になっていることに気づきました。調べていくと、タイムアウトしてリトライされたリクエストが原因として浮かび上がりました。コストの計上を正すには、リクエストパイプラインのいくつかの部分にまたがる変更が必要でした。
これが問題だったのは、このコストログを、作業の見積もり、予算の設定、そして顧客にジョブの費用を伝えるために使っているからです。
ジョブの概要
このジョブは、長い技術文書を1リクエストにつき1ページずつ翻訳するものでした。OpenAIのGPT-5.4 miniを使い、一時期はモデルの推論レベル (reasoning effort) を最高のxhighに設定して実行していたため、各ページで大きなプロンプトを送信し、その後長時間の推論が走りました。今振り返ると、そもそもこのタスクにとって、その設定は適切な選択ではなかったのかもしれません。
リクエストは、私が設計・構築・保守しているPython製のAIエージェントフレームワーク、doc-processing-toolkitを経由していました。ツールキットは各リクエストを、tenacityライブラリのリトライデコレーターでラップしていました。試行は5回までで、指数バックオフ付きです。リクエストが成功すると、ツールキットはレスポンスのusageブロックをもとに、モデルレジストリの料金(各プロバイダーが公開している料金に基づくもの)でコストを算出し、ジョブのファイルに書き込みます。
ログと請求額の突き合わせ
突き合わせでは、プロバイダーの請求額を基準とし、ログのほうを検証の対象として扱いました。とはいえ、請求額にも限界がありました。プロバイダーのusage APIは、使用量をリクエスト単位ではなく、モデル別の時間バケット単位で返します。そのため、ある日にいくらかかったかはわかっても、どのページが原因かはわかりません。ジョブ自体のログのほうが粒度が細かかったので、このAPIのために管理者用キーを設定するのは見送りました。
ログからは、すぐにパターンが見えてきました。ページを追うごとに、APITimeoutErrorが出てはリトライが走っています。あるページでは、1回目の試行が約30分実行されたあとタイムアウトし、続く4回も同じ結果になって、そのページは失敗しました。同じパターンが多くのページで繰り返されていました。
こうしたタイムアウトとリトライ、そして請求額の合計は、私が実際に確認したものです。両者のつながりは推論です。タイムアウトした各試行では、モデルはプロンプト全体を読み込んだはずで、接続が切れるまで最大30分にわたって推論していた可能性もあります。その処理は課金されたと考えられます。一方、ツールキットはレスポンスを一度も受け取らなかったため、料金を計算するためのusageブロックがなく、何も記録しませんでした。その後tenacityがリトライし、その試行もまた記録されませんでした。請求額はモデル別・時間バケット別の合計しか示さないため、個々の試行にいくらかかったかを請求額から確かめることはできません。
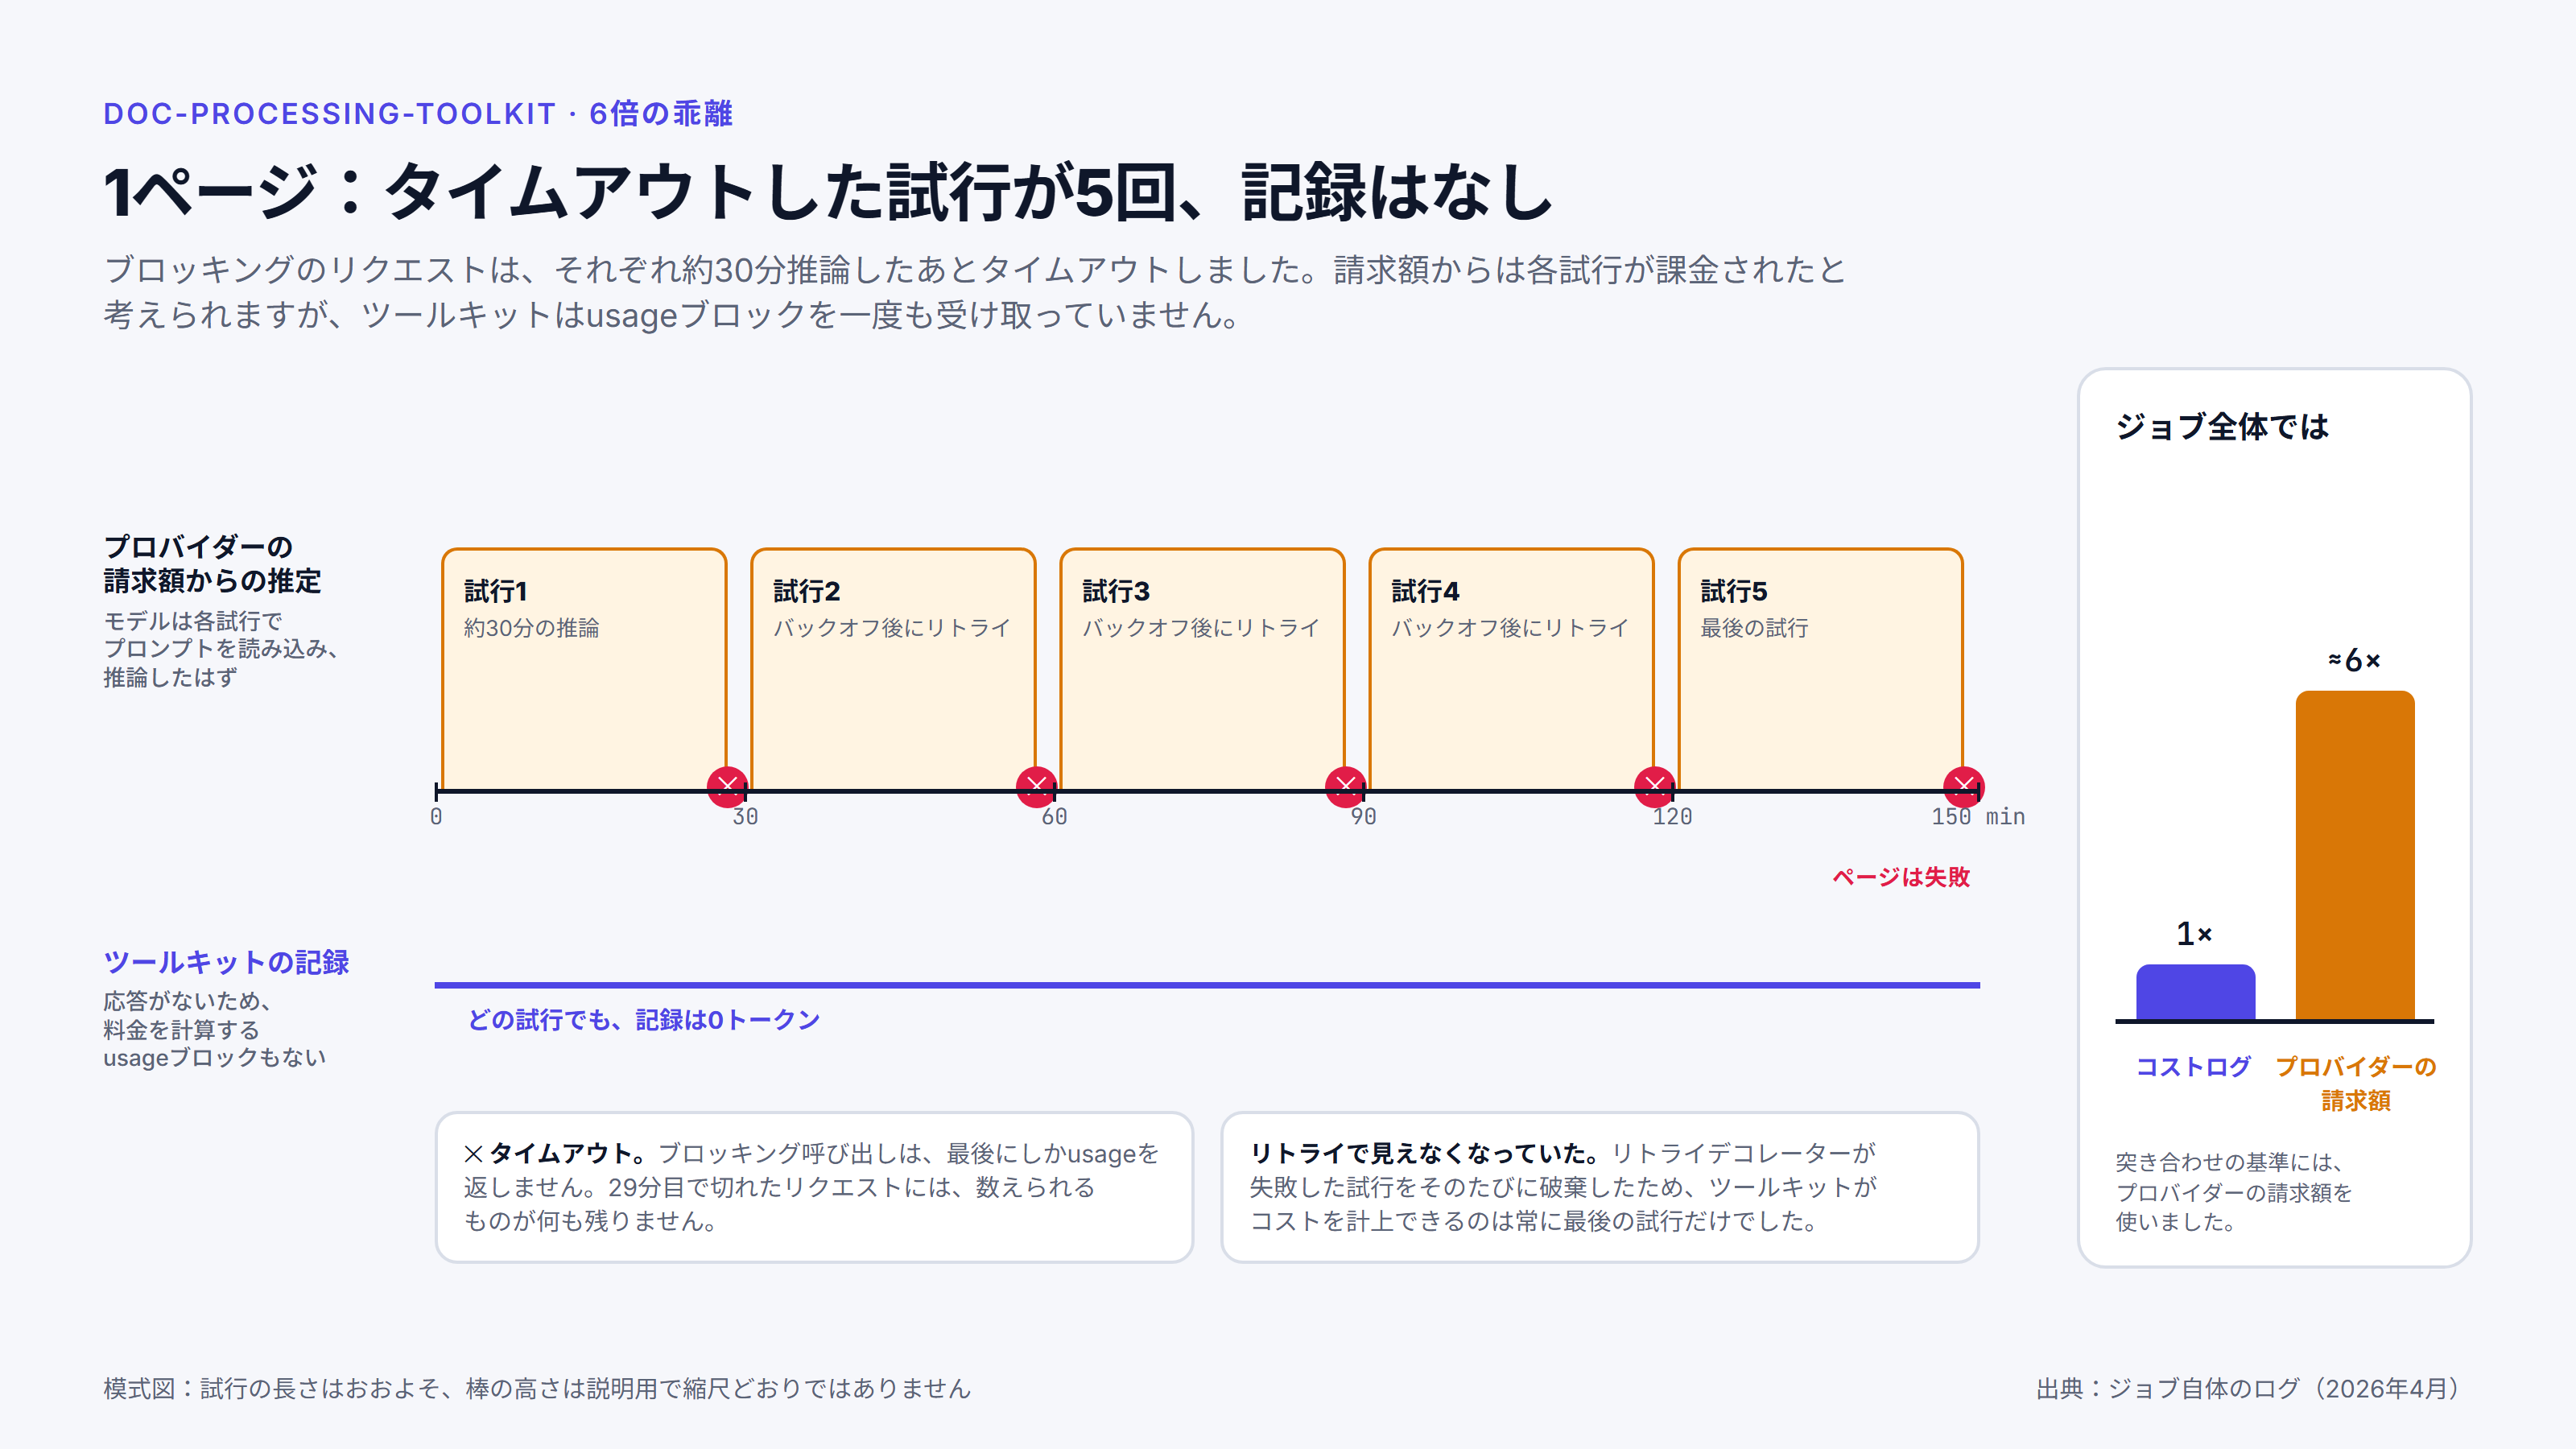
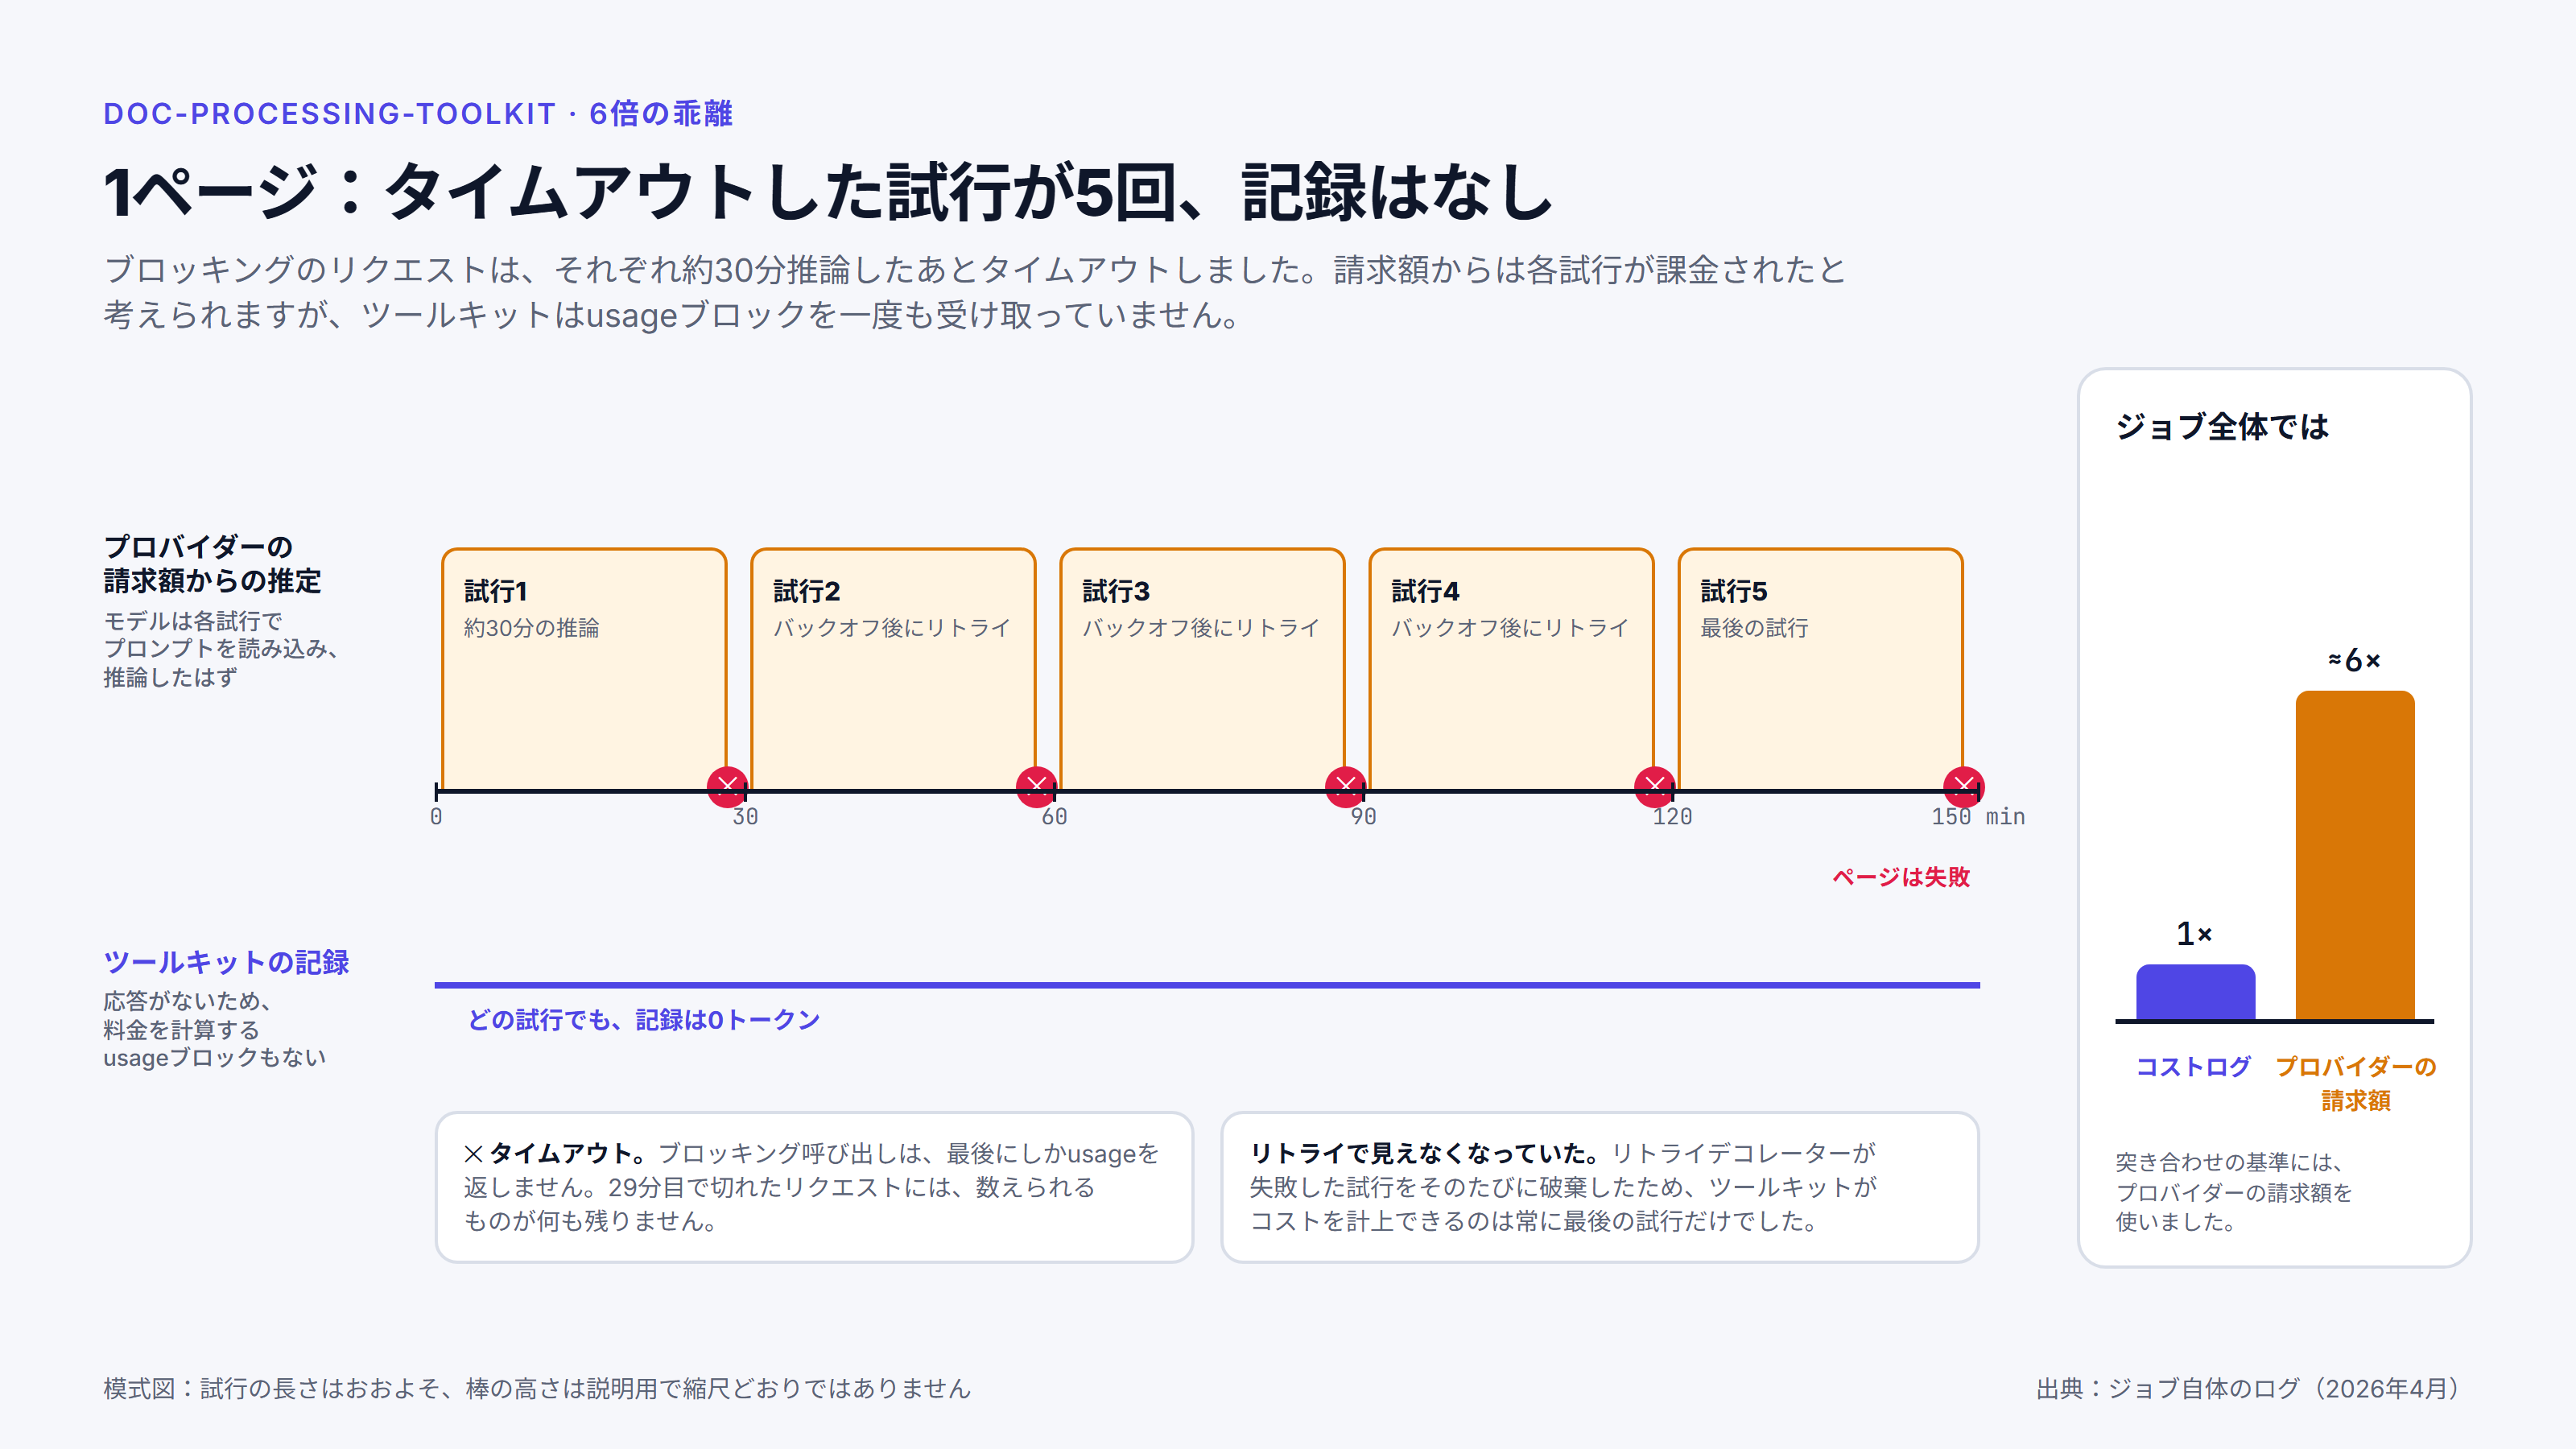
このジョブのために、既存の記録をバックアップしたうえで修正する、使い捨ての突き合わせスクリプトを書きました。スクリプトは各ページのタイムアウト回数を数え、説明のつかない残額(請求額からログの額を引いたもの)をそれらに均等に配分します。トークン数の推定には、コストの3分の1が入力、3分の2が出力という仮定の比率を使い、新しい数値には推定値であることを示す印を付けました。
補正後の数値は今も概算です。より重要だったのは、今後のジョブでこうしたスクリプトが必要にならないよう、ツールキットを変えることでした。
乖離の原因
ツールキットにあった3つの問題が重なっていました。
- リクエストがブロッキング呼び出しでした。OpenAI、Google、Fireworksの呼び出しはストリーミングしておらず、Anthropicも一部のコードパスではストリーミングしていたものの、すべてではありませんでした。ブロッキング呼び出しでは、レスポンスとusageブロックは最後にまとめて届くか、まったく届かないかのどちらかです。そのため、29分目で切れたリクエストには、数えられるものが何も残りませんでした。
- リトライが記録されていませんでした。リトライデコレーターは失敗した試行をそのたびに破棄していたため、ツールキットがコストを計上できるのは常に最後の試行だけでした。
- 長時間の推論が、30分のタイムアウトに何度も達していました。また、4つのプロバイダークライアントのうち3つでは、タイムアウトが明示的に設定されていませんでした。
4月に変えたこと
大きめの変更のときにいつもそうしているように、コードに手を付ける前に改善計画を書き、AIと一緒に何度か練り直しました(この進め方は『仕様ファースト、テストファースト』で書いています)。計画は3つの部分で構成されていました。
- 4つのプロバイダーすべてでのストリーミング。すべてのプロバイダー呼び出しが、内部でストリーミングするようになりました。
Agent.run()の呼び出し側には従来と同じ結果オブジェクトが返り、新たに追加したAgent.stream()でイベントを取得できます。チャンクを受信するたびにHTTPの読み取りタイマーがリセットされるので、アイドルタイムアウトが減ります。途中で失敗したストリームでも、それまでに届いたトークンは残ります。これは部分的な手がかりで、完全な使用量の報告にはなりません(最初のチャンクが届く前にリクエストがタイムアウトする可能性も残っています)。それでも、数えられるものが何も残らなかったブロッキング呼び出しに比べれば、はるかに良くなりました。 - クライアントのタイムアウトの明示的な設定。ストリーミングに加えるセーフティネットとして、読み取りタイムアウトを2時間にしました。
- リトライコストの計上。
RetryAccumulatorがtenacityのbefore_sleepコールバックにフックし、失敗した各試行を記録します。記録するのは、トークン数、コスト、トークン数の出どころ(token_source)、エラー、所要時間です。実行のcostにはそれらの試行が含まれ、retry_countとretry_costを見れば、合計のうちどれだけがリトライによるものかがわかります。
計画では、コードを書く前にいくつかの判断も確定させました。ストリーミングは常に有効とし、無効化するフラグは設けません。全体を切り替えるスイッチより、1つのプロバイダーに絞った修正のほうが保守しやすいからです。コストアラートはクライアントアプリケーション側に任せました。クライアントアプリケーションは、ストリームのイテレーションごとのコストイベントを監視して、早めに処理を止められます。
計画では、失敗した試行についてのツールキットの計上ポリシーも定めました。後から追加した「ストリーム開始前の拒否」のルールも含めると、次のとおりです。
# The toolkit's accounting policy for a failed attempt: (input tokens, output tokens) to bill.
def bill_failed_attempt(error, partial_output_tokens, input_estimate):
    if rejected_before_stream(error):   # an HTTP error response, or no connection was made
        return 0, 0                     # assumed not billed
    if partial_output_tokens > 0:       # generation had started
        return input_estimate, partial_output_tokens
    if is_billable_error(error):        # e.g. a timeout before any chunk arrived
        return input_estimate, 0        # assume the prompt was read and billed
    return 0, 0
これらはプロバイダーの課金方法についての仮定であり、特定のプロバイダーが実際にいくら請求したかを証明するものではありません。HTTPのエラーレスポンスで拒否されたリクエストや、一度も接続できなかったリクエストは、コストがかからないものと仮定します。開始済みのストリームには、推定入力分に、届いた出力トークン分を加えたコストを計上します。最初のチャンクが届く前のタイムアウトのように、ツールキットが課金対象とみなすエラーには、推定入力分だけを計上します。推定値をもとにした数値には、後述するとおり、推定値であることを示すフラグを付けます。
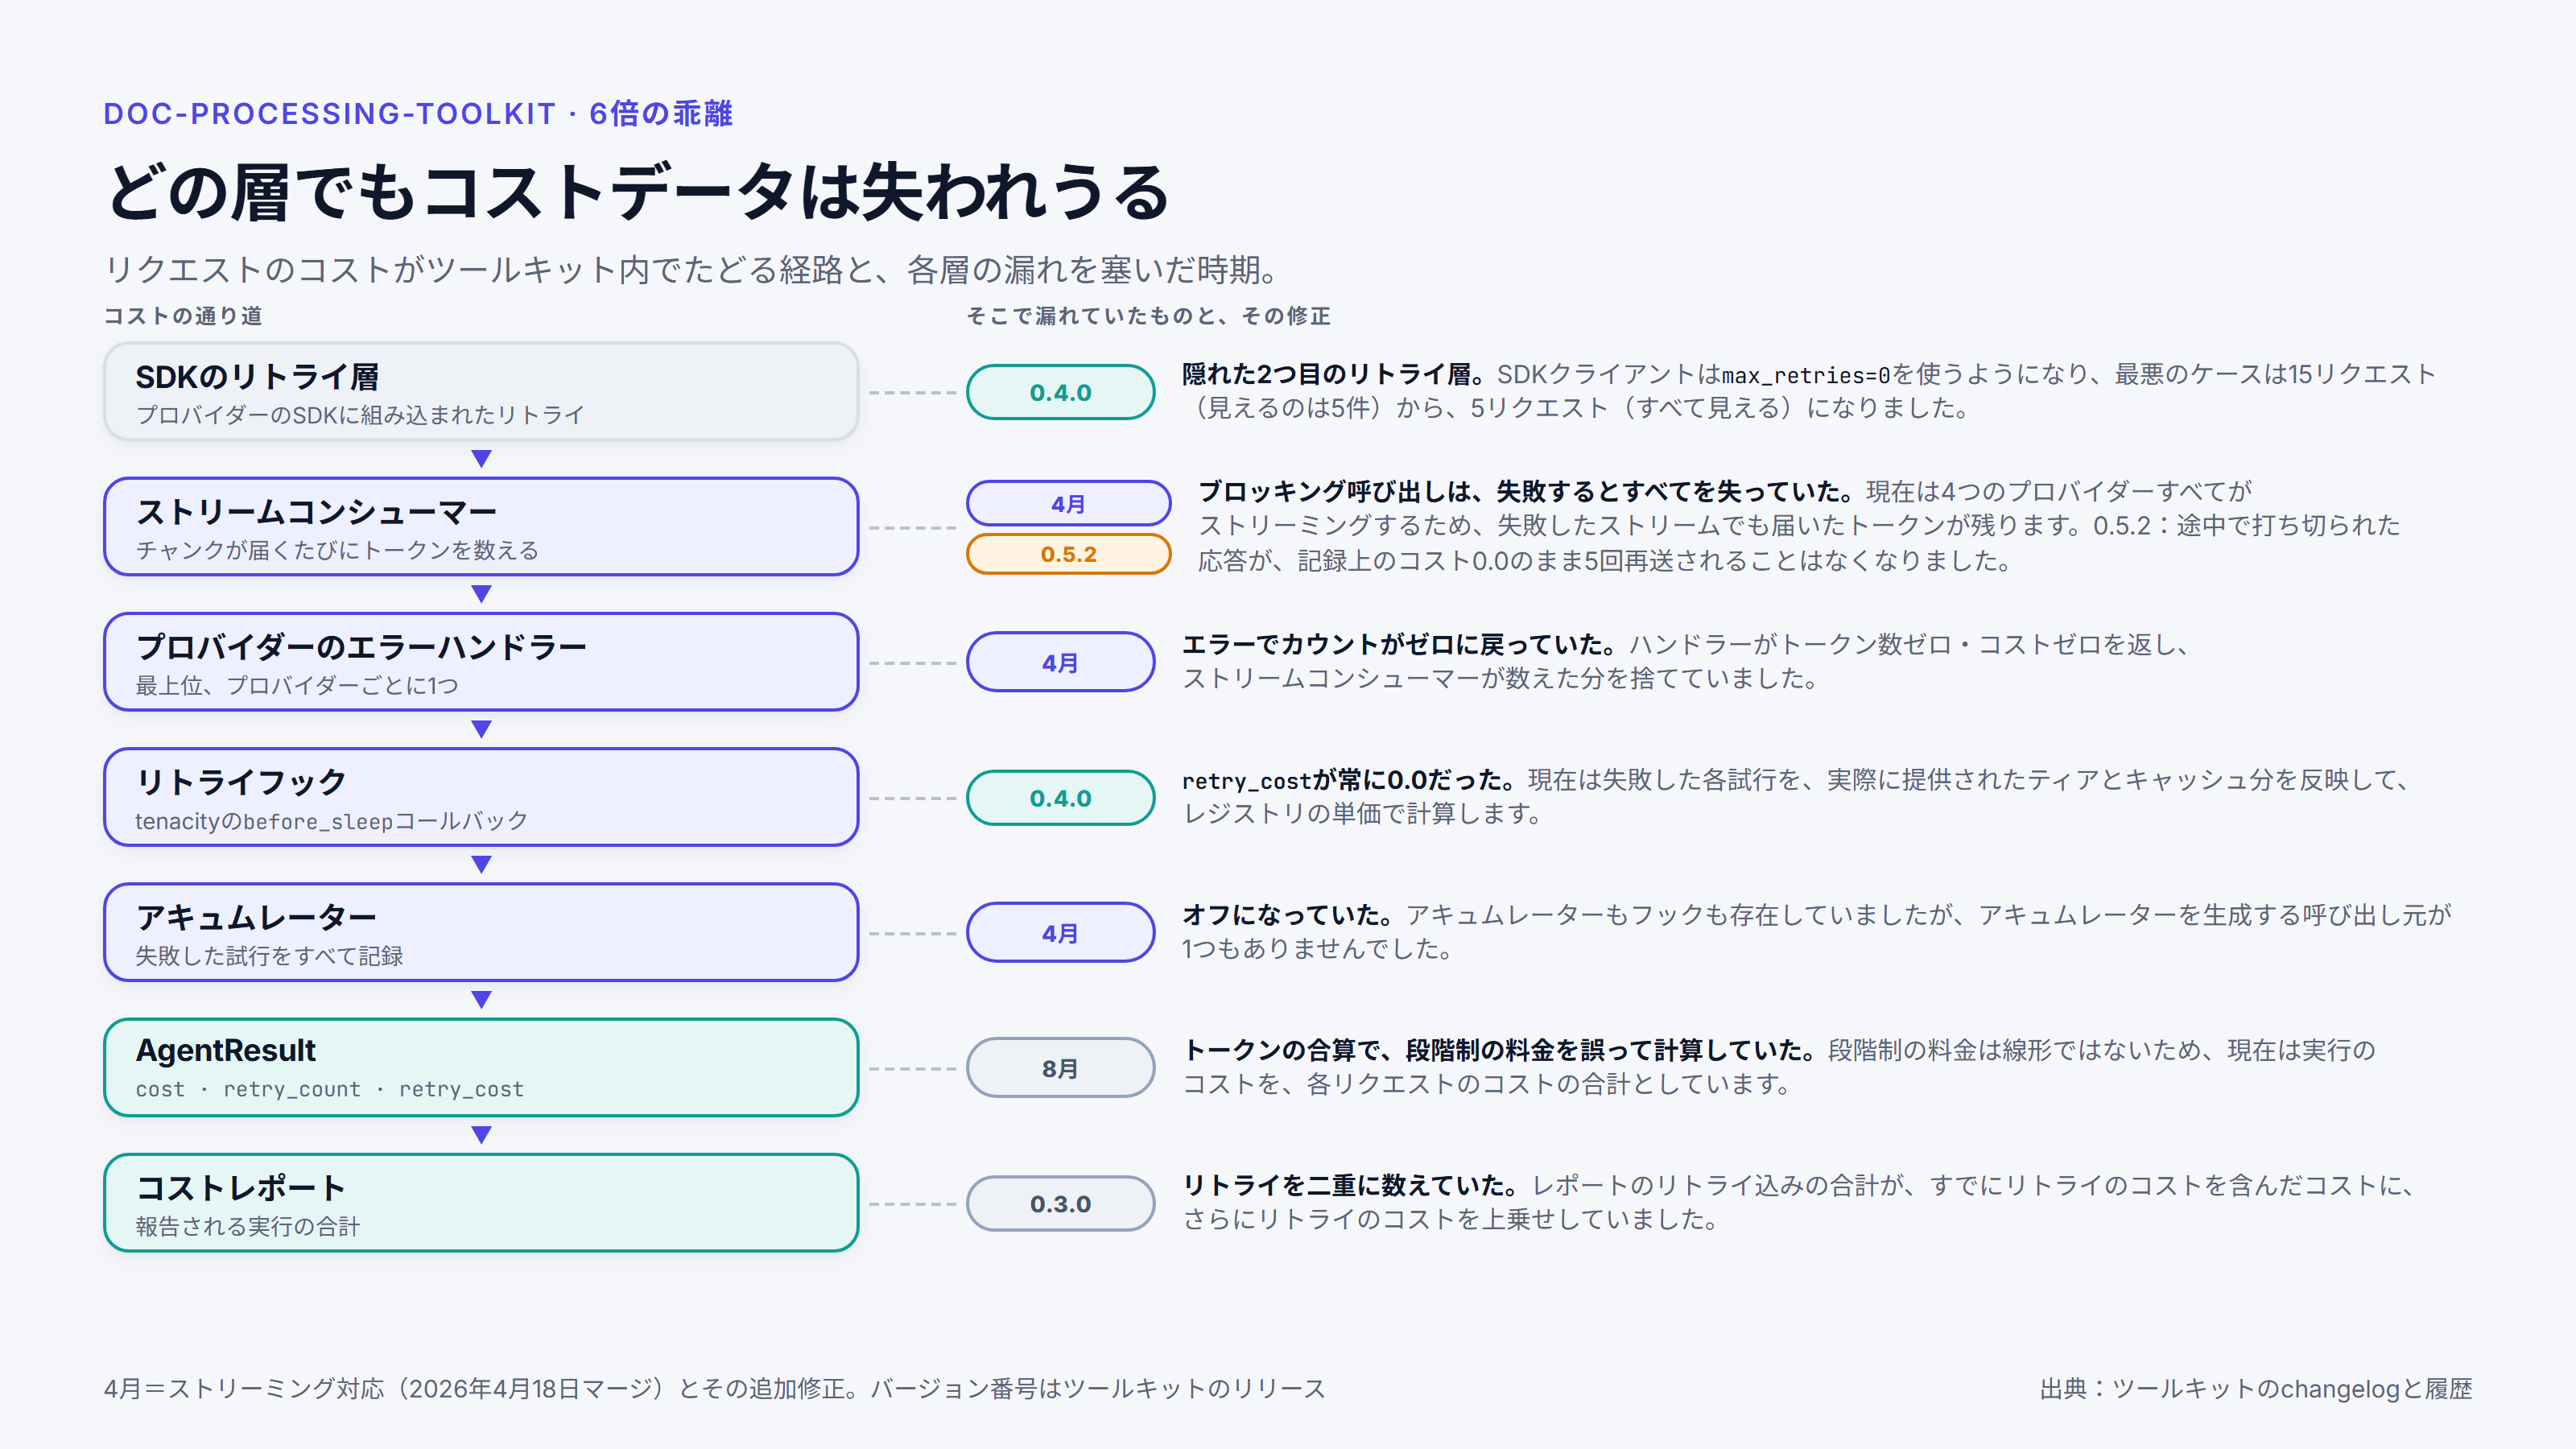
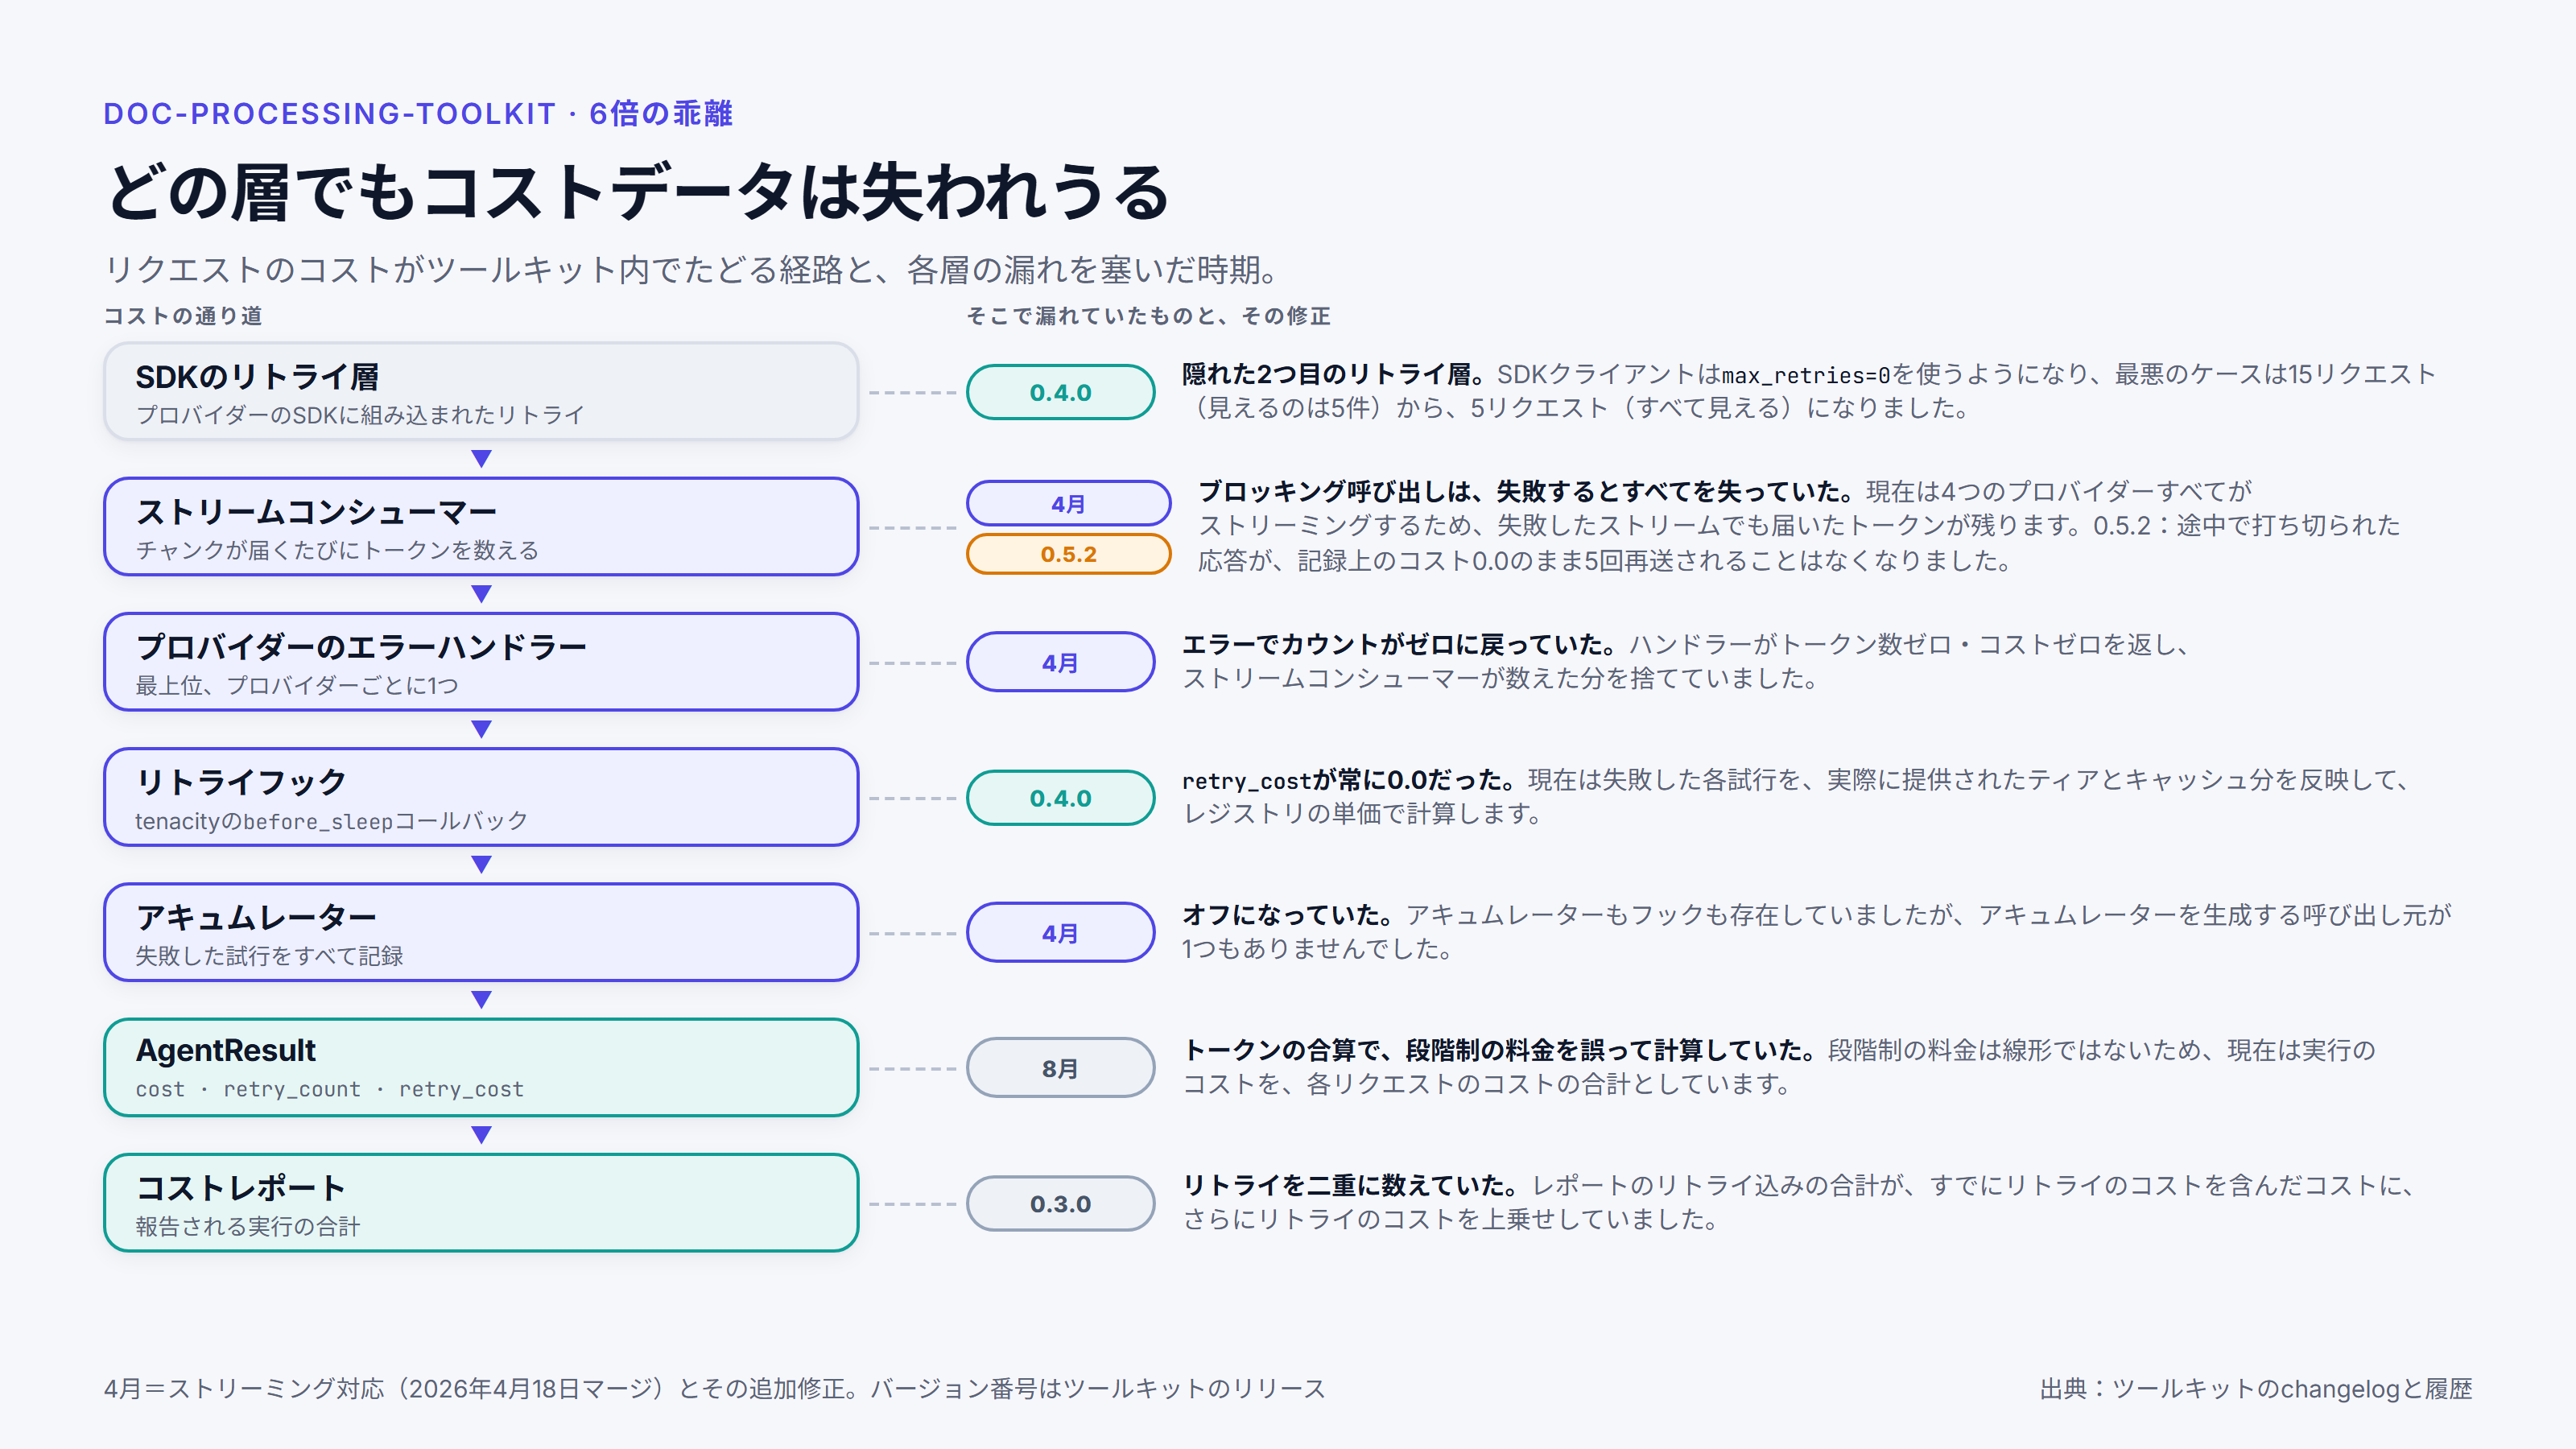
ストリーミングのブランチは4月18日にマージされました。それに先立つ第1フェーズでは、実装コードより先に受け入れ基準とプレースホルダーテストを書いています。その後1週間以内に、2つの追加修正が続きました。マージの5日後、各プロバイダーの最上位のエラーハンドラーがトークン数ゼロ・コストゼロを返しており、ストリームのコンシューマーが数えた分をすべて捨ててしまっていることに気づきました。約4分で途中終了したClaudeのストリームは、Anthropicからは課金されていたのに、ツールキットでは無料として記録されていました。2つの修正のうち1つ目では、エラーハンドラーが、ストリームのコンシューマーが数えた分を返すようにしました。その翌日には、アキュムレーターもフックも存在し、すべてのプロバイダー関数がアキュムレーターを受け取れるようになっていたにもかかわらず、それを生成する呼び出し元が1つもないことがわかりました。リトライの計上は事実上オフになっており、costは依然として成功した試行しかカバーしていませんでした。
当初の6倍の食い違いに関係するのは、これら4月の変更、つまりストリーミング対応とその2つの追加修正です。
その後見つかった計上の不具合
8月から10月にかけて、ツールキットのコストの記録方法に、さらに不具合が見つかりました。いずれも実際の誤りでしたが、4月の乖離の一因であることが示されたものはありません。3つのグループに分けられます。
ツールキットが見ていなかった、または数えていなかった試行
OpenAIとAnthropicのSDKは、デフォルトで失敗したリクエストを自らリトライします。これに気づいたのは、4月の作業から数か月後のことです。そのため、tenacityの5回の試行それぞれの裏に、最大2回のSDKリトライが隠れている可能性がありました。最悪の場合、リクエストは15回送られ、ツールキットに見えていたのはそのうち5回だけです。リリース0.4.0ではSDKクライアントをmax_retries=0で生成し、これまでSDKが処理していたステータスもtenacityでリトライするようにしました。最悪のケースは、15リクエストのうち5件しか見えない状態から、5リクエストすべてが見える状態になりました。
10月には、0.5.2で、4月の不具合が新たな形で現れたものを修正しました。途中で打ち切られたOpenAIの応答が変更なしのまま5回再送されて実行が失敗し、課金された5回のリクエストに対してcostは0.0となっていたのです。
失敗した試行の誤った料金計算
9月には、ドキュメントのレビューで、retry_costが常に0.0であることが判明しました。フックは失敗した試行ごとのトークン数を記録していましたが、コストは、途中で切れたストリームに対してどのプロバイダーもゼロを設定するフィールドからコピーしていました。リリース0.4.0では、各試行を、実際に提供されたティアとキャッシュ分を反映したうえでレジストリの単価で計算し、入力トークン数が送信前の推定値である場合は、推定値としてフラグを立てます。
同じリリースでは、逆方向の誤りも修正しました。何もストリーミングされないうちにプロバイダーが拒否したリクエストに、推定入力分のコストが計上されていたのです。現在はコストゼロとなり、rejected_before_streamのラベルが付きます。コストの過大報告もまた、計上のバグです。それ以前にも、リリース0.3.0で、リトライを二重に数えていたレポートの合計を修正していました。リトライのコストをすでに含んだコストに、さらにリトライのコストを上乗せしていたのです。
プロバイダーの課金と合っていなかった料金と使用量
8月には、ツールキットがリクエストごとにコストを記録するようにしました。現在、実行のコストは各リクエストのコストの合計です。段階制の料金は線形ではなく、トークンを合算すると、どの単独のリクエストも超えていない料金のしきい値を超えてしまうことがあるからです。その後の修正で、同じルールを失敗した試行にも適用しました。それまでは、完了済みの150kトークンと160kトークンの2つのリクエストを1つとして料金計算していたため、コストが2倍になっていました。
ほかの食い違いは細部にありました。ストリーミングで送ったGeminiのpriorityリクエストは、標準料金で計算され、ダウングレードされたとしてフラグが立てられていました。ツールキットが、ストリーミングのエンドポイントからは決して送られてこないヘッダーから、提供されたティアを読み取っていたためです。Anthropicのキャッシュ書き込みは、リクエストしたキャッシュの有効期間 (TTL) で料金計算されており、実際に適用されたTTLが反映されていませんでした。リリース0.5.2では、Claudeの拒否応答 (refusal) の扱いを、Anthropicの課金方法に合わせて変更しました。拒否のカテゴリーによって、課金されるものとされないものがあるからです。続く0.5.4では、これまで一度も計上されていなかった、Geminiの画像モデル呼び出しにおけるthinkingトークンの料金を計算するようにしました。リリース時の確認では、これが呼び出しコストの約8分の1を占めていました。
コスト追跡のテスト
この6か月(2026年4月〜10月)の間に、コスト追跡を、独自の仕様とテストを持つ1つの機能として扱うようになりました。
テストでは、プロバイダーが実際に返す形のデータを使う必要があります。Google関連のあるバグでは、ツールキットがトークン内訳のキーを、enumに対してstr()を呼び出して生成していました。その結果、料金計算関数が"AUDIO"を探しているところに"MediaModality.AUDIO"が生成されていたため、音声トークンが1つも見つからず、Googleのツール呼び出しを伴う実行では、音声入力がテキストの料金で計算されていました。その間ずっと、料金エンジン自体のテストはグリーンのままでした。テストが、プロバイダー側のコードが実際には生成しない手書きのキーで、料金エンジンを呼び出していたからです。
ゴールデンファイル(リクエストの固定比較)は、実際に送信される内容を固定します。ツールキットが何を送るかによって、プロバイダーが何に課金するかが決まります。サービスティア、キャッシュ制御、thinkingの設定です。ツールキットでは、リクエストボディのゴールデンファイルを100件以上管理しています。いずれも、実際のAgentセッションを、送信されるリクエストボディをそのまま記録するクライアントに対して実行して生成したもので、ネットワークは一切使いません。変わらないはずのボディをコミットが変更すると、テストが差分付きで失敗します。ゴールデンファイルを最新に保つ作業は継続的に必要です。プロバイダーは時間とともにAPIを変更するからです。定期的に更新する方法を検討しています。
網羅リスト (closed list) は、ツールキットを依存関係と足並みをそろえた状態に保ちます。あるテストでは、ツールキットが持つOpenAIのストリーム失敗コードの表を、SDK自身のリストと照合しています。SDKにコードが追加されると、そのコードをリトライするのか即座に失敗させるのかを誰かが判断するまで、このテストは失敗し続けます。
小規模なライブ検証では、フィクスチャでは確かめられない前提を確認します。2026年9月23日のある検証(gpt-5-nanoがgpt-image-2をホストする構成で、1024×1024、品質設定ごとに1回ずつ生成)では、OpenAIが公開している画像生成の品質別料金表が、ある品質設定では39%高すぎ、別の設定では40%低すぎました。現在ツールキットは、APIが報告する使用量 (usage) をもとにこれらの呼び出しの料金を計算しています。usageが報告されない場合に限って料金表にフォールバックし、そのときはコストを推定値としてフラグを立てます。
推定値は推定値として明示します。すべての実行で、token_source(api_response、stream_partial、rejected_before_stream、estimatedのいずれか)とcost_estimatedフラグを報告します。計上ポリシー上は課金されたとみなす試行なのに、ツールキットがその使用量を計測できなかった場合は、$0.00ではなく、フラグ付きの推定値を報告します。このフラグが示すのは数値が推定値だということだけで、どれだけずれている可能性があるかは示しません。そのため、請求額との突き合わせは今でも行う価値があります。突き合わせを定常的に行えるよう、より自動化したチェックを検討しています。現在のコストモデルについては、ツールキットのドキュメントで説明しています。
LLMのコスト追跡のためのチェックリスト
- コストログを、モデル別・日別に、定期的にプロバイダーの請求額と突き合わせましょう。請求額は合計しか示さない場合があるため、リクエスト単位の詳細は自分のログから得る必要があります。
- 成功したものだけでなく、すべての試行を記録しましょう。失敗したリクエストでも、モデルが何らかの処理をしていれば課金されることがあります。
- リトライ層の数を把握しましょう。SDK、HTTPクライアント、自分のコードのすべてがリトライしている可能性があります。リトライ層は1つに絞り、それを記録しましょう。
- 長い生成はストリーミングしましょう。ストリーミングするとアイドルタイムアウトが減り、ストリームが失敗しても部分的な使用量が残ります。ただし、完全な記録が保証されるわけではありません。
- リクエストごとに、実際に提供されたティアで料金を計算しましょう。合算したトークン数や、リクエストしたティアをもとに計算してはいけません。
- 推定値は推定値として明示し、コスト計算のコードは、プロバイダーが実際に返す形のデータでテストしましょう。データの形は変わるので、常に最新の状態に保ちましょう。