記事
仕様ファースト、テストファースト:AIコーディングエージェントでAIシステムを構築する方法
書面にした計画、回帰テスト、エージェントによるレビュー、実際のAPIに対する検証:コーディングエージェントを自分のプロジェクトにどう組み込んでいるか、そして何を自分の役割として残しているかを紹介します。
 執筆 ロナク・ゾエブ
公開 更新 約21分で読めます
現在のプロジェクトのほとんどで、コーディングエージェントを使っています。方向性を定め、アーキテクチャを判断するのは私です。何を作りたいのか、それが何をする必要があり、何をする必要がないのかを決めます。そのうえで作業を計画し、エージェントが実装している間はその舵取りをし、変更をレビューし、何をリリースするかを決めます。ここでは、これまでにたどり着いたワークフローを、今も私自身が注意を払う必要がある部分も含めて紹介します。
例の多くは、私が設計・構築・保守しているPython製のAIエージェントフレームワーク、doc-processing-toolkitから取っています。もともとはドキュメント処理エージェントのための基盤として始まり、現在はさまざまな種類のエージェントを構築するための汎用フレームワークになっています。Anthropic、OpenAI、Google、Fireworksのモデルを1つのインターフェースでアプリケーションに提供し、コスト追跡、MCPサーバーを通じたツールへの接続(MCP、つまりModel Context Protocolは、エージェントをツールに接続するための標準的な方法です)、長い会話をモデルの上限内に収めることなど、ほとんどのエージェントに必要な部分を担います。ドキュメントサイトは公開しています。そのほかの例は、主にツールキットで構築したエージェントにツールを提供するために設計したMCPサーバーのライブラリ、doc-processing-std-toolsと、日本語の単語カード(フラッシュカード)アプリから取っています。
実装には主にClaude Codeを、レビューと批評には主にOpenAI Codexを使っています。ただし、Codexもコードを一部書きます。プルリクエストは、GitHub Copilotのクラウドエージェントが2回目のレビューを行うことがよくあります。
リポジトリの整備
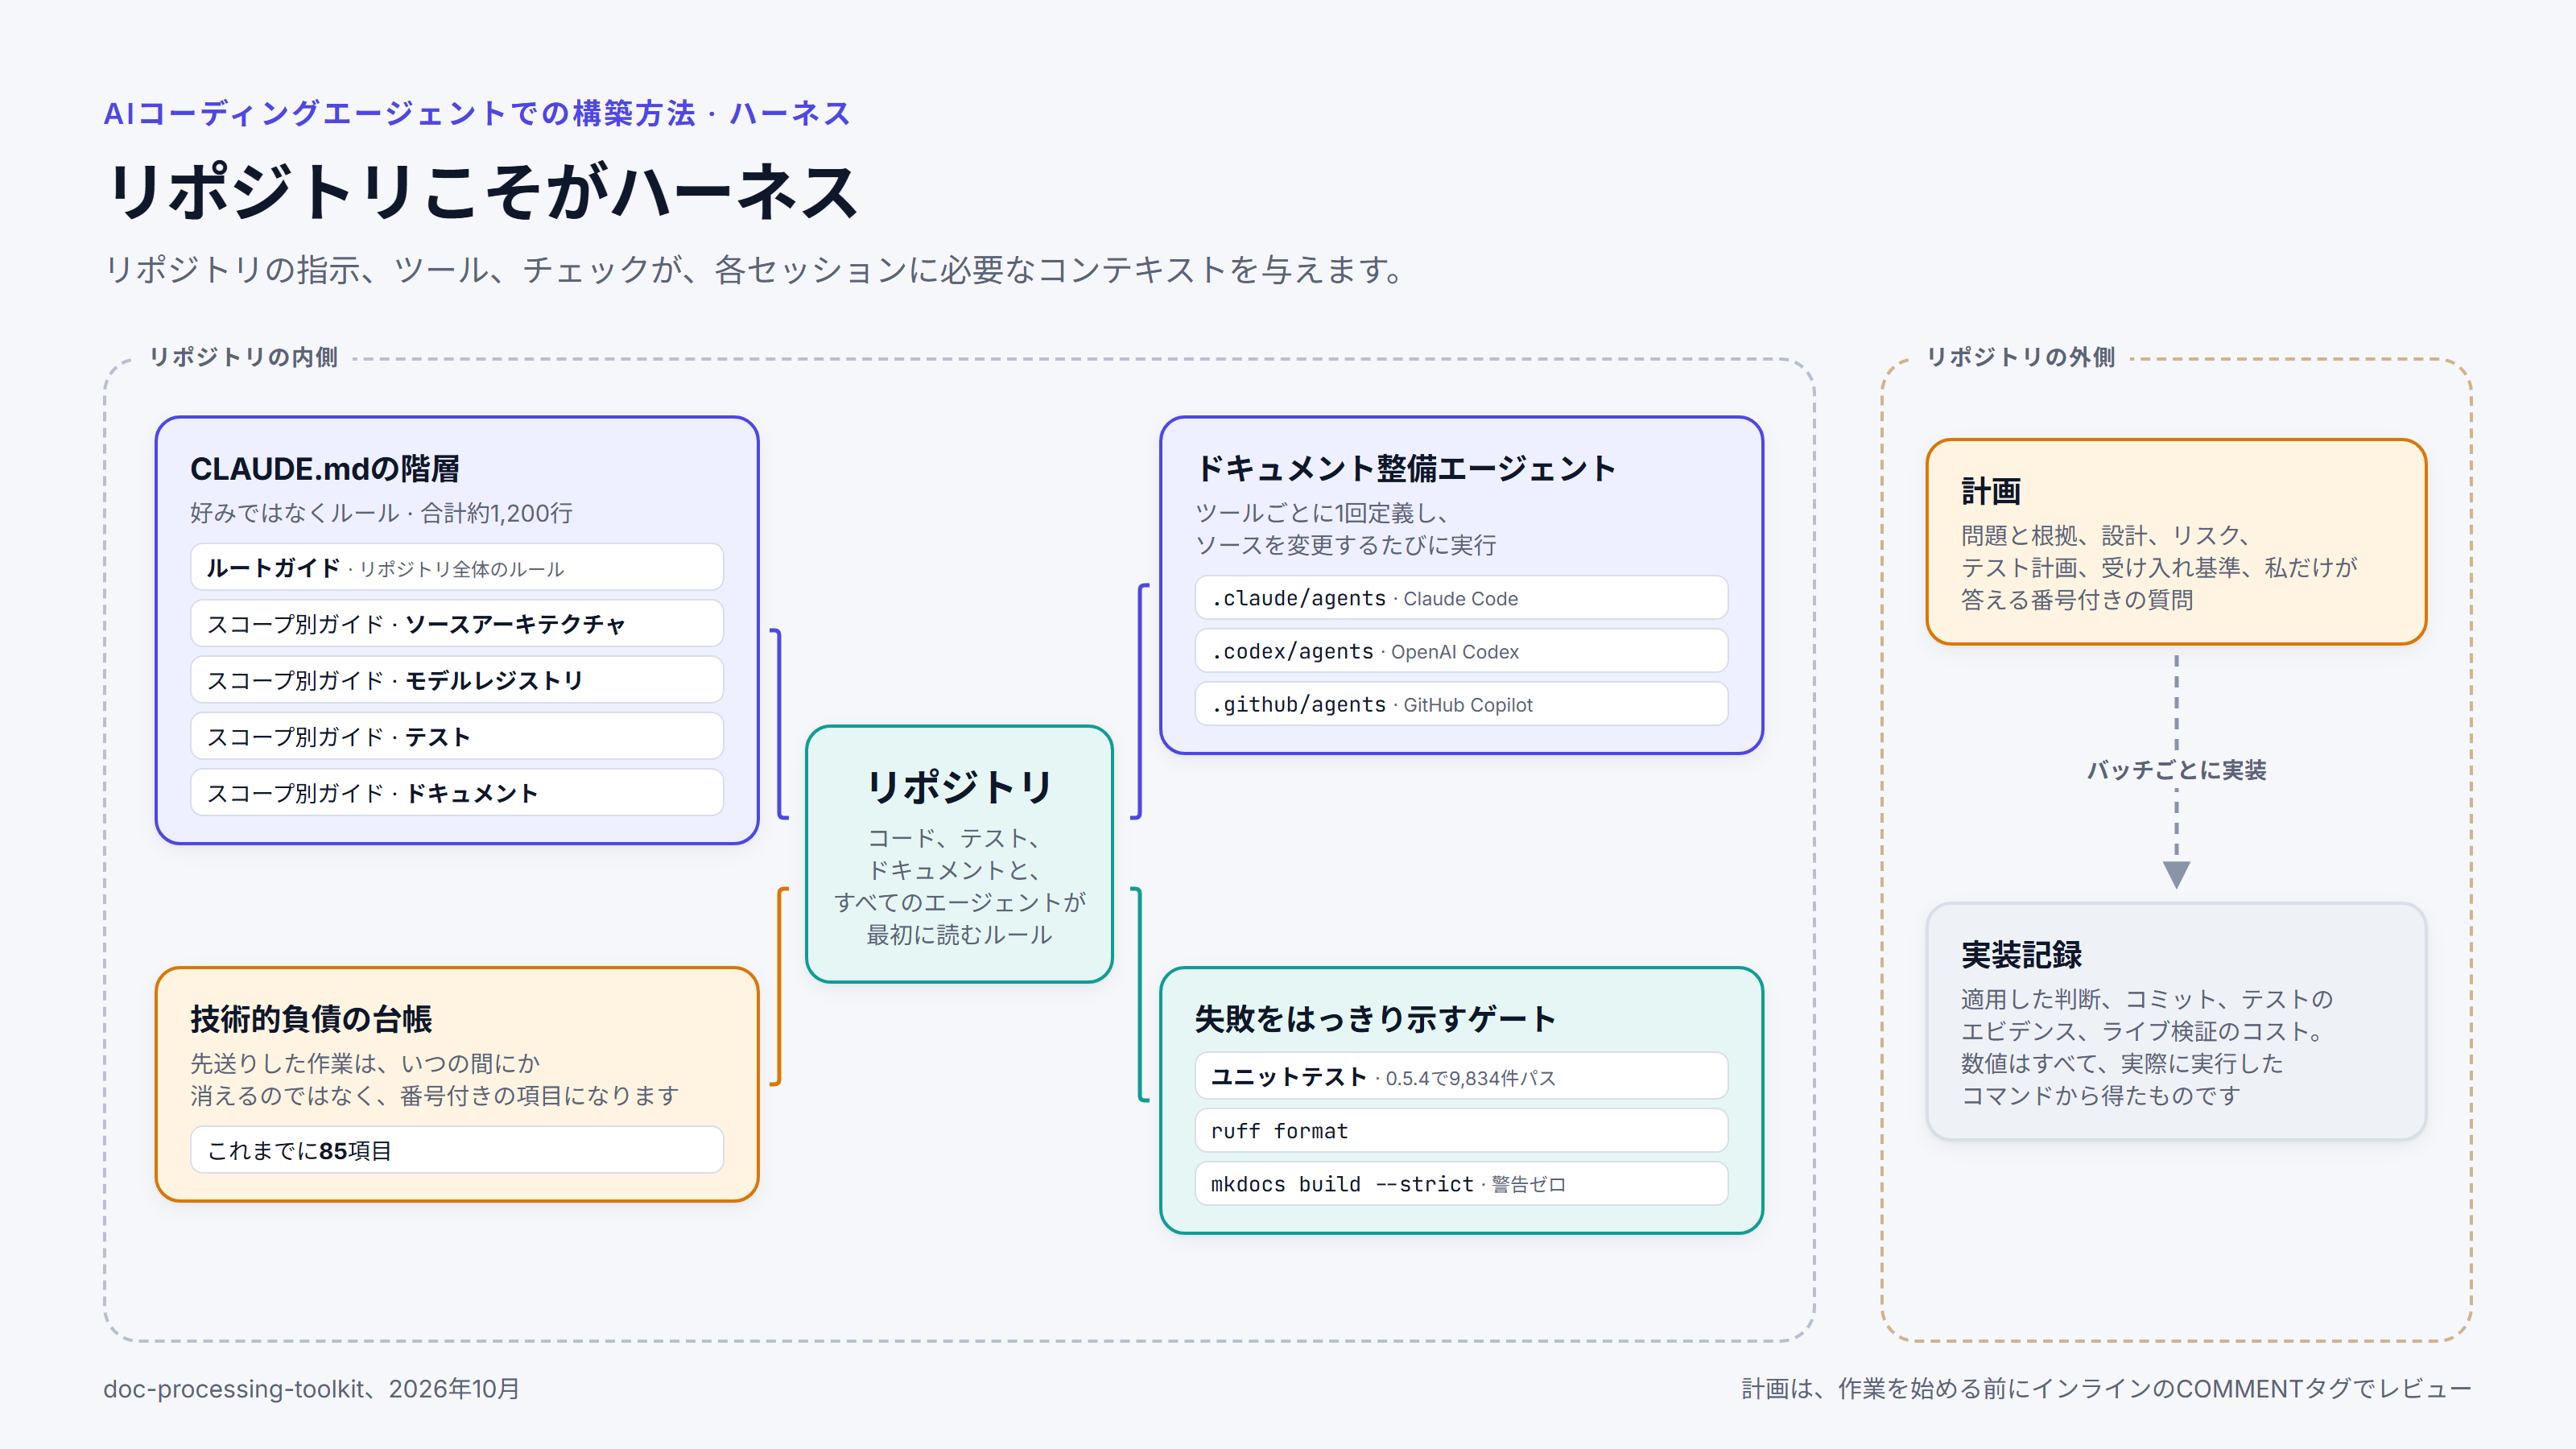
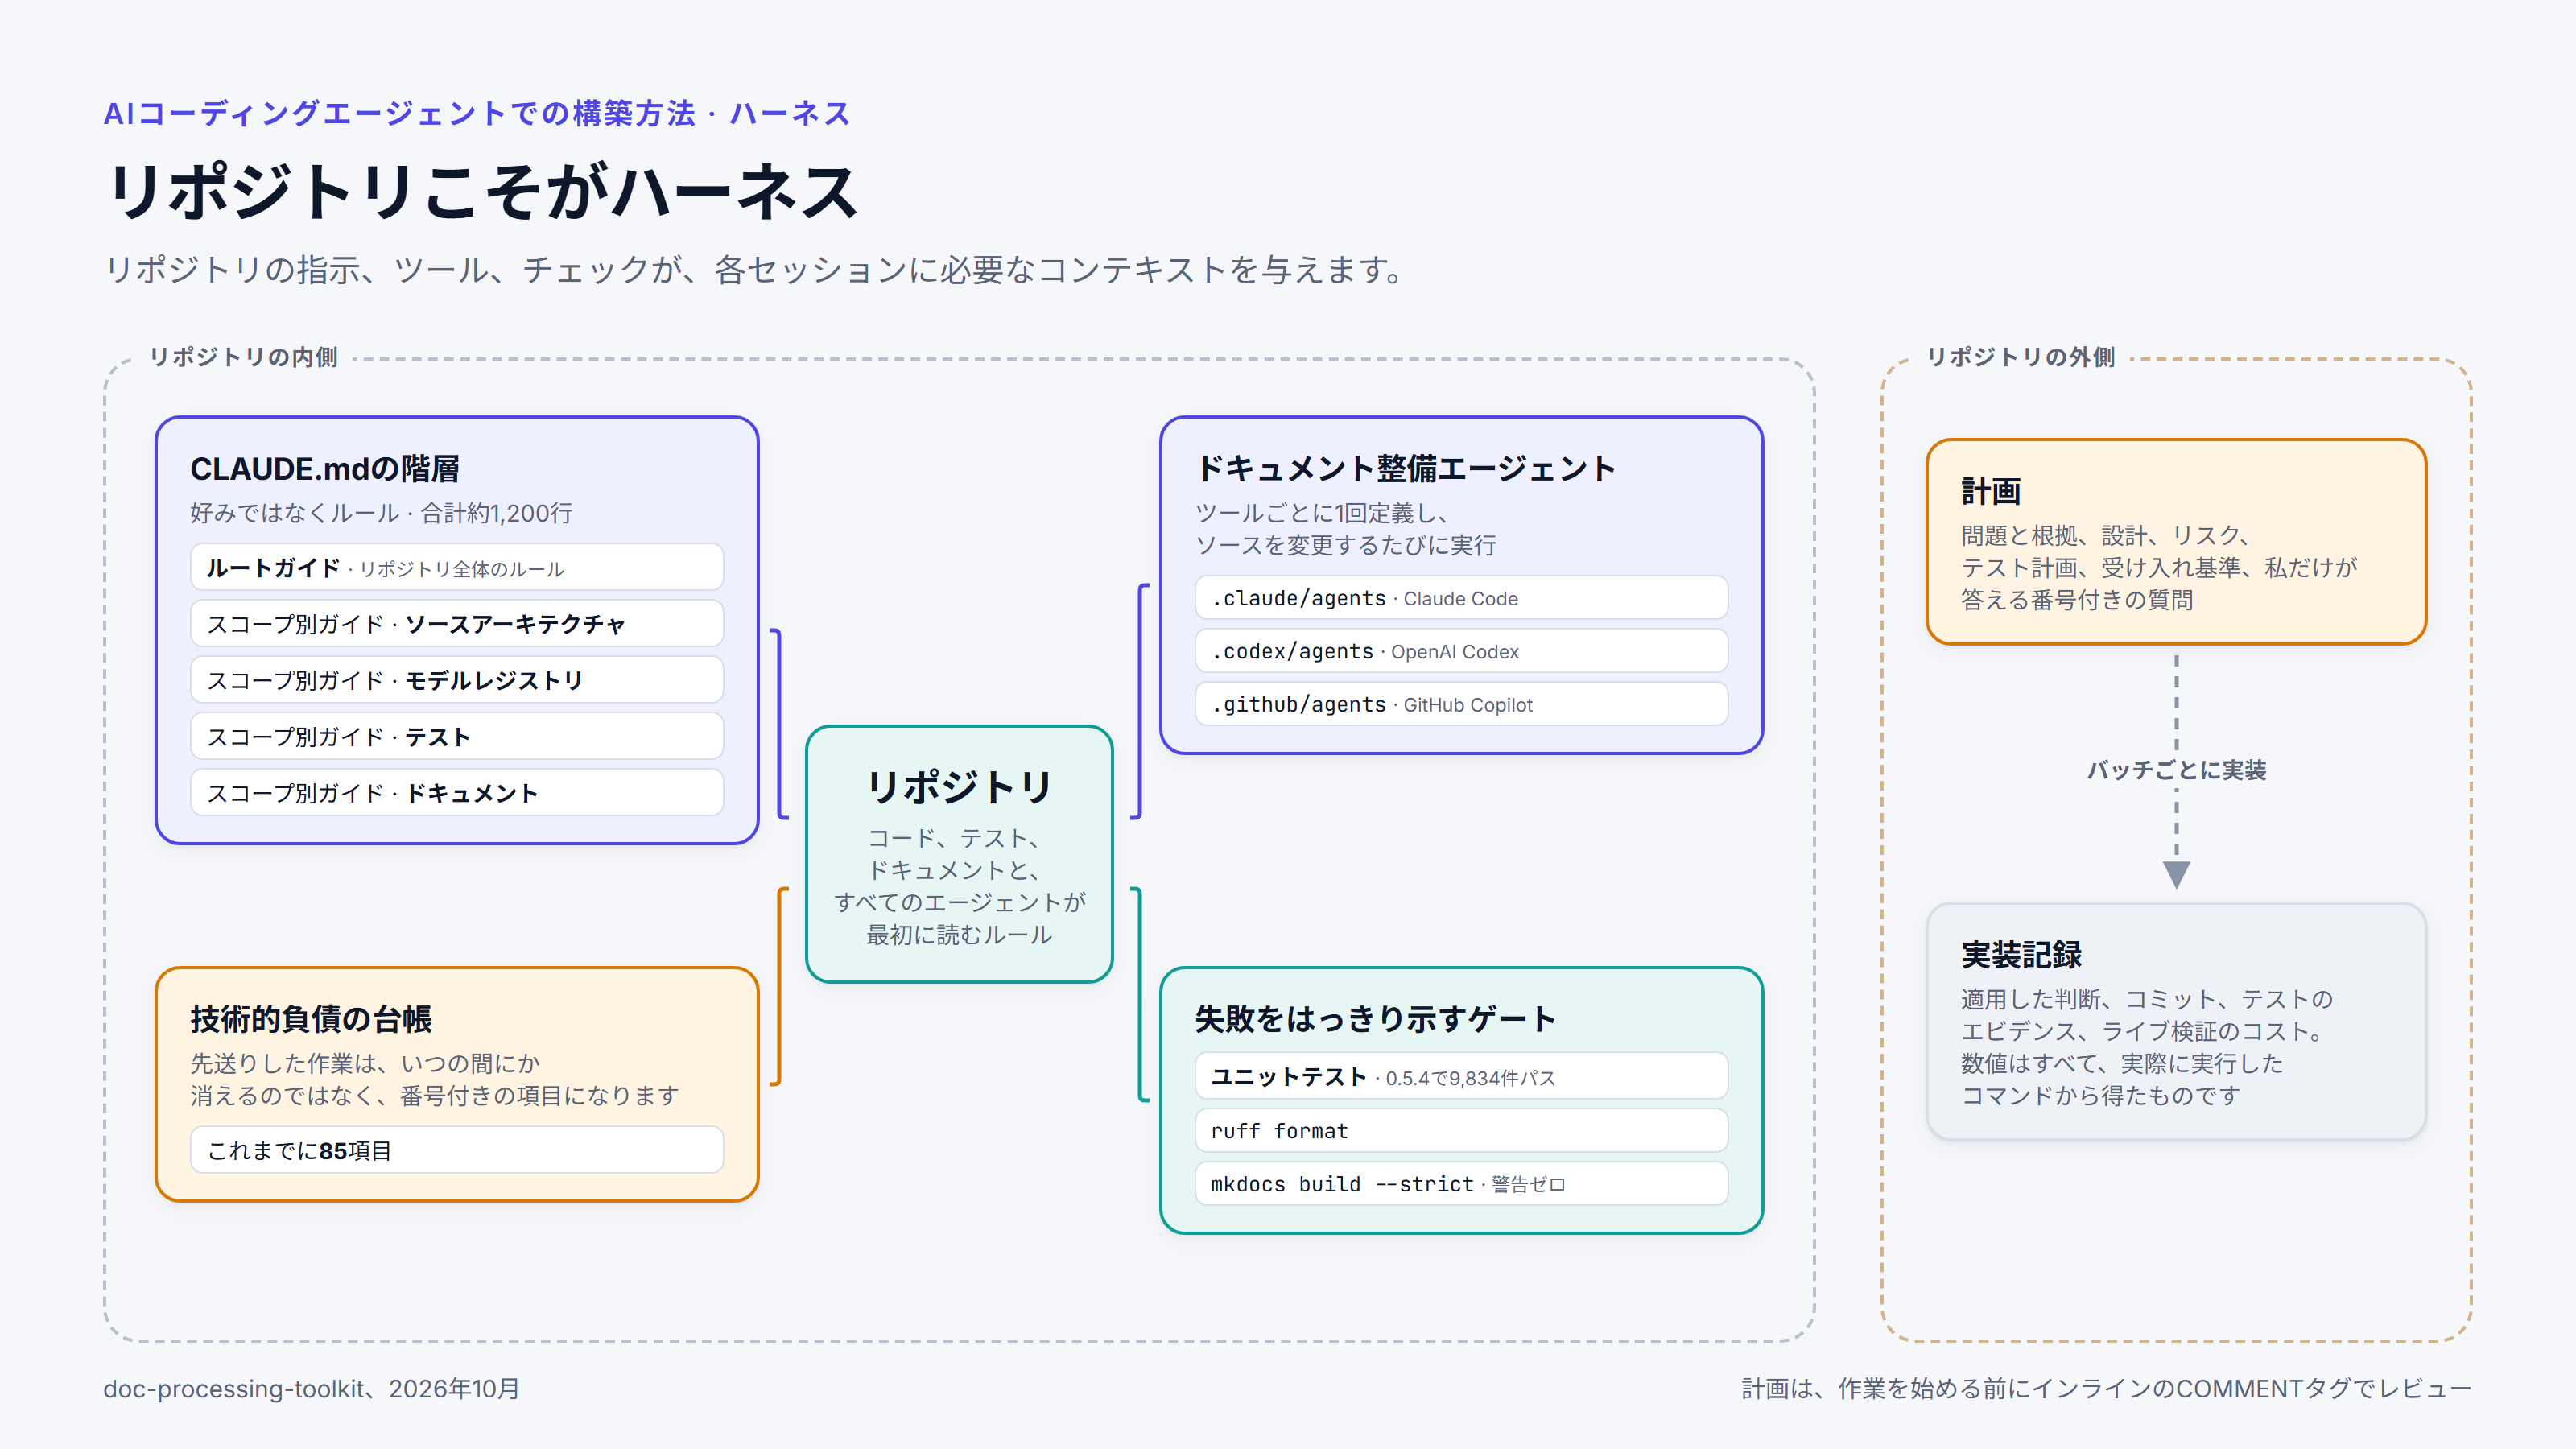
エージェントを取り巻くリポジトリの指示、ツール、チェックを、私はまとめてハーネスと考えています。ハーネスの役割は、各エージェントセッションに必要なコンテキストを与えることです。そうしておけば、結果が、私がプロンプトに何かを書き忘れたかどうかだけに左右されることはありません。
私のリポジトリのほとんどには、Claude Codeが読み込む指示ファイルCLAUDE.mdが一式あります。ほかのエージェントであるCodexとGitHub Copilotは、同じファイルをAGENTS.mdとして読み込みます。ツールキットには、メインのガイドに加えて、コードの構造、サポートするモデルの一覧、テスト、ドキュメントのそれぞれを扱う個別のガイドがあります。メインのガイドはルールとして書いています。その一部を挙げます。
Model additions are JSON-only.
Costs are billed per request and by served tier.
Cached tokens are a subset of input tokens.
A behaviour change a deployed client could notice ships with a kill switch.
Never push unless explicitly asked.
Stage an explicit file list. Never `git add -A` or `git add .`
平たく言えば、次のとおりです。モデルの追加は、データファイルにエントリーを1つ加えるだけで、新しいコードは書きません。コストはリクエストごとに、プロバイダーが実際に適用した料金ティアで計算し、キャッシュされた入力は入力の合計に含めて数えます。ツールキットをすでに使っているアプリケーションが気づきうる変更には、キルスイッチを付けます。キルスイッチとは、新しい挙動を再びオフにできる設定のことです。エージェントは、頼まれない限り共有リポジトリにプッシュせず、自分が変更したファイルだけを、1つずつ名前を指定してコミットします。
最後の2つは、同じリポジトリのコピーで複数のエージェントが同時に作業することがあるために設けています。各エージェントは自分のファイルだけをコミットし、自分が触っていないファイルは他者の作業中のものとして扱います。過去のインシデントから生まれたルールもあります。あるルールは特定のgitのショートカットを禁止していますが、それはこのショートカットが、すでにコミット済みだった機能を黙って元に戻してしまったことがあるからです。
git worktreeもよく使います。worktreeとは、同じリポジトリの追加の作業コピーで、それぞれが専用のブランチを持ちます。そのため、別々のworktreeで作業するエージェントは、互いのファイルに触れることなく同時に動けます。
ガイドには、コードを見ただけではわからない設計上の事柄も記録しています。たとえば、エージェントとモデルのやり取りを回すコードは、プロバイダーごとにほぼ同一のコピーが4つ存在します。そのためガイドには、このコードを変更するときは4つすべてに反映しなければならないと書いてあります。そうしないと、1つのプロバイダーでは動くのに、ほかのプロバイダーでは気づかれないまま動かない、ということになります。4つのコピーは後で統合すると決めており、ガイドには、別のタスクの副作用としてそれを始めないようにと書いています。
ドキュメント整備エージェントもあり、3つのツールそれぞれに用意しています。2026年2月にGitHub Copilotのエージェントとして始まり、4月にClaude CodeとCodexへ移植しました。コードを変更した後、このエージェントは、コード内の説明が今もコードと一致しているかを確認し、フォーマットを整え、警告なしでビルドできるまでドキュメントサイトを再ビルドし、READMEとAIツール向けのドキュメントバンドルを再生成し、ユニットテストを実行します。
先送りすると決めた作業は、番号付きの技術的負債の台帳に登録します。台帳は、既知の暫定対応と先送りした作業をまとめた一覧で、先送りしたものが失われないようにしています。
判断は計画に書く
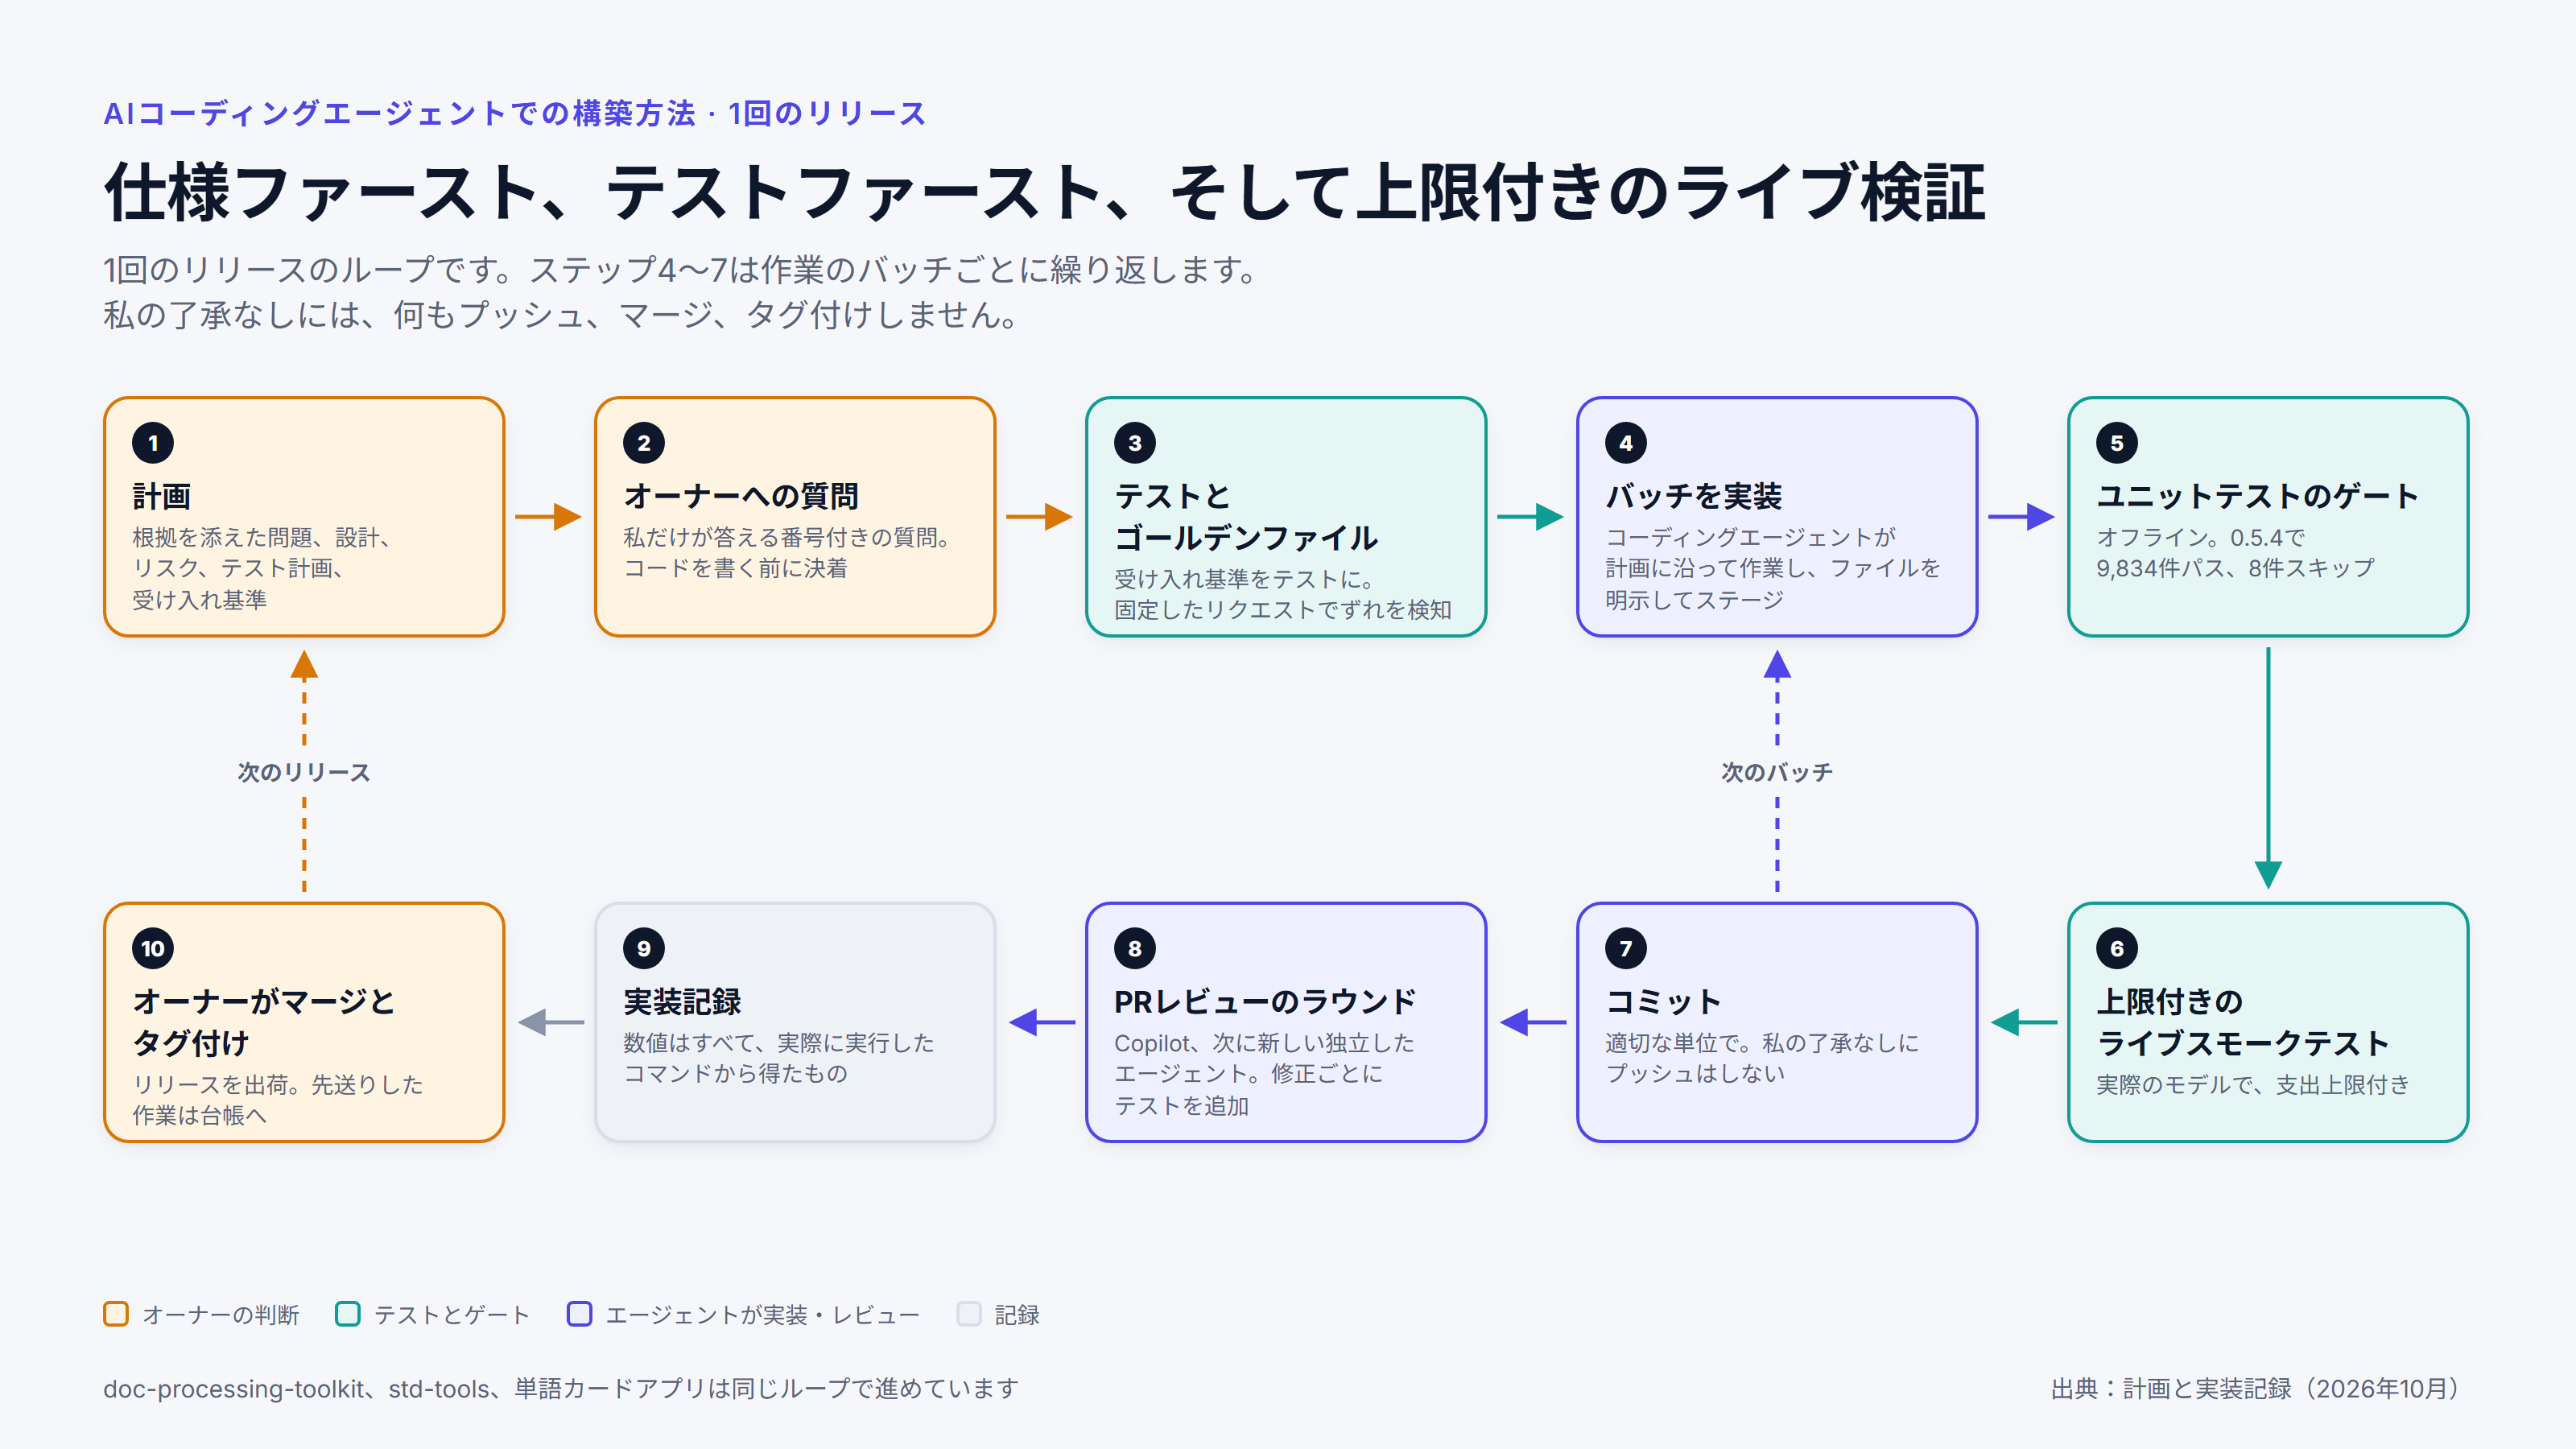
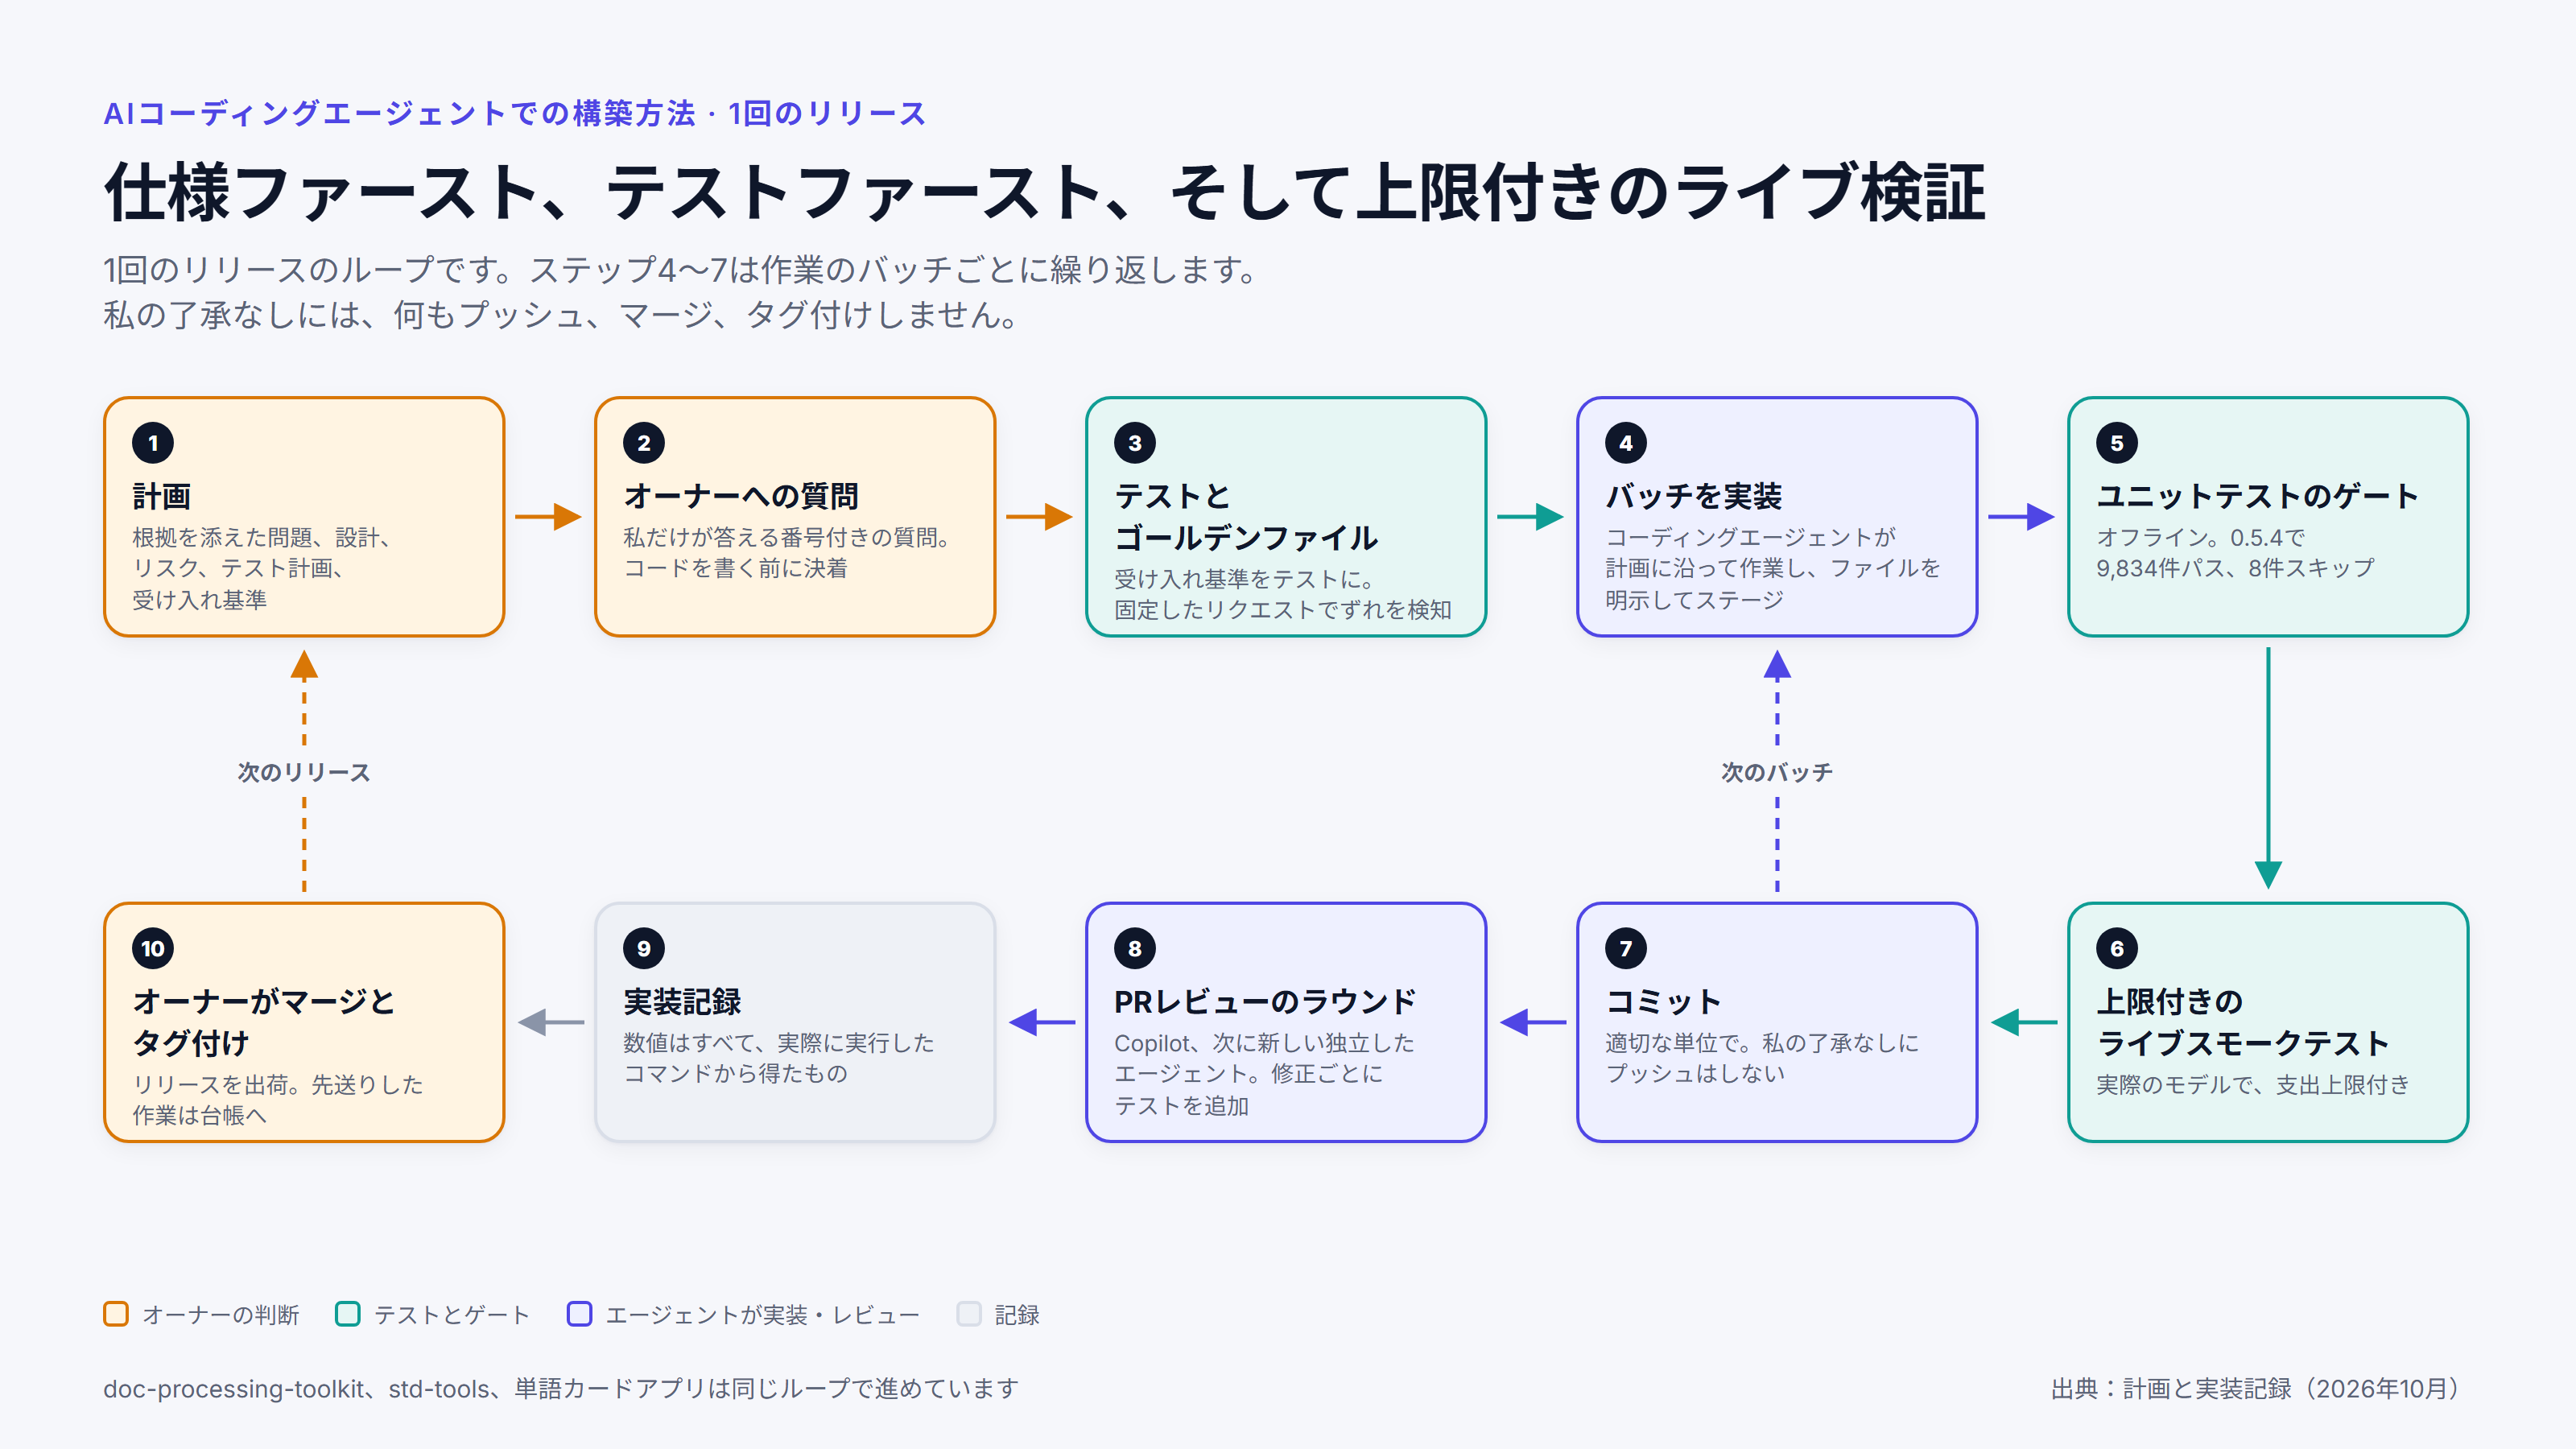
大きめの作業は、書面にした計画から始めます。最初の草稿は私が書き、その後エージェント(たいていはClaude Code)と一緒に、確定するまで練り上げます。各版のレビューでは、HTMLのコメントタグ(<!-- … -->)の中にコメントを書いてファイルそのものに書き込み、エージェントがそれを受けて計画を改訂します。変更点をプロンプトで説明するよりも、この方がうまくいきます。エージェントはgrepのようなテキスト検索ですべてのコメントを見つけられますし、各コメントは対象のテキストのすぐ横にあるので、エージェントはその文脈も一緒に受け取れるからです。長い内容をレビューするときは、タイピングでは時間がかかりすぎるため、コメントを音声で録音してエージェントに渡すこともあります。エージェントはそれを文字起こしし、コメントに対応します。計画には、問題とその根拠、設計、変更するコードの部分、リスク、テストの方法、完了をどう判断するかを書きます。また、コードを書く前に私が答えておくべき質問も列挙し、それ以外にもエージェントが確信を持てないことがあれば、必ず私に持ってくるようにしています。計画が確定したら、エージェントが進捗トラッカーを用意し、作業をバッチごとに進めます。
一例として、『6倍の乖離』で書いたコストの問題の後に立てた計画があります。この修正では、ツールキットがモデルの応答を受け取る方法を変え、ストリームとして少しずつ受け取るようにしました。そうすれば、途中で失敗したリクエストでも、何を使ったかの部分的な記録が残ります。計画では、コードを書く前に、ストリーミングは常に有効とし、無効にする設定は設けないこと、高額なコストに関するアラートはツールキットの上に構築されたアプリケーションに任せることを確定させました。計画には、作業を担うサブエージェント向けの指示書も添えました。サブエージェントとは、メインのセッションがタスクを引き渡す、別のエージェントセッションのことです。
サブエージェントは、妥当な場面ではどこでも使っています。サブエージェントはそれぞれ自分のコンテキスト(エージェントセッションの作業用の記憶)で動くので、私が一緒に作業しているメインのエージェントは、自分のコンテキストを作業の調整に使えます。調整役を置かずに、1つのエージェントを同じタスクで何度も繰り返し実行する構成(「Ralph loop」の考え方)も試し、それを検証するためにGitHub Copilotのカスタムエージェントもいくつか作りました。最終的には、1つのメインのエージェントが、作業に必要な数のサブエージェントを調整する形に落ち着きました。大規模な調査タスクでは、Claude Codeのワークフローがとても役立っています。メインのエージェントが、ほかのエージェントの調整を小さなプログラムとして書くものです。
ツールキットのあるリリース(0.5.4)では、計画が何回かのレビューラウンドを経ており、私の回答は計画内の表に記録されています。たとえば、すべてを1つのリリースで出すこと、残りのセキュリティ項目は次のリリースに回すこと、ツールキットの出力に対する3件の修正はキルスイッチなしで出すことを決めました。
単語カードアプリの計画には、私の未解決の質問、すでに対象外と決めた事項(蒸し返されないように)、そしてエージェント向けの固定ルールを書きました。force-pushしない(すでに共有された作業を上書きしてしまうことがあるため)、APIキーを保存しているファイルに触れない、名前を指定したファイルだけをコミットする、支出上限に達したら止まる、というものです。こうしたルールは、フックで強制することもできます。フックとは、エージェントがツールを使う前後に自動で実行されるスクリプトのことです。操作の前に実行されるフックはその操作をブロックできるので、エージェントが特定のファイルを読んだり、特定の操作をしたりするのを止められます。
このように計画するのは、作業の途中で未解決の質問に出くわしたエージェントは、たいていもっともらしい答えを選んでそのまま進めてしまい、その選択は大量の変更行の中では見落としやすいからです。先に質問に答え、新たな質問はエージェントに挙げさせることで、判断が文書として残り、結果をそれと照らし合わせて確認できます。
ずれを検知するテスト
理にかなう場合は、テストをコードより先に、またはコードと同時に書き、挙動がずれたとき、つまり誰も意図していないのに挙動が変わったときに失敗するように設計します。
ストリーミングへの変更では、新しいコードがまだ存在しない段階で、第1フェーズで91件の受け入れ基準(完成した作業が満たすべき条件)と74件のプレースホルダーテストを書きました。後続のフェーズで、それぞれのプレースホルダーを本物のテストに置き換えました。
ゴールデンファイルは、特定のモデルとオプションの組み合わせに対して、ツールキットがプロバイダーに送信する内容をそのまま保存したものです。ツールキットには112件のゴールデンファイルがあり、記録されたリクエストは1,000件を超えます。既存モデルに対して送信する内容が少しでも変わると、テストが失敗し、その差分が表示されます。Anthropicに送信するリクエストに比較的大きな変更を加える前には、1つのコミットで既存のリクエストを先に保存し、変更をそれと照らし合わせて確認できるようにしました。0.5.4のリリースでモデルを追加した際には、ゴールデンファイルを再生成すると新しいファイルが9件作られ、既存のファイルは1件も変わりませんでした。これらの記録を最新に保つ作業は継続的に必要です。プロバイダーはAPIを変更するので、記録と、ユニットテストが使う記録済みの応答は、プロバイダーが現在受け付ける内容や返す内容と一致していなければならないからです。
一部のテストは、ある機能を持つモデルをすべて名前で列挙しています。Claude Haiku 5.5を追加したときには、新しいモデルを各リストに加えるまで、そのうち3つのテストが失敗しました。これは意図したとおりの動きです。この失敗によって、新しいモデルがそれぞれのリストに入るべきかどうかを、誰かが判断することになるからです。似たテストとして、プロバイダーの公式Pythonライブラリが、ツールキットでまだテストしていない新しいメジャーバージョンになっていると失敗するものもあります。そのため、アップグレードが確認されないまま紛れ込むことはありません。
バグ修正には、修正がなければ失敗する回帰テストを求めます。修正前には失敗し、修正後にはパスするテストなら、そのバグを確かに検出できるので、バグが再発したときにも捕まえられます。単語カードアプリのレビューラウンド(詳しい経緯は『LLMアプリを最新に保つ』に書いています)では、5件の新しいテストのそれぞれが、対応する修正がなければ失敗し、修正があればパスしました。doc-processing-std-toolsのあるリリースでは、独立したレビュアーが、修正前のバージョンで8件の新しいテストが失敗することを確認しました。
テストガイドには、リリースごとのユニットテストの結果を記録しています。doc-processing-toolkit 0.5.4では、2026年10月9日に計測した、すべての変更が通過しなければならないユニットテストの結果は、9,834件がパス、8件がスキップでした。テストには、オプションの依存関係がインストールされていない場合など、特定の条件でスキップするよう印を付けることができます。ガイドはこの8件のスキップを基準とし、スキップ数がそれを大きく上回る場合は調査するよう書いています。テストが黙って無効化されている可能性があるからです。
これらのユニットテストは、どのプロバイダーにも接続しません。プロバイダーの代わりにゴールデンファイルと、記録済みの応答や模擬の応答を使い、組み立てるリクエスト、モデルの一覧、コスト計算など、ツールキット自身のロジックを確認します。プロバイダーが実際にどう応答するかは、実際のAPIを呼び出すライブテストでカバーしており、それについては後述します。
実装とレビュー
メインのエージェント(私の場合はたいていClaude Code)が、計画をバッチごとに実装します。各バッチは、実装、ユニットテストの実行、実モデルに対する簡単なライブテスト、コミットという同じ順序で進めます。リリースの準備ができたら、プルリクエストをレビューにかけます。
エージェント同士は互いに呼び出し合えます。Claude Code向けにはCodexとやり取りするためのスキルを、Codex向けにはClaude Codeとやり取りするためのスキルを用意しています(スキルとは、エージェントが必要なときに読み込む、ひとまとめにした指示のことです)。どちらも、Copilotのコマンドラインツールを通じて、GitHub Copilotのレビューエージェントにレビューを依頼することもできます。
プルリクエストのレビューは、別のエージェント(Claudeのサブエージェント、Codex、またはCopilot)が行います。各指摘はまず再現し、そのうえで、修正するか、回答するか、後のために記録するかを私が決めます。doc-processing-std-toolsでは、ツールがプライベートネットワークのアドレスにアクセスするのを防ぐセキュリティチェックが、Python自身が持つ予約済みアドレスの一覧に依存しており、Python 3.10ではその一覧が一部のアドレスをパブリックとして扱うことを、Copilotが見つけました。修正では公式の一覧をコード内に書き込み、どのPythonのバージョンでも同じ結果になるようにしました。すべての指摘が修正につながるわけではありません。単語カードアプリでのある指摘には、対応すれば「数字をでっち上げることになる」という理由を添えて、修正の代わりに回答しました。
CodexをClaudeの批評役として使うこともあれば、その逆もあります。8月には、あるリリースの出荷前に、Codexによるレビューを5回行いました。リリース全体のレビューが1回、領域ごとに分けたレビューが4回(プロバイダーとの接続とコスト計算、エージェントを実行するコード、新規モジュール、セキュリティ)です。修正は1つのコミットにまとめました。その1つは、リクエストがフォールバック経路をたどったときに失われていた、キャッシュされた入力の料金を元に戻す修正です。残りの指摘はツールキットのセキュリティ上の前提に関する問いだったため、私が判断する項目として技術的負債の台帳に登録しました。
doc-processing-std-toolsのあるリリース(0.6.1)では、3つの新しいエージェントセッションが、何も編集せずに順番に変更をレビューしました。1回目のレビューでは、承認なしにエージェントがデスクトップを操作するのを防ぐための確認ステップを、すり抜ける方法が見つかりました。2回目のレビューでは修正を確認し、同じ入力をより長く表記すると、まだすり抜けられることがわかりました。3回目のレビューでは、リリースはマージ可能と報告されました。レビューを何回重ねても、コードが正しいことの証明にはなりません。この例では、2回目のレビューが最初の修正を検証したからこそ、その穴が見つかったのです。
ドキュメントの見直しでは、古くなった記述だけでなく、コードのバグが見つかることもあります。9月には、ドキュメントの見直しによって、再試行したリクエストのコストを表すツールキットの数値が、ずっとゼロだったことが判明しました。
実際のAPIに対する検証
ユニットテストはオフラインで実行します。ライブテストは、どのモデルをテストするかを選ぶスクリプトを通じて、プロバイダーの実際のAPIを呼び出します。毎回すべてのモデルをテストすると、費用は13倍になります。
ライブ検証には、プロジェクトごとに予算を設けています。単語カードアプリの計画では、アプリのコスト表示がUS$2を超えた場合、または1回の実行がUS$0.50を超えた場合は、作業を止めて確認するようエージェントに指示していました。アプリの実際のAPIに対するライブテストは、レビュー対応後の再実行を含めて合計US$0.32でした。doc-processing-toolkit 0.5.4のライブ検証は約1ドルで、リリース記録には検証ごとの内訳が残っています。これらの上限は、こうした小規模なプロジェクトに合わせたものです。ほかのプロジェクトにも通用するのは、有料の呼び出しを始める前に、上限と、エージェントが止まって確認するポイントを決めておくという点です。
ライブ検証は、モック(プロバイダーのAPIの代わりに使う模擬的なもの)では見つけられない問題を見つけます。doc-processing-toolkit 0.5.4のライブ検証では、Geminiの画像モデルがJPEG画像を返すのに、コードはすべてのファイルを.pngとして保存していたことがわかりました。
2026年10月9日の検証では、Googleのgemini-nano-banana-2.1モデルに、60 MBのクリップを1つのリクエストに含めて送信しました。Googleのファイル入力ガイドでは、この方法で最大100 MB(PDFは50 MB)まで送信できるとされていますが、計画では古いページにあった20 MBという上限を前提にしていました。ツールキットは安全マージンとして、20 MBを超えるとGoogleの別のファイルアップロードサービスに切り替える仕組みを今も維持しています。その仕組みは、ドキュメントのMultimediaのページで説明しています。
同じく10月9日にclaude-haiku-5-5で行った別の検証では、モデルがトークンをどう数えるかを計測しました。トークンは、プロバイダーが課金の単位とし、モデルの上限もその単位で測られるものです。約101,000トークンになると見込んでいた、繰り返しテキストからなる737,000文字のプロンプトは、264,555トークンになりました。このモデルは、この種の繰り返しの多いテキストを、1トークンあたり約2.8文字で数えるためです。そのため、文字数を基準にサイズを決めたプロンプトは、想定よりはるかに高くついたり、まったく収まらなかったりすることがあります。
実装記録
各リリースは、実装記録で締めくくります。記録には、適用した判断、項目ごとの作業内容とそのコミット、テストのエビデンス、コストを付記したライブ検証、計画からの逸脱、見つかった問題、フォローアップを書きます。検証していないものには「not verified」と記すので、記録の中では、計測したことと仮定したことが区別されます。
記録そのものも訂正されます。ある記録では、ライブ検証が、シミュレートしたキー入力を、それを送信したツールが成功と報告したことを理由に成功と数えていましたが、実際にはキー入力は無視されていました。レビュー後、キー入力そのものを監視する検証に修正しました。別の記録では、プルリクエストの説明がユーザーインターフェースの確認結果を誇張しており、記録にはその訂正が記されています。
全体のアーキテクチャとコードについての最終的な承認は、私が行います。
今も私の判断が必要なこと
コードの多くはエージェントが書き、エージェントのレビューはしばしば設計上の問いを投げかけます。それでも、判断を下すのは私です。その出発点は、クライアントが何を必要としているかを理解し、全体のビジョンを定め、何を優先し、物事がどう動くべきかを決めることです。エージェントが実装を担う部分が増えるにつれ、私の役割のうちこの部分は以前より重要になっています。コードの1行1行をすべて説明できる必要はありませんが、システムがどう動くのか、そしてほかの選択肢と比べてなぜその設計を選んだのかは、説明できなければなりません。
ツールキットでは、判断の対象にアーキテクチャが含まれます。各プロバイダーをどう接続するか、モデルの一覧をデータとして持つこと、各リクエストのコストをどう計算するか、フックと長い会話の短縮をどこに組み込むか、です。スコープも含まれます。何をリリースに含め、何を技術的負債の項目とし、何を対象外とするか、ということです。たとえば、新しいGemini APIへの移行は見送り、ツールキットの2つの機能(ハーネスのフックとスケジュール実行のエージェント)は先送りし、ストリーミングは無効にできないようにすると決めました。
セキュリティのトレードオフも私が判断します。ツールキットのMCPサーバーは、ユーザーが信頼するマシン上で動くように設計されています。私はその制約を文書化し、信頼できないクライアントにサーバーを公開しないよう警告を添えることにして、プロダクト自体はそのままにしました。どの指摘をリリースのブロッカーとし、どれを修正案の概略とともに台帳に登録するかも、私が決めます。ツールキットをすでに使っているアプリケーションが気づきうる変更は、私が適用除外としない限りキルスイッチ付きで出荷し、適用除外とした場合は変更履歴 (changelog) に記載します。
作業の中には、楽にならなかった部分もあります。曖昧な要件は、エージェントがもっともらしいが誤った方向で決めてしまう前に、私が気づけるかどうかに今もかかっています。そして計画がカバーできるのは、私が思いついた質問だけです。レビューの指摘を判断するにはプロダクトの知識が必要です。コードについては正しい指摘でも、行うべき変更としては間違っていることがあるからです。実運用に近い評価は自動化が難しいものです。ユニットテストは記録済みの応答や模擬の応答に対して実行され、ライブ検証は上限付きの小さなサンプルにすぎません。そのため、トークン数や、Googleの実際のサイズ上限は、実際のAPIに対して初めて表に出ました。変更をシステム全体に組み込むことにも注意が必要です。小さく見える変更が、4つのプロバイダーすべて、すでに使われているアプリケーション、あるいはセキュリティ境界に影響しうるからです。