保守中日本語学習 · アプリケーション
Japanese Flashcard Generator
日本語の学習教材の写真を、OCRと言語モデルでAnkiの単語カードに変換する小さなアプリ。生成したカードは、取り込む前に確認できます。
約7分で読めます
- カードのモード:語彙・漢字・文法
- 3
- 選べるGeminiモデル(2026年10月時点)
- 6
- Gemini 3.8 Flashで語彙モードを1回テスト実行したときのGeminiの料金(2026年10月9日)
- ~US$0.02
- 公開中のバージョンで合格している自動テスト(2026年10月時点)
- 37
使用技術
- Python
- Streamlit
- Google Gemini
- google-genai
- Pydantic
- Pillow
- LLMWhisperer
- pytest
開発のきっかけ
日本語の学習ページから単語カード(フラッシュカード)を手作業で作るのは、時間がかかる作業でした。写真やスキャンしたページの文字はそのままコピーできないため、語彙や文法のページを撮影してから、項目を1つずつAnkiに入力していたのです。そこで、その入力作業を代わりにやってくれる小さなアプリを作りました。
また、レストランのメニューや看板など、スマートフォンで撮影できるものなら何でも使えるので、写真1枚で、覚えたい言葉の単語カードを作れます。日本に移り住んだばかりの頃は、これが役に立ちました。まだ読めない言葉をよく目にして、それを練習したいと思っていたからです。
オープンソースで公開しており、ライブ版は誰でも自分のAPIキーで利用できます。
しくみ
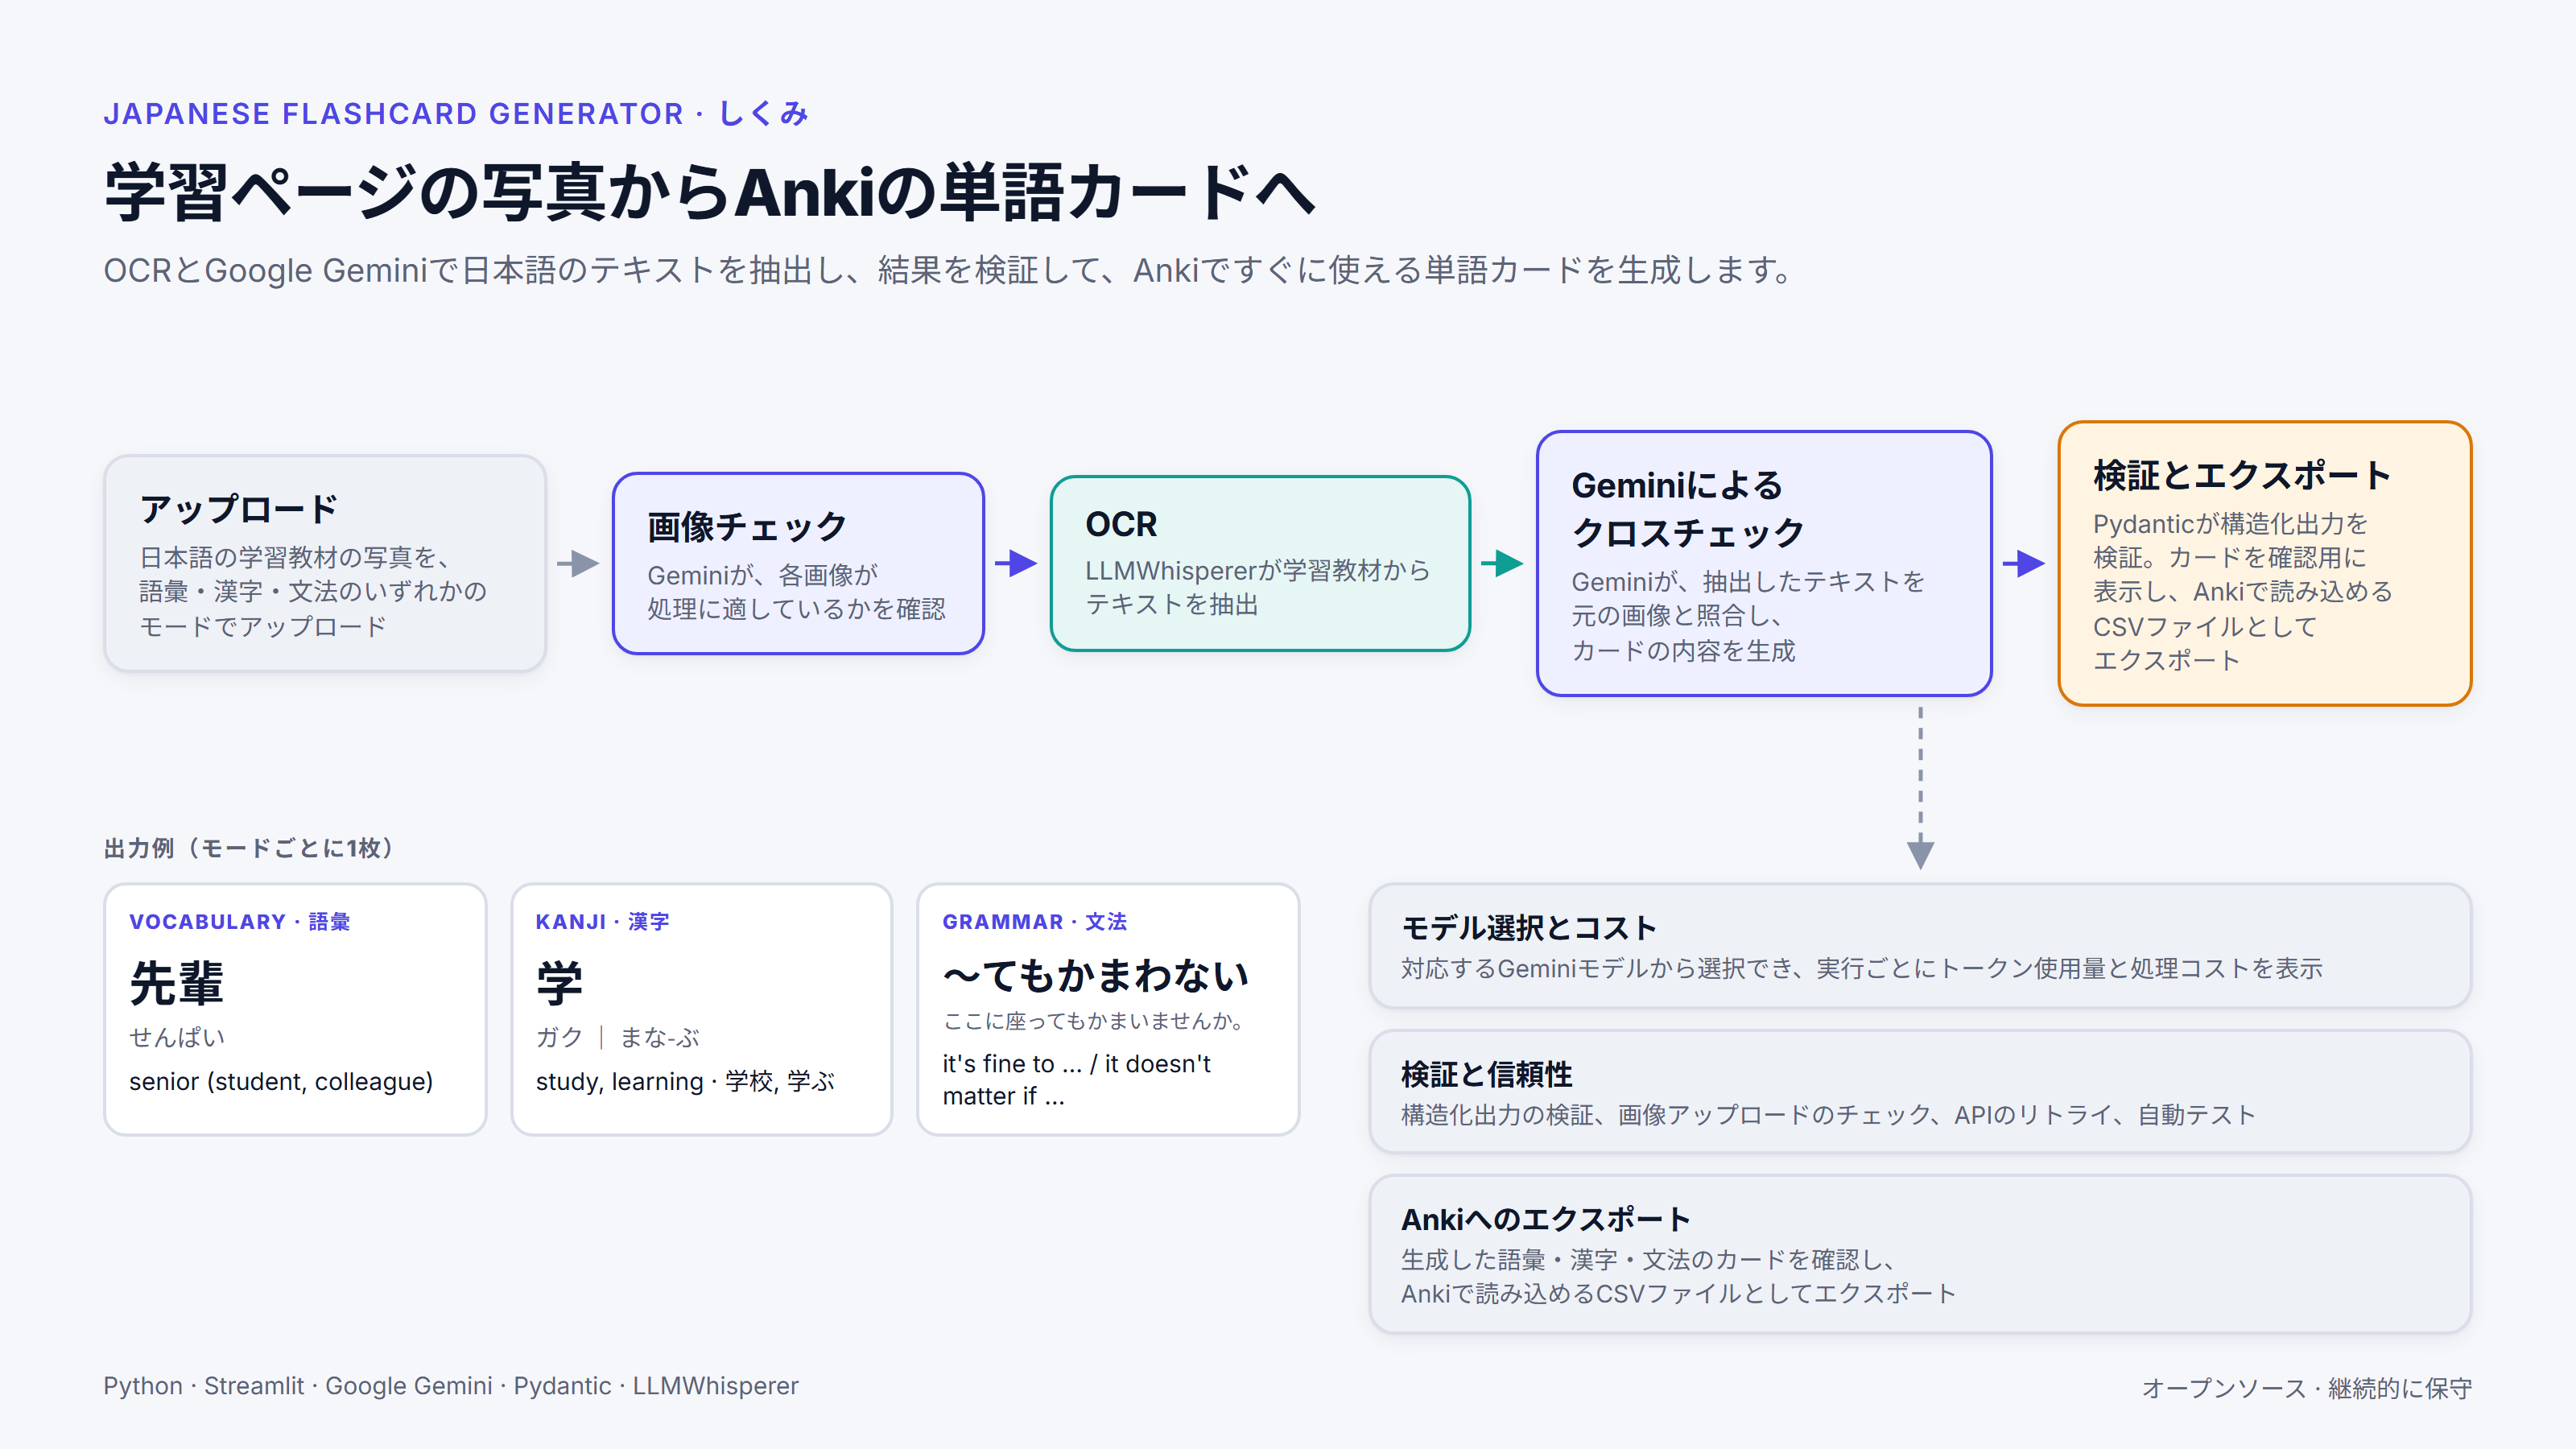
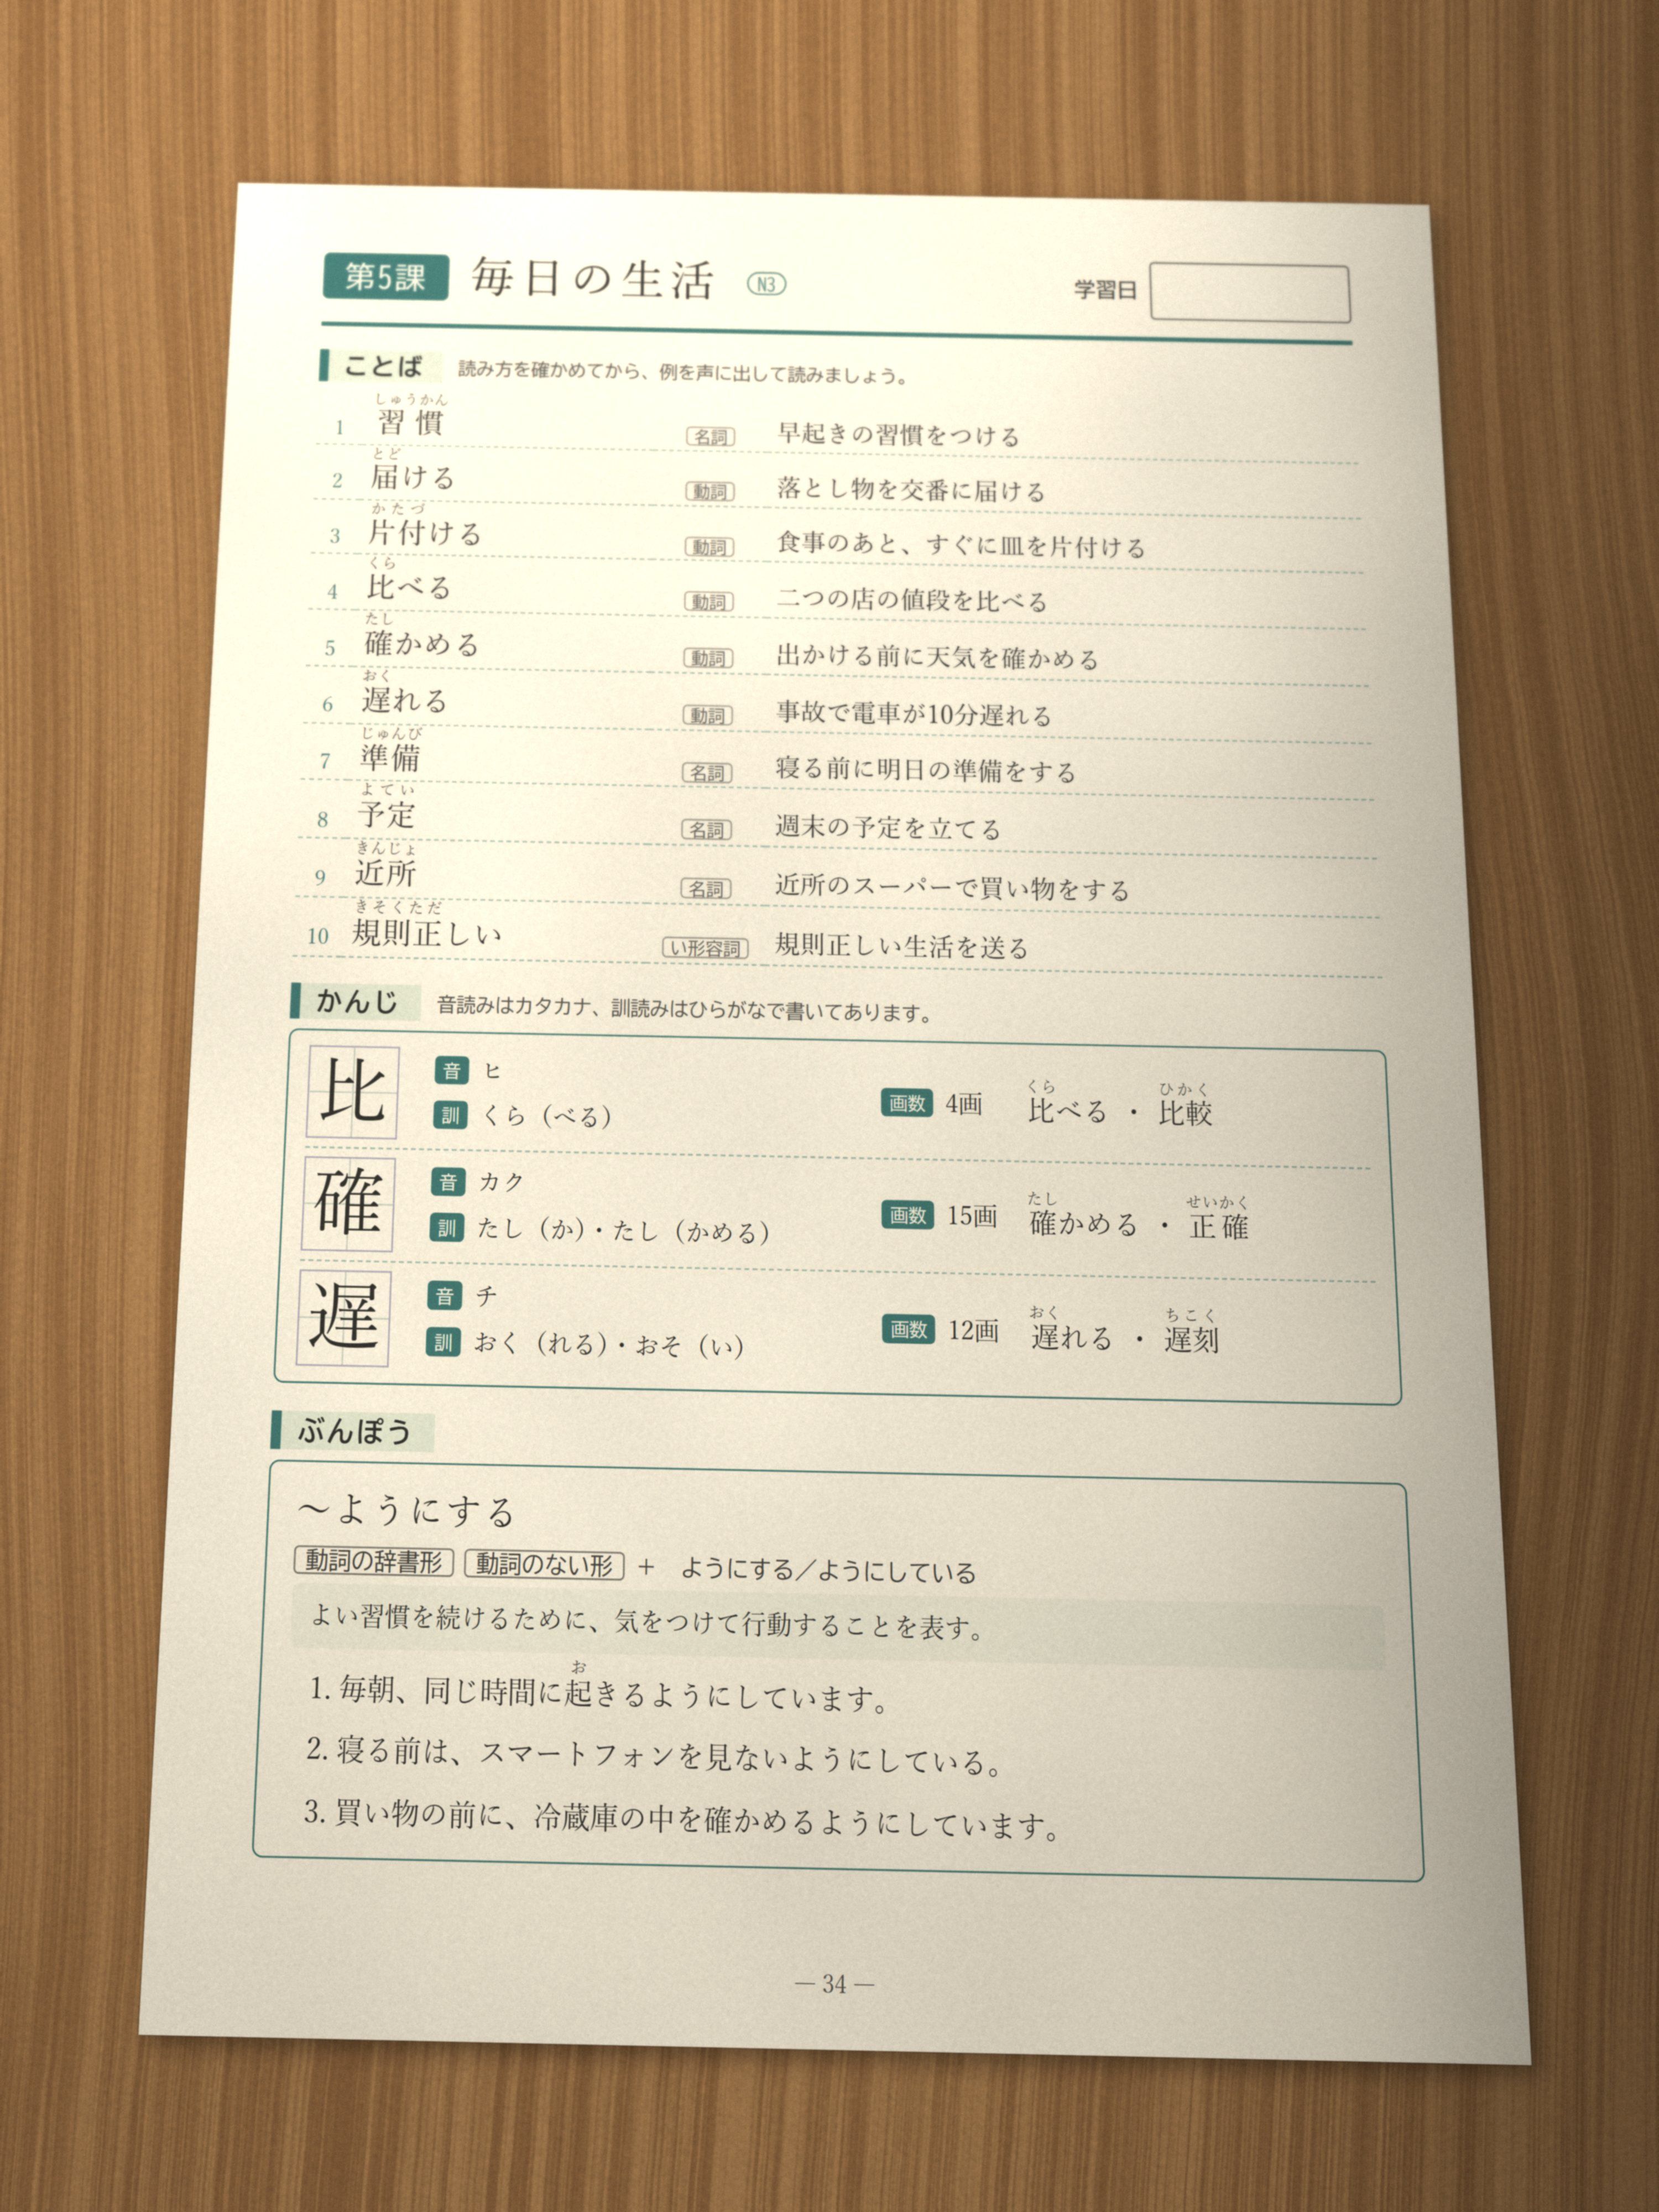
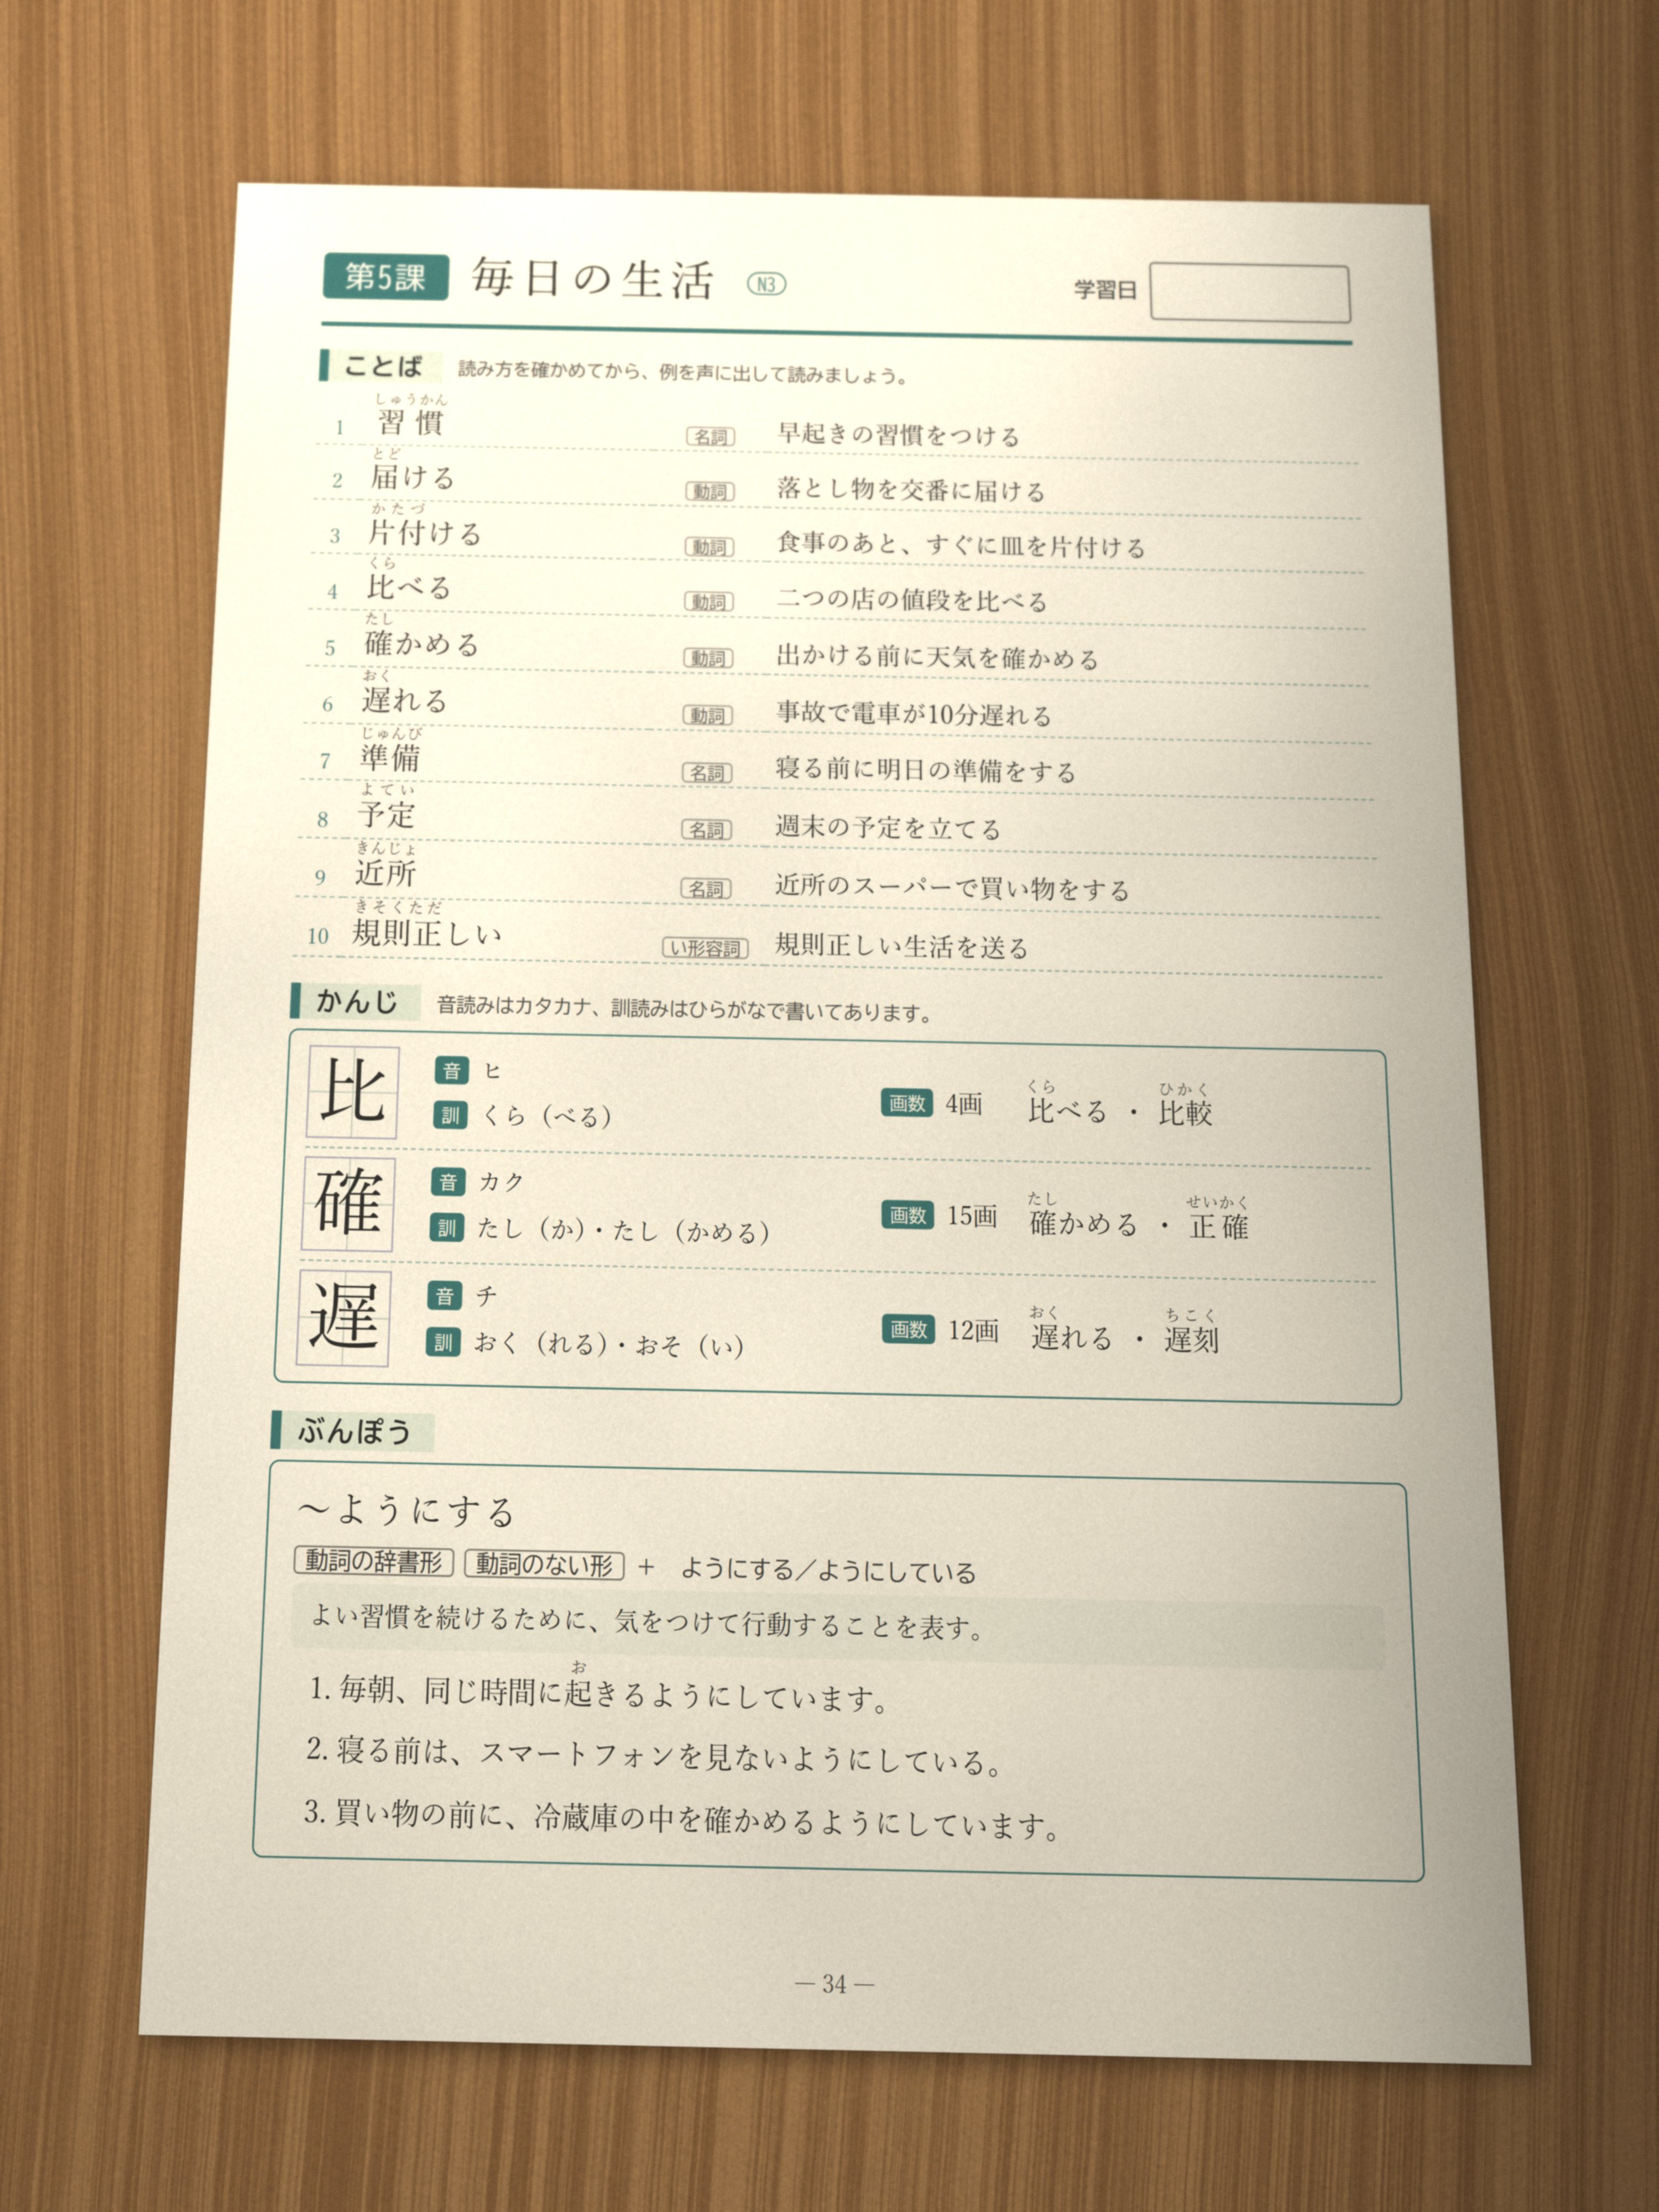
アプリには3つのモードがあります。語彙カードには漢字、読み、意味を、漢字カードには音読み・訓読みと例語を、文法カードには文型、説明、例文を載せます。
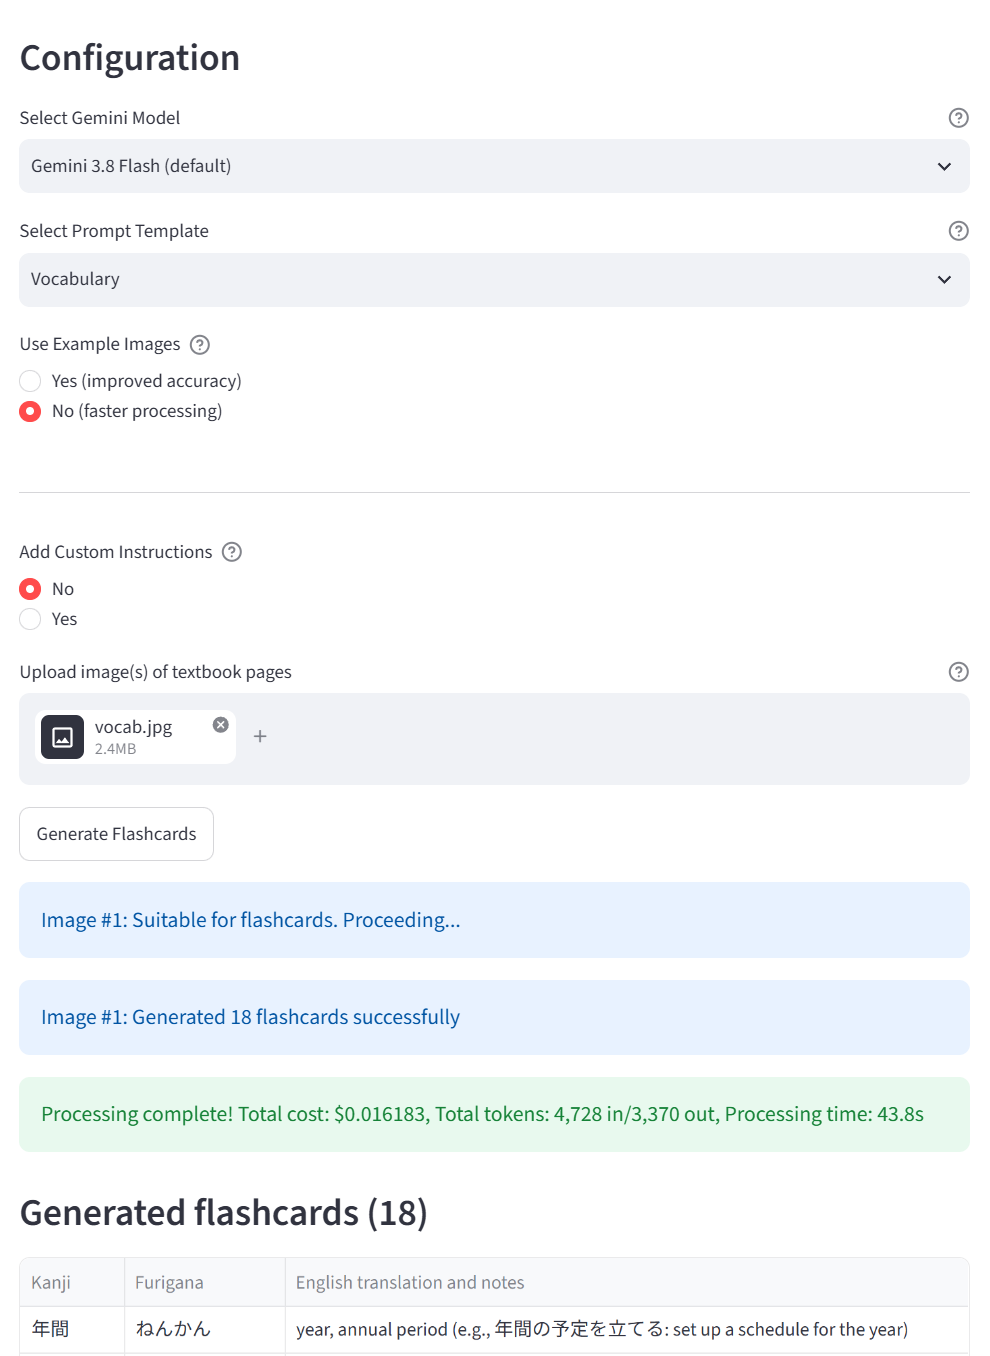
録画の内容
- 学習ページの写真をアップロードします。
- 語彙、漢字、文法の順にカードを生成します。
- それぞれのカードの表を確認します。
各実行は、次の短いパイプラインを通ります。
- アップロード。 画像をデコードする前に、写真の形式、サイズ、ファイル数を確認し、展開爆弾 (decompression bomb) も防ぎます。
- 画像チェック。 OCRの費用が発生する前に、Geminiの呼び出しで、学習ページとして使えない写真をスキップします。
- OCR。 位置情報を取り除いた写真のコピーから、LLMWhispererがテキストを抽出します。メタデータを除去しても、画像データそのものには手を加えません。
- Geminiによるクロスチェック。 Geminiが、抽出したテキストを元の画像と照合し、カードの内容を書き出します。その際、例ページやユーザー自身の指示を手がかりにすることもできます。
- 検証とエクスポート。 Pydanticが、モードごとのスキーマに照らして構造化出力をチェックします。これで各カードの構造は確認できますが、日本語が正しいかどうかまではわかりません。そのため、Ankiで読み込めるカンマ区切りのテキストファイルとしてダウンロードする前に、カードを表で表示して確認できるようにしています。
録画の内容
- 学習ページと一緒に、学習ページではない写真をアップロードします。
- アプリがその写真をスキップし、理由を表示します。
- 学習ページのカードは通常どおり生成されます。
OCRとビジョンモデルの両方を使うのは、どちらにも単独では弱点があるからです。OCRは文字を取れても、意味が失われます。たとえばLLMWhispererのレイアウト出力では、日本語の文字の間に空白が入ってしまいます。一方、ビジョンモデルだけでは、項目を見落としたり、存在しない項目を作り出したりすることがあります。アプリを最初に作った頃は、両者を突き合わせることで、どちらか単独よりもきれいなカードができました。現在利用できる最も高性能なモデルなら、OCRを別の工程として行う必要は、もうないかもしれません。
使ってみる
アプリ側ではAPIキーを用意していないため、ライブアプリを使うには、ご自身のGeminiのAPIキーとLLMWhispererのAPIキーが必要です。キーはパスワード欄に入力する形式で、アプリには保存されません。アプリ自体は無料ですが、API呼び出しにはご自身のキーを使うため、ご利用のプランに応じて、GoogleやLLMWhispererから料金が請求される場合があります。
キーを入力したら、モードとモデルを選び、学習ページの写真をアップロードしてカードを生成します。動詞を中心にするなど、ご自身の指示を加えて実行することもできます。
録画の内容
- いつもどおり、学習ページのカードを生成します。
- 「Add Custom Instructions」をオンにして、「Focus on the verbs and add an example sentence to each card.」と入力します。
- 同じページのカードをもう一度生成します。
- 今度は、ページにある動詞ごとに1枚ずつ、計5枚のカードができます。1回目の実行では14枚でした。
表を確認したら、テキストファイルをダウンロードしてAnkiに読み込みます。
録画の内容
- カードをテキストファイルとしてダウンロードします。
- Ankiで「ファイル」から「読み込む」を選びます。
- カードがデッキに入り、すぐに学習できます。
ソースコードは、Apache-2.0ライセンスでGitHubに公開しています。
最新の状態を保つ
2026年10月までに、Googleがアプリのデフォルトモデルを非推奨にしていた(提供は2026年6月1日に終了)ため、単純なモデル名の更新に見える作業が必要になりました。ところが連携部分を確認すると、それだけでは済まないことがわかり、作業は本格的な保守リリースになりました。このリリースは、2026年10月9日にマージしてデプロイしました。
現在は、Gemini 3世代のモデルを、現行のSDKの書き方で使っています。選べるモデルは6種類で、デフォルトはGemini 3.8 Flashです。レガシーの2.5モデルも2種類、引き続き利用できます。
特に重要だったのは、信頼性に関する2つの修正です。アプリにはリトライデコレーターがありましたが、調べてみると一度も作動していなかったことがわかりました。現在は、SDK自体のリトライ機能に任せています。また、以前はブロックされたレスポンスで実行がクラッシュしていましたが、今は理由の説明とともに返るようになりました。
画像は、Geminiのファイルストアを経由せず、リクエストにインラインで含めて送るようにしました。これにより、ユーザーのGeminiプロジェクト内のファイルをすべて削除していたクリーンアップ処理もなくなりました。語彙モードで、組み込みの例ページ3枚と学習ページ1枚を使ったテスト実行では、リクエストをGeminiに送るまでのアプリの前処理が約46秒から約2秒に短縮し、リクエストサイズは約90%減りました。
デプロイ済みのバージョンは、37件の自動テストに合格しています。フェイククライアントを使ったオフラインテストと、ヘッドレスUIテストです。リトライとクリーンアップのバグは、フェイククライアントでそれらの失敗パスを実際に通して、初めて表に出ました。
モデルの変更や日付を明記した価格を含む詳細は、『LLMアプリを最新に保つ』にまとめました。作業は、ほかのシステムと同じ進め方で行いました。その進め方は『仕様ファースト、テストファースト』で紹介しています。
かかる費用
実行のたびに、思考トークンを含む使用トークン数と、そのコストを表示します。コストは、価格の改定時期を記録した価格レジストリから算出します。
2026年10月9日に行った有料のスモークテスト(語彙モード、組み込みの例ページ3枚と学習ページ1枚)では、1回の実行のコストは、Gemini 3.8 Flashで約US$0.02(US$0.019〜US$0.024)、Gemini 3.5 Flash-Liteで約US$0.0065でした。OCRの工程はLLMWhispererの無料枠で実行したため、これらの数字はGeminiのトークン料金だけを含みます。GoogleのStandard tierにおけるGemini 3.8 Flashの価格は2027年1月1日に2倍になる予定のため、3.8 Flashの数字はテスト日時点の価格に基づくものです。実際のコストは、モデル、モード、ページの内容によって変わります。
残っている制約
カードをAnkiに取り込む前には、今も人による簡単な確認が必要です。手順5のスキーマ検証で確認できるのは構造だけで、日本語として意味が通るかどうかまではわかりません。
例ページを有効にすると、古いモデルや小さいモデルが、アップロードしたページを読む代わりに、組み込みの例をコピーしてしまうことがあります。Gemini 3シリーズでは、これははるかに起こりにくくなっています。
生成したカードをダウンロード前に編集する機能は、まだありません。対応予定のリストでは、これが次の項目です。
プロジェクトのその他の画像