完了データエンジニアリング · データ分析
配当落ちからの株価回復分析
権利落ち日の後に株価がどのくらいの頻度で回復したか、回復までにどのくらいかかったかを調べるために、共同で構築したデータ基盤とアプリ。
約6分で読めます
ソースコードは非公開ですが、仕組みのご説明やデモのご案内は喜んでいたします。
- 絞り込んだうえで分析したデータセットに含まれる配当銘柄(2024年12月のエクスポート)
- 13,967
- 分析した過去の権利落ちイベント(52の取引所コード)
- 440,953
- 絞り込んだデータセットで、15営業日以内に権利落ち前の終値を回復したイベントの割合(2024年12月までのデータ)
- 63%
- 営業日:絞り込んだデータセットにおける、典型的な銘柄の回復日数の中央値(回復したイベントが対象)
- 4
使用技術
- Python
- pandas
- PostgreSQL
- AWS RDS
- AWS EC2
- AWS Secrets Manager
- Streamlit
- Altair
- Docker
- pgvector
- Voyage AI
- Llama 3.1 70B
問い
権利落ち日には、株式を買っても次回の配当を受け取れなくなるため、株価は通常、その配当額とほぼ同じだけ下落します。数日で値を戻す銘柄もあれば、数か月かかる銘柄や、元の水準まで戻らない銘柄もあります。配当取り(権利落ち日の前に買って配当を受け取り、株価が回復したら売る手法)を検討する人にとって重要な問いは2つです。ある銘柄がどの程度確実に回復するか、そしてどのくらい速く回復するかです。
共同創業者と私は小さな金融分析ベンチャーを立ち上げており、これらの問いに数千銘柄の規模で答えるアプリを構築しました。アプリでは、ユーザーが銘柄をスクリーニングし、企業ごとの回復の履歴を見ることができました。アプリは、権利落ちイベントごとの回復を測定するデータ基盤の上で動いていました。
データ
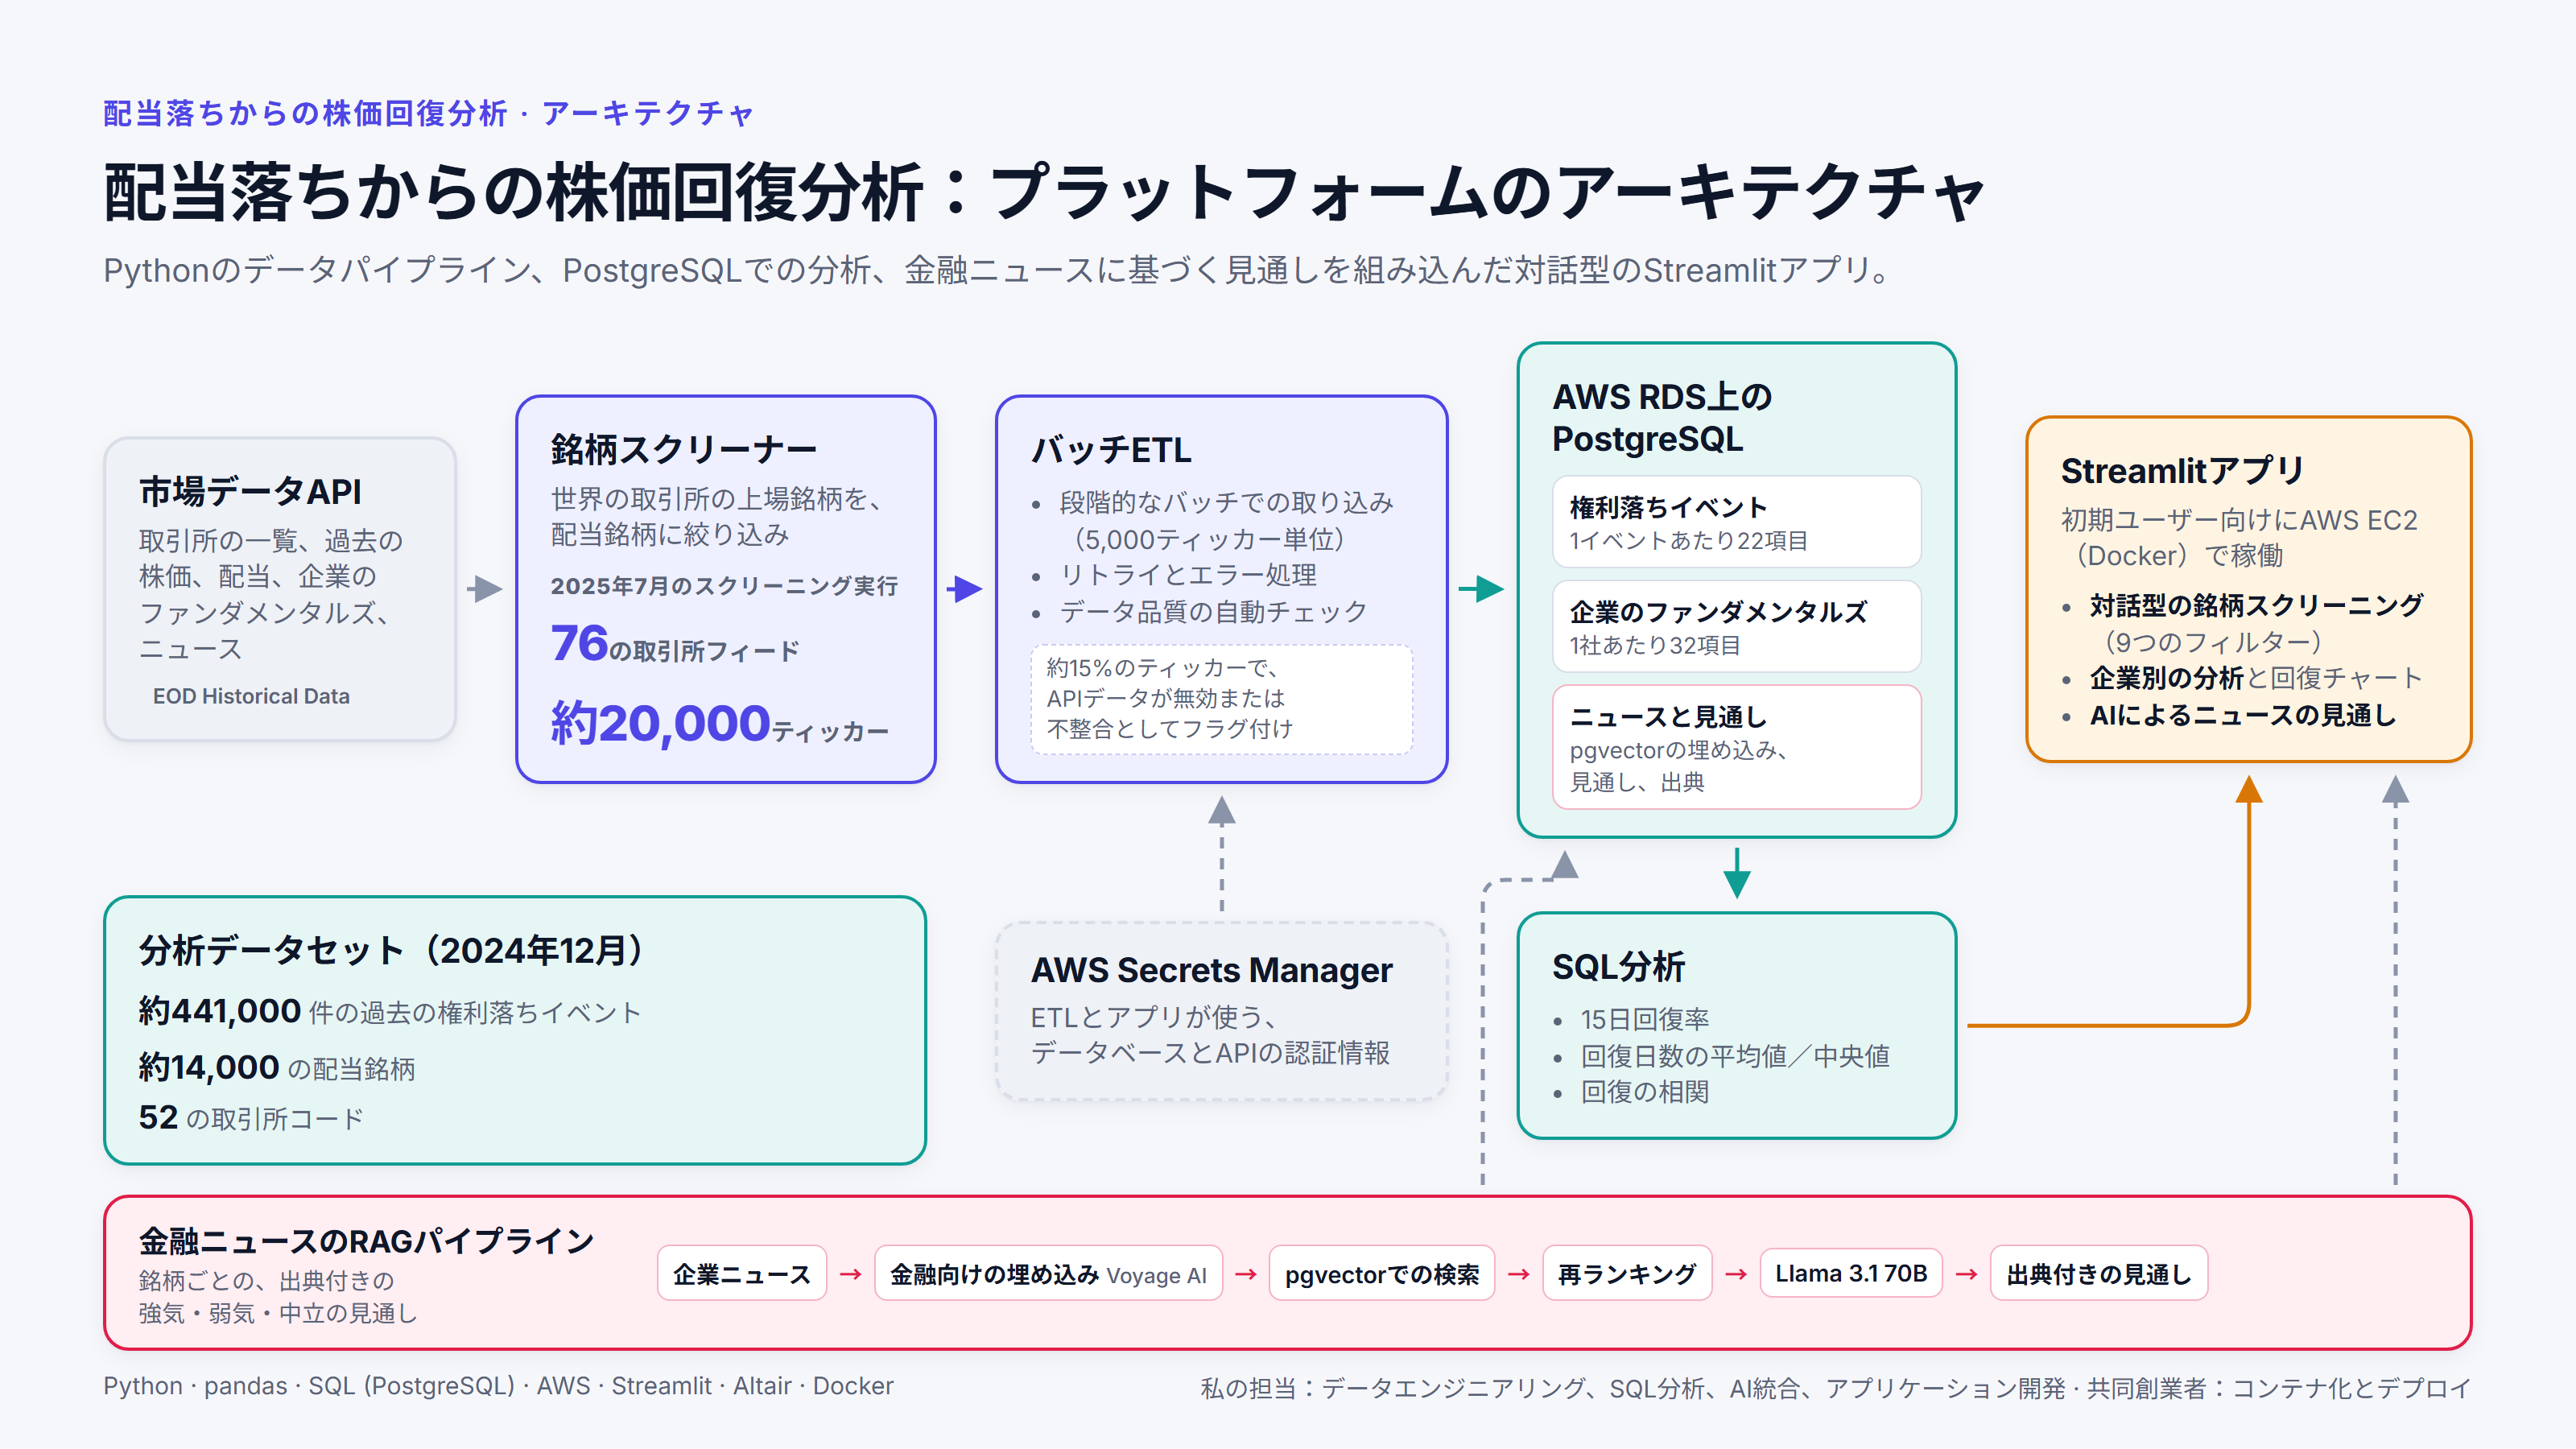
PythonのパイプラインでEOD Historical Data APIから株価、配当、ファンダメンタルズ、企業ニュースのデータを取得しました。
分析データセットは、2024年12月にエクスポートしたものです。52の取引所コードにわたる、配当を出している13,967銘柄と440,953件の権利落ちイベントを含み、各銘柄について、エクスポート時点までに利用できたすべての株価履歴を収めています。履歴がどこまでさかのぼるかは、銘柄によって異なります。これらの銘柄は、分析の対象として私たちが絞り込んだ一部の銘柄であり、以下の分析結果はその範囲にのみ当てはまります。
スクリーニングの数字は、これとは別の、後の段階のものです。2025年7月、本番アプリ用の日次スクリーナーは76の取引所フィードを対象に実行され、最低利回りのフィルターを外すと、19,885のティッカーを抽出しました。
手法と分析結果
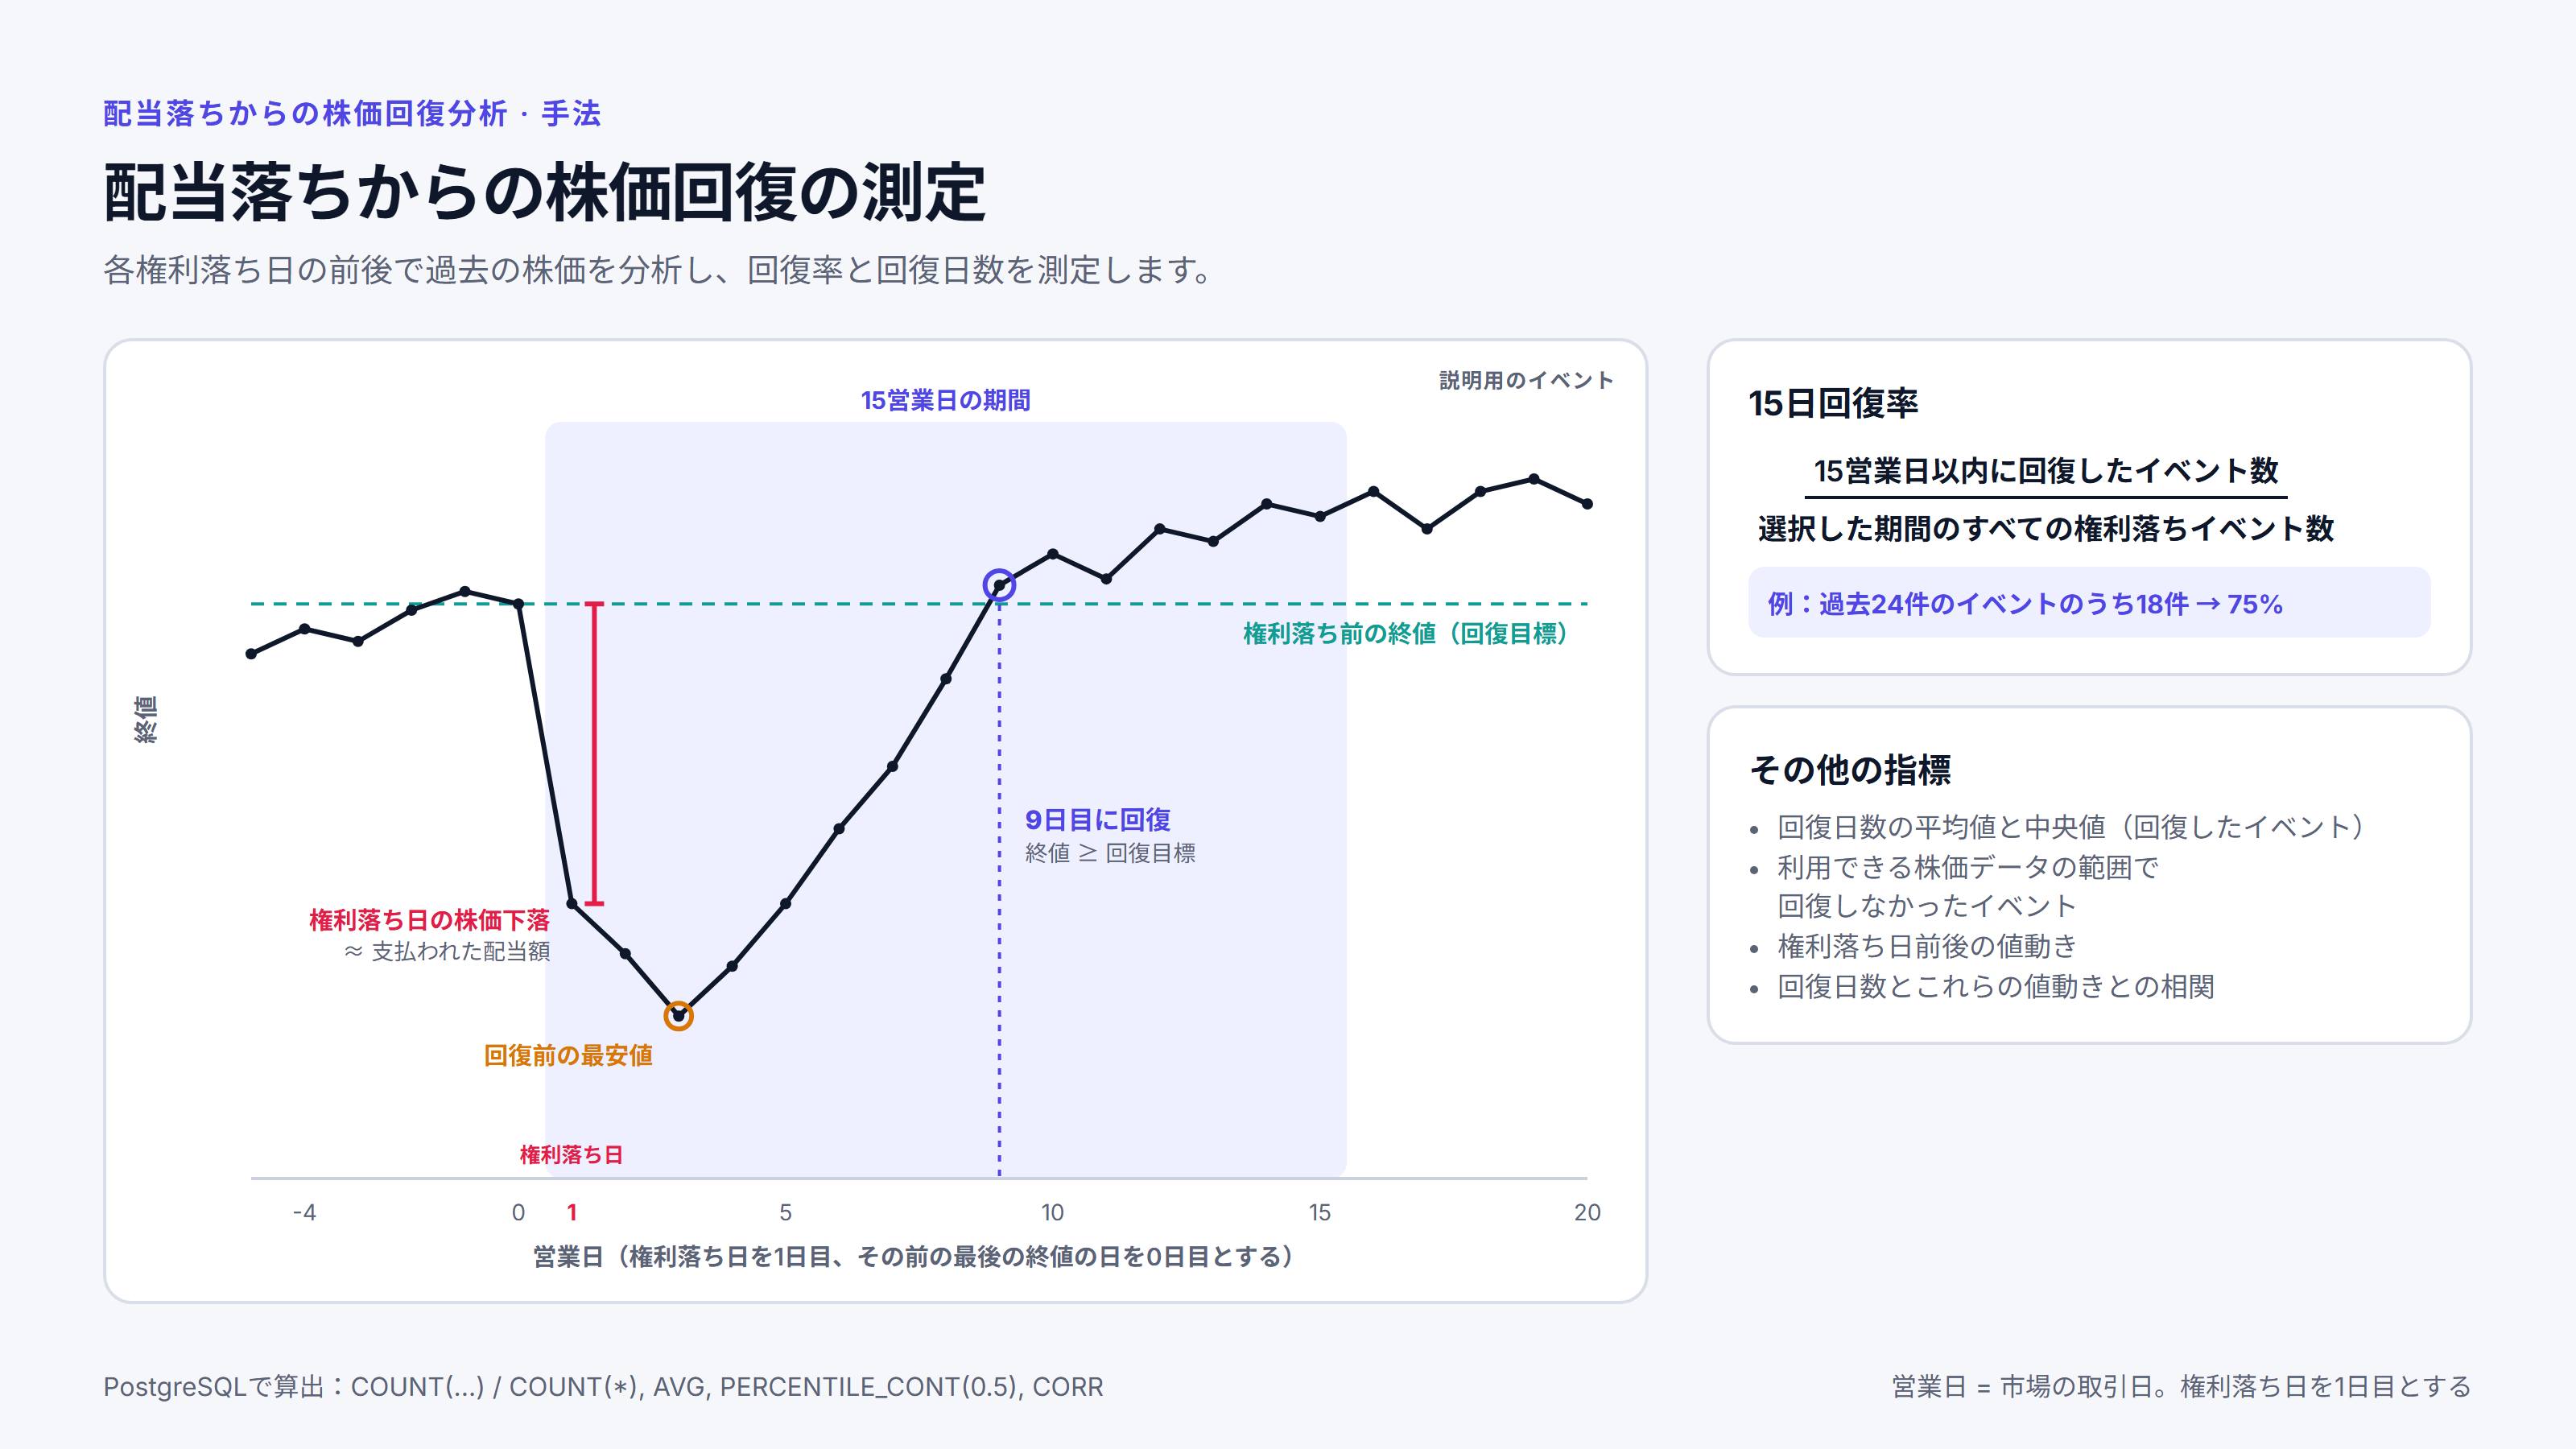
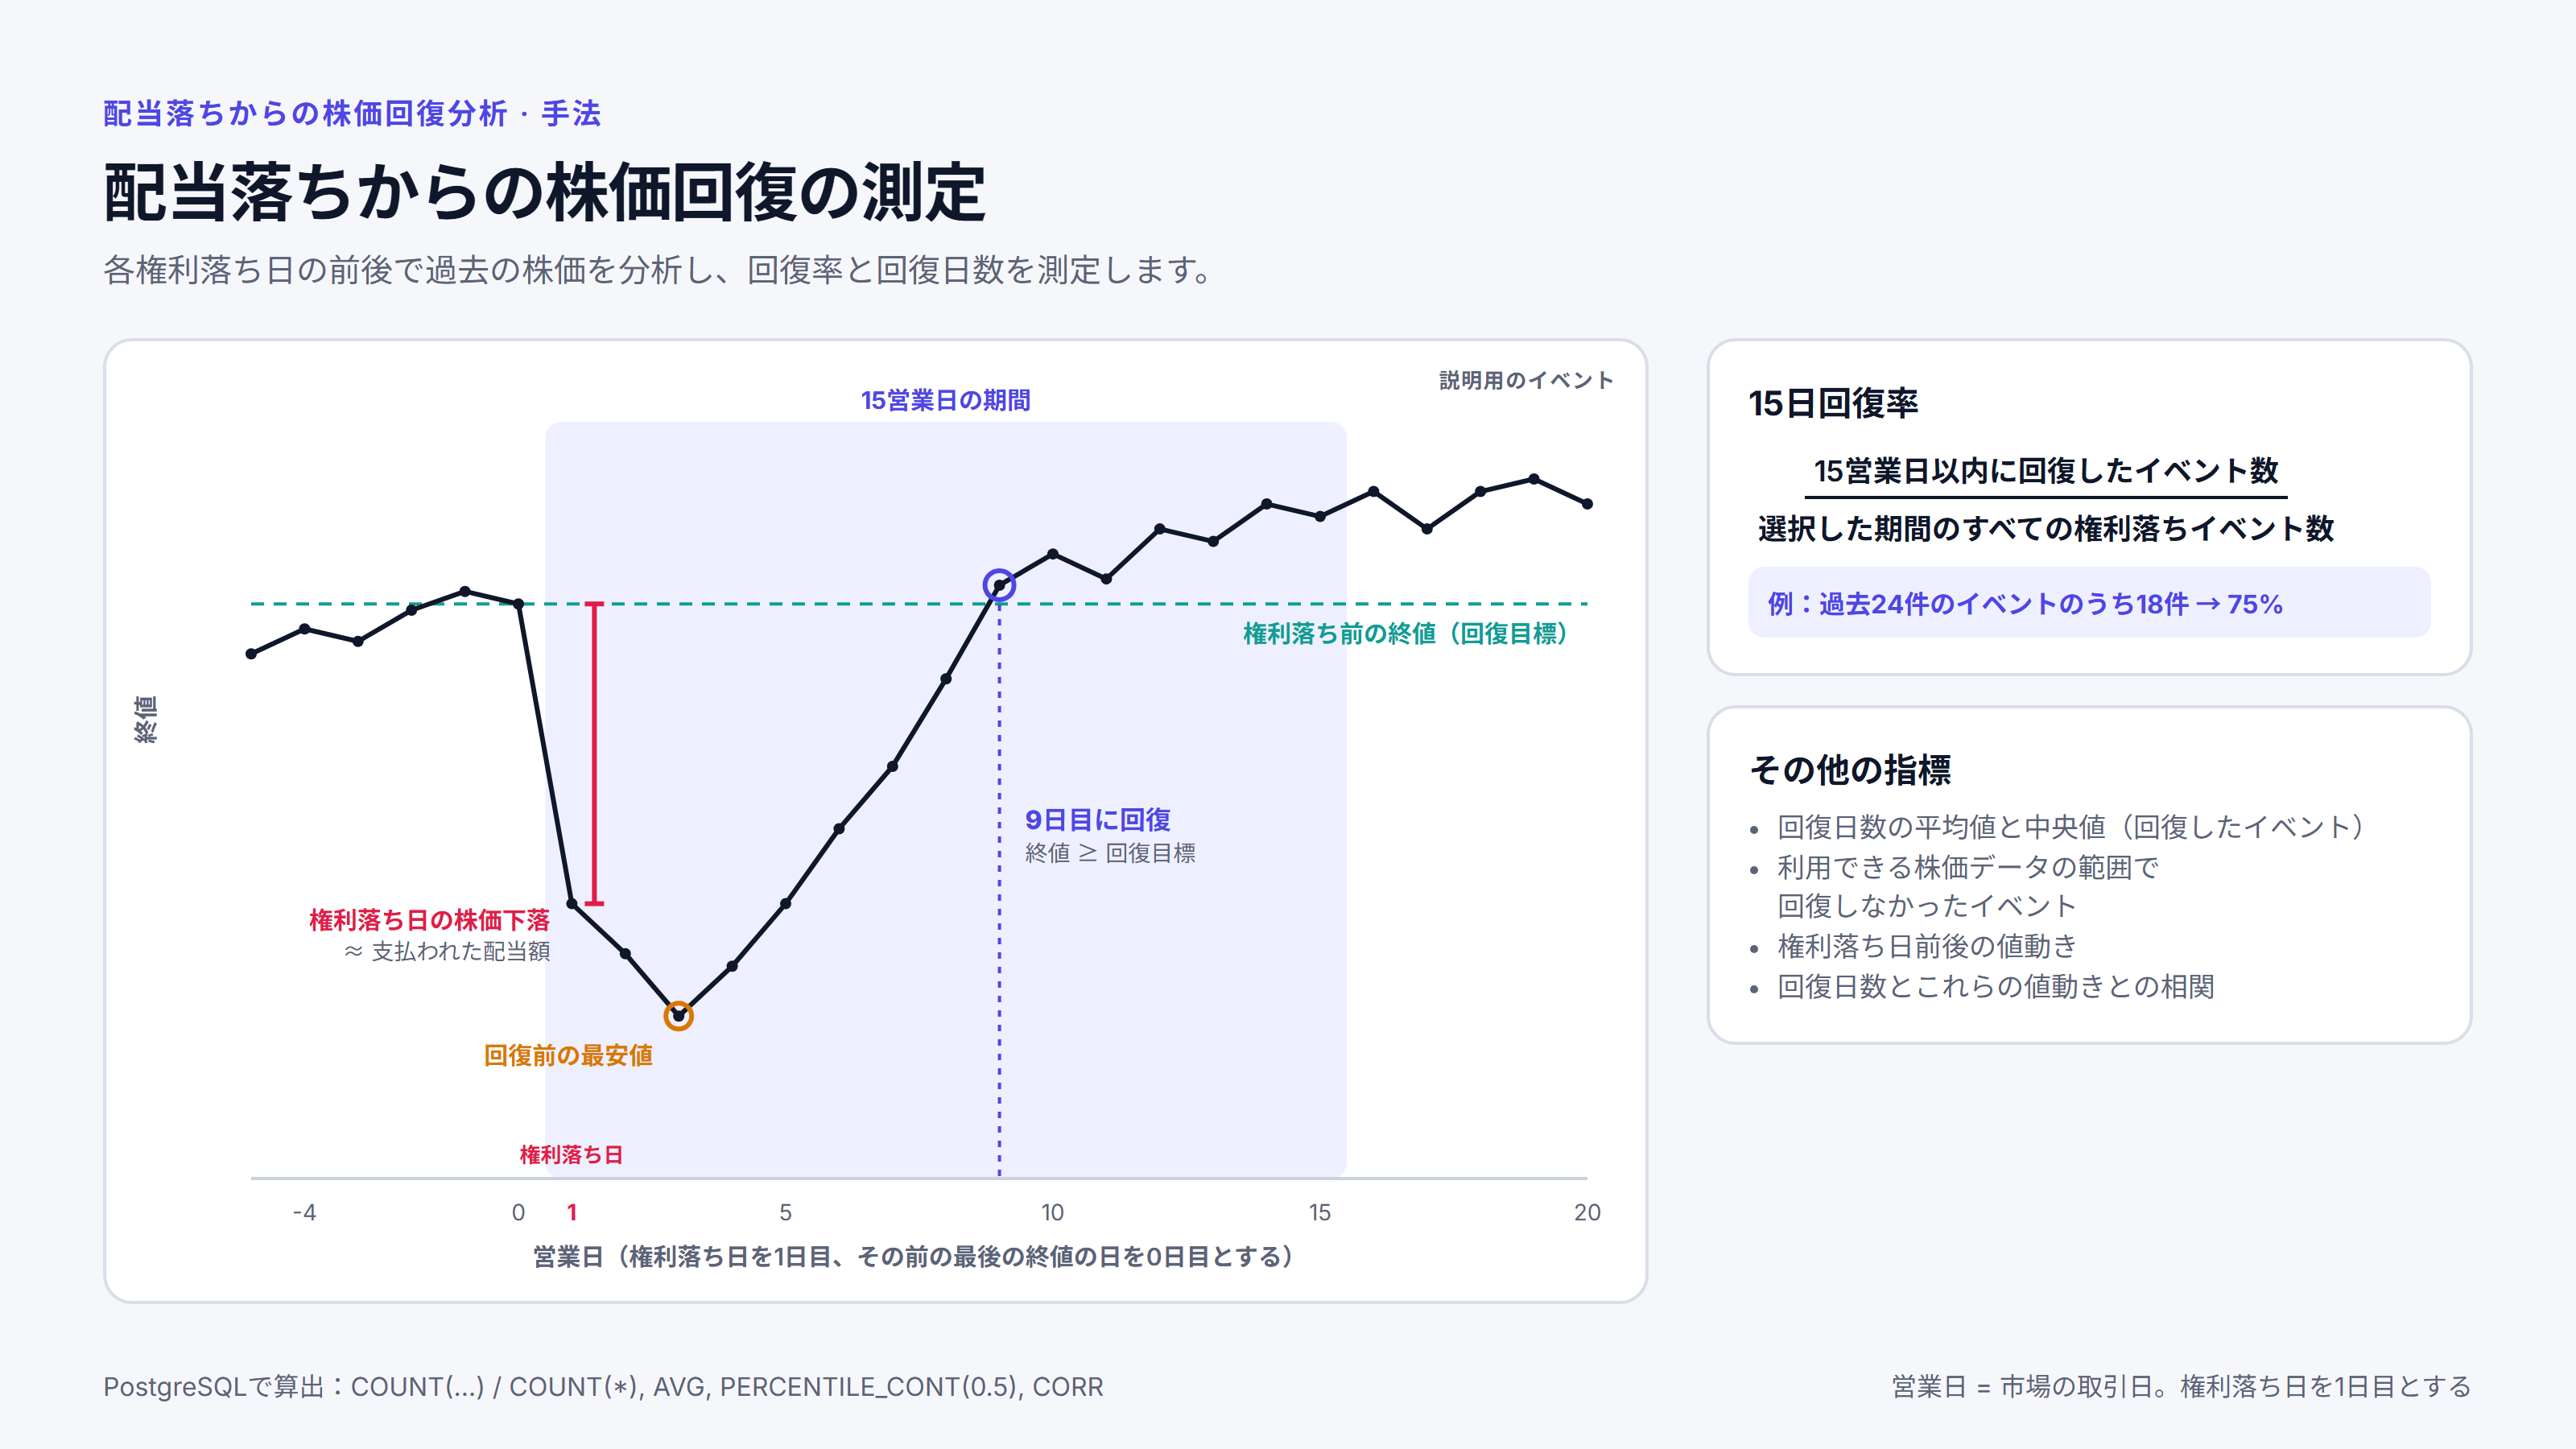
その銘柄の終値が、権利落ち日の前日の終値以上に戻った時点で、そのイベントは回復したとみなします。回復日数は営業日で数え、権利落ち日を1日目とします。
銘柄ごとに、SQLクエリで次の値を算出しました。
- 15日回復率:15営業日以内に回復したイベント数を、選択した期間のすべての権利落ちイベント数で割った値。回復しなかったイベントも分母に残ります
- 回復したイベントを対象とした、回復日数の平均値と中央値
- 回復日数と、権利落ち日前後の値動きとの相関
アプリの数字を検証するため、主要な数字を後に2024年12月のエクスポートから再計算したところ、結果はアプリと一致しました。権利落ちイベントの約63%(63.04%)が15営業日以内に権利落ち前の終値を回復し、13.8%は利用できる株価履歴の範囲内では回復しませんでした。典型的な銘柄の回復日数の中央値は、4営業日でした。この数字は、まず銘柄ごとに、回復したイベントだけを数えて回復日数の中央値を求め、それらの銘柄ごとの中央値の真ん中の値をとったものです。代わりに、どの銘柄のものかを問わず、回復したすべてのイベントをまとめて中央値をとると、3営業日になります。
分布はロングテールのため、平均値は中央値を大きく上回っています。回復しなかったイベントは除外せず、別途追跡しました。これらの数字は、2024年12月までの過去のデータで実際に起きたことを示すものであり、予測や期待リターンではありません。
ユーザーは、9つのインタラクティブなフィルターと、回復チャートを含む企業別のビューを備えたマルチページのStreamlitアプリで、結果を確認できました。アプリはAWS EC2上のDockerで稼働し、初期ユーザーのグループに使ってもらいました。
パイプラインとデータ品質
データパイプラインとSQL分析は、私が設計・構築しました。ETL(抽出・変換・ロード)パイプラインは、APIからデータを取得し、Pythonで変換して、AWS RDS上のPostgreSQLに段階的なバッチでロードしました。認証情報はAWS Secrets Managerで管理していました。エラー処理も組み込みました。失敗した処理はバックオフ(再試行のたびに待ち時間を長くする方法)を使ってリトライし、各実行は進行状況とエラーをログに記録しました。
データは2つのレベルで検証しました。各バッチで自動チェックを行い、さらにデータベースレベルのチェックで欠損値(null)や不一致を探しました。約15%のティッカーで、APIデータが無効または不整合としてフラグが立ちました。これらはログに記録し、以降の実行では処理対象から外しました。
データベースには、権利落ちイベントごとに22項目のレコード、企業ごとに32項目のファンダメンタルズのレコードを保持していました。イベントのレコードには、権利落ち日の株価下落幅、回復までにかかった営業日数、回復前の最安値、権利落ち日前の値動き、52週の値幅などが含まれていました。更新は増分方式で、保存済みの最新日付より新しいイベントだけをロードしました。以降の実行では、まだ回復していなかった過去のイベントも再確認し、回復した時点でそのレコードを更新しました。この処理がなければ、最初にロードした時点で回復していなかったイベントは、未回復として記録されたままになっていたはずです。
エラー処理とチェックを強化した後、本番のETLパイプラインは13回連続で、未処理のエラーなく実行されました。
金融ニュースに基づく見通し (RAG)
2024年からは、検索拡張生成 (RAG) のパイプラインも基盤に組み込みました。ここでのRAGは、関連するニュース記事を検索し、質問と一緒に言語モデルに渡すことで、それらの記事に基づいた回答を得るというものでした。目的は、銘柄ごとに、ニュースに基づく短い見通しを示すことでした。
- 企業ニュースは同じ市場データAPIから取得して増分で追加したため、蓄積される記事は時間とともに増えていきました
- 記事はチャンクに分割し、Voyage AIの金融向けモデルで埋め込みを作成して、pgvectorで同じPostgreSQLデータベースに格納しました
- 銘柄ごとに、関連度の最も高いチャンクを検索し、再ランキングしました
- Llama 3.1 70Bに強気・弱気・中立のいずれかの見通しを生成させ、参照した記事を出典として保存しました
見通しはアプリの実験版でユーザーに表示しており、メインのアプリへの展開が次に予定していたステップでした。これはニュースに基づく見解であり、目標株価や売買の助言ではありません。
2人のチーム
データパイプラインと分析、RAGパイプライン、そしてデータとアプリケーションのコードの大部分は、私が構築しました。コンテナ化とデプロイは、共同創業者が担当しました。
次に取り組みたいこと
このプロジェクトを再開するなら、Streamlitのプロトタイプに代わる本格的なWebアプリケーションとしてメインのアプリを作り直し、ニュースの見通しを実験版からそこに移します。また、データ品質レポートをデータと一緒に公開します。
プロジェクトのその他の画像