開発ログ
長時間のタスクを担うAIエージェントのためのプラットフォーム:アーキテクチャとロードマップ
AIエージェントのためのプラットフォームの初期設計:永続的なタスク、ローカルとクラウドでの実行、権限、そして最初に計画しているアプリケーションについて。
 執筆 ロナク・ゾエブ
公開 更新 約20分で読めます
共同開発者とともに、タスクを実行し、小さなアプリケーションを保守できるAIエージェントのためのプラットフォームに取り組んでいます。初期設計では、ローカルとクラウドでの実行、権限、永続的な状態を扱っています。この記事では、これまでに決めた設計上の選択と、最初に作る予定のものを説明します。
構想しているのは、ローカル、クラウド、またはその両方で動作し、1回きりのチャットではなく、より長時間にわたる仕事を引き受けられるパーソナルAIアシスタントです。たとえば、毎週のリサーチの要約、受信箱の監視、あるいはエージェントが作成して最新の状態に保つ、技術文書を管理するための小さなアプリなどです。仮称はAI App Builderです。
ステータス(2026年10月): 初期設計の草案はできており、コアは開発の初期段階です。プラットフォームは、私の既存のエージェントフレームワークであるdoc-processing-toolkitと、ツールライブラリであるdoc-processing-std-toolsを基盤にしています。
最初のワークフロー:文書台帳
エンジニアリングのプロジェクトにおける文書台帳 (document register) とは、図面、仕様書、報告書といったプロジェクトの文書を、番号、改訂、ステータスとともにまとめ、随時更新していく一覧です。これが、最初に構築する予定の専門的なアプリケーションです。
台帳は、エンジニアリング情報管理の一部です。エンジニアリング情報管理とは、プラントなどの資産に関する情報を、設計・建設から運用に至るまで、正確で、漏れがなく、追跡可能な状態に保つことです。大規模なプロジェクトでは数千もの文書が作られ、その多くが何度も改訂されます。台帳が文書の更新に追いつかなくなると、どの文書が欠けているのか、遅れているのか、置き換えられたのかがわからなくなります。これが最も重要になるのは引き渡しの時点で、請負者は、必要な文書がすべて納品されたことを示さなければなりません。
この作業の多くは、今も手作業で行われています。情報は、文書管理システム、多数のスプレッドシート、共有ドライブ、メールに分散しています。文書番号や改訂は、図面の表題欄、表紙、ファイル名に記載されており、台帳のレイアウトもプロジェクトごとに異なります。文書管理システムのベンダーが追加してきたAI機能は、主に自社製品の中にあるデータを対象としています。そのため、スプレッドシートの台帳を文書と一致させておく作業は、今も人が行う事務作業です。
ChatGPTやClaudeのような汎用のAIアシスタントは、チャットの中でいくつかの文書を読み、それについての質問に答えることができます。台帳に求められるのは、それ以上のことです。1回の会話に収まる量を超える文書を扱い、新しい改訂が届くたびに、プロジェクトの期間を通じて最新の状態に保ち、すべての値を出典までたどれるようにしなければなりません。また、多くのプロジェクトでは、文書をクライアント自身のシステムの外に出すことができません。
計画では、エージェントにプロジェクト文書のフォルダを渡し、そこから台帳アプリケーションを構築させます。マスター文書台帳、送付台帳(トランスミッタル台帳:何を、誰に、いつ送ったか)、引き渡し用のビューは、いずれもその1つのアプリケーションの設定違いとして扱う想定です。AIが入力する各項目には、値、信頼度スコア、出典箇所を開く引用を付ける予定です。信頼度の低い行はレビューキューに回し、修正内容は学習データとして保存する計画です。
そのために必要なものの大半は、モデルの周りのソフトウェアにあります。設計では、各文書を一度だけ解析して、ページと位置の情報を保持した番号付きのブロックに分け、エージェントはそれを1バッチずつ処理していきます。そのため、文書一式の規模が、モデルが一度に取り込めるテキストの量(コンテキストウィンドウ)によって制限されることはありません。各ステップでモデルのコンテキストに何をどのような形で入れるかを選ぶことを、コンテキストエンジニアリングと呼びます。ここでモデルが目にするのは、処理中のブロック、台帳の列、プロジェクトの採番ルールで、それ以外はほとんどありません。モデルが返す各値はブロックを指しているので、モデルに出典を引用させなくても、引用からページ上の正確な位置にたどり着けます。変更のない文書は読み直しません。ステップごとに異なるモデルを使うことができ、タスクを始める前に、プラットフォームがプロジェクトの文書をどのモデルに送ってよいかを確認します。
この1つのワークフローに、プラットフォームが提供しようとしている機能の大半が必要になります。そのため、設計を試すのに適しています。
- 台帳は多数の文書にまたがって構築され、常に最新の状態に保つ必要があります。つまり、中断に耐え、止まったところから再開しなければならない長時間のタスクです。
- できあがるのは、独自のデータ、インターフェース、バージョン履歴を持つアプリケーションで、人がそれを確認し、修正します。
- 最新の状態に保つには、新しい文書が届いたことに気づく必要があります。しかも、確認のために数分ごとにモデルを呼び出して費用をかけることなく、です。
- プロジェクト文書を扱うため、権限と承認が重要です。また、モデルの呼び出しにはそれぞれコストがかかり、それを記録する必要があります。
その後のワークフロー
台帳の次には、バックグラウンドで動き続けるワークフローを追加する予定です。
- フォルダ、Webサイト、データフィード、実行中のプロセスを監視し、意味のある変化があったときに対応する
- 受信箱を監視し、届いたものを仕分けて、人が承認するための返信の下書きを作る
- より長時間にわたるメールのタスク(エージェントに文書を転送すると、確信が持てない点があればエージェントがメールで質問し、返信を受けて作業を続ける)
汎用のアシスタントも、すでに定期実行のタスクや他のツールとのコネクタを提供しています。AI App Builderでは、これらのワークフローはそれぞれ、独自の履歴、権限、コストの記録を持つ永続的なタスクであり、その結果を、人が確認するアプリケーションに入れることができます。モニターは何かが変化したときにだけモデルを呼び出し、その変化に必要なコンテキストだけをモデルに渡します。
現状
ロードマップ上は、段階1(初期設計とアーキテクチャ)が現在の段階で、次が段階2(コアエージェントフレームワークとセキュリティ)です。最初のリリースまで、コードは非公開にしておく予定です。
エージェントループには、私が自作したフレームワークであるdoc-processing-toolkitと、その関連ツールライブラリであるdoc-processing-std-toolsを使います。AI App Builderは、この2つの上に、より汎用的なプラットフォームを構築するものです。フレームワークは内部インターフェースの背後に置いており、このインターフェースは後から拡張することも、置き換えることもできます(これについては「未解決の課題」で詳しく触れます)。
私の他のプロジェクトと同様に、実装の大部分はコーディングエージェントが行い、私は方向性を定め、レビューし、最終的な承認をします(その仕組みは『仕様ファースト、テストファースト』で紹介しています)。リポジトリは、エージェントがそこから直接作業できるように整備しているところです。リポジトリ内の知識を記録の正本とし、アーキテクチャのルールは機械的に強制します。具体的には、短いマップファイル、信頼できる情報源としてのdocs/フォルダ、そしてコードの横にチェックインした計画です。将来的には、エージェントがタスクボードから自らタスクを引き受け、プルリクエストを作成し、互いの作業をレビューできるようにしたいと考えています。OpenAIがハーネスエンジニアリングについての記事で説明している形に沿ったものです。
タスクとアプリケーション
言語モデルは、車のエンジンのようなものです。動力を生み出しますが、それだけでは誰をどこへも連れて行けません。その動力をどう使うかを決めるのは、車のほかの部分です。ハンドルとブレーキ、燃料系統、何が起きているかを運転者に伝える計器類、そして何か問題が起きたときに重要になる安全装置です。AIエージェントにとって、この車のほかの部分にあたるのがハーネスです。エージェントが使えるツール、保持する記憶、その範囲内で動く権限、出力に対するチェック、そして人がエージェントを操るためのインターフェースです。
ブレーキの弱い車にもっと強力なエンジンを積んでも、運転が安全になるわけではありません。同じように、より強力なモデルの上に構築したエージェントも、それを方向付けてチェックできるハーネスがなければ、より役に立つことはありません。AI App Builderでの私たちの作業の大半は、ハーネスに関するものです。新しいエンジンは数か月ごとに登場するため、車は作り直すことなく、より強力なエンジンを積めなければなりません。プロバイダー層によってモデルを変更でき、ツール、権限、チェック、コストの上限は、どのエンジンを積んでもそのまま残ります。
設計の中心には、2つの考え方があります。永続的なタスクと、エージェントが作るアプリケーションです。
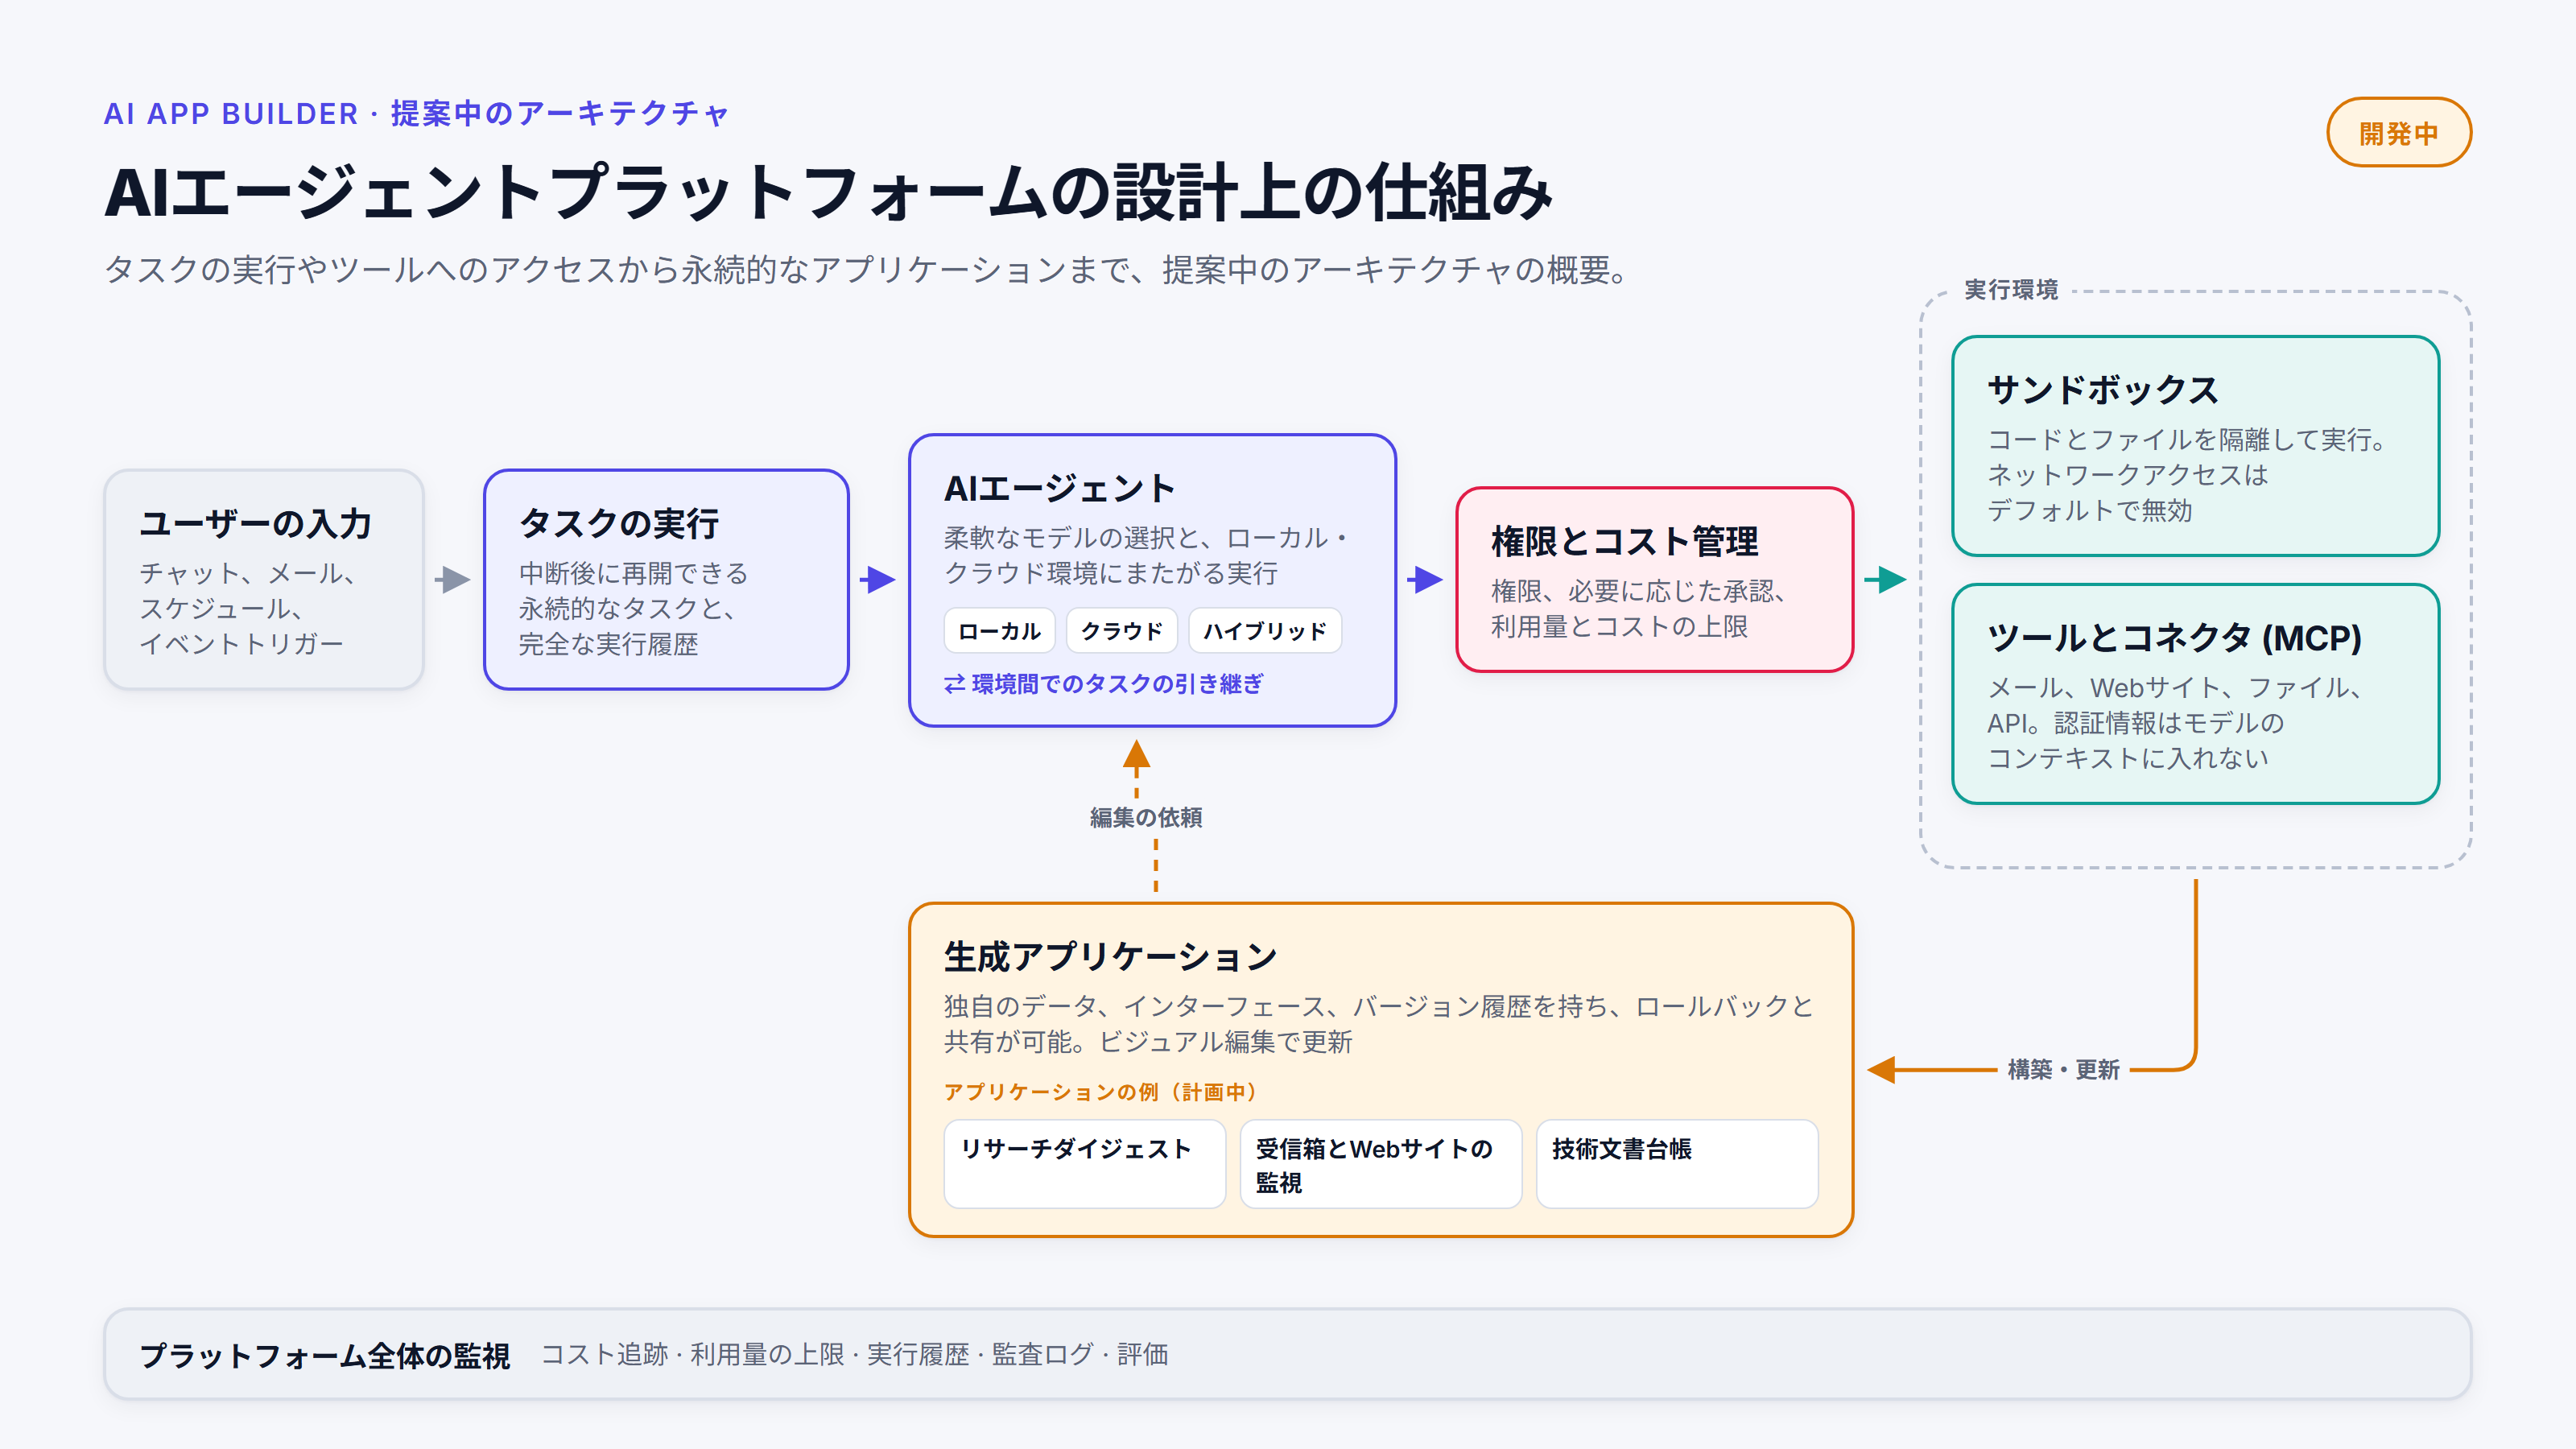
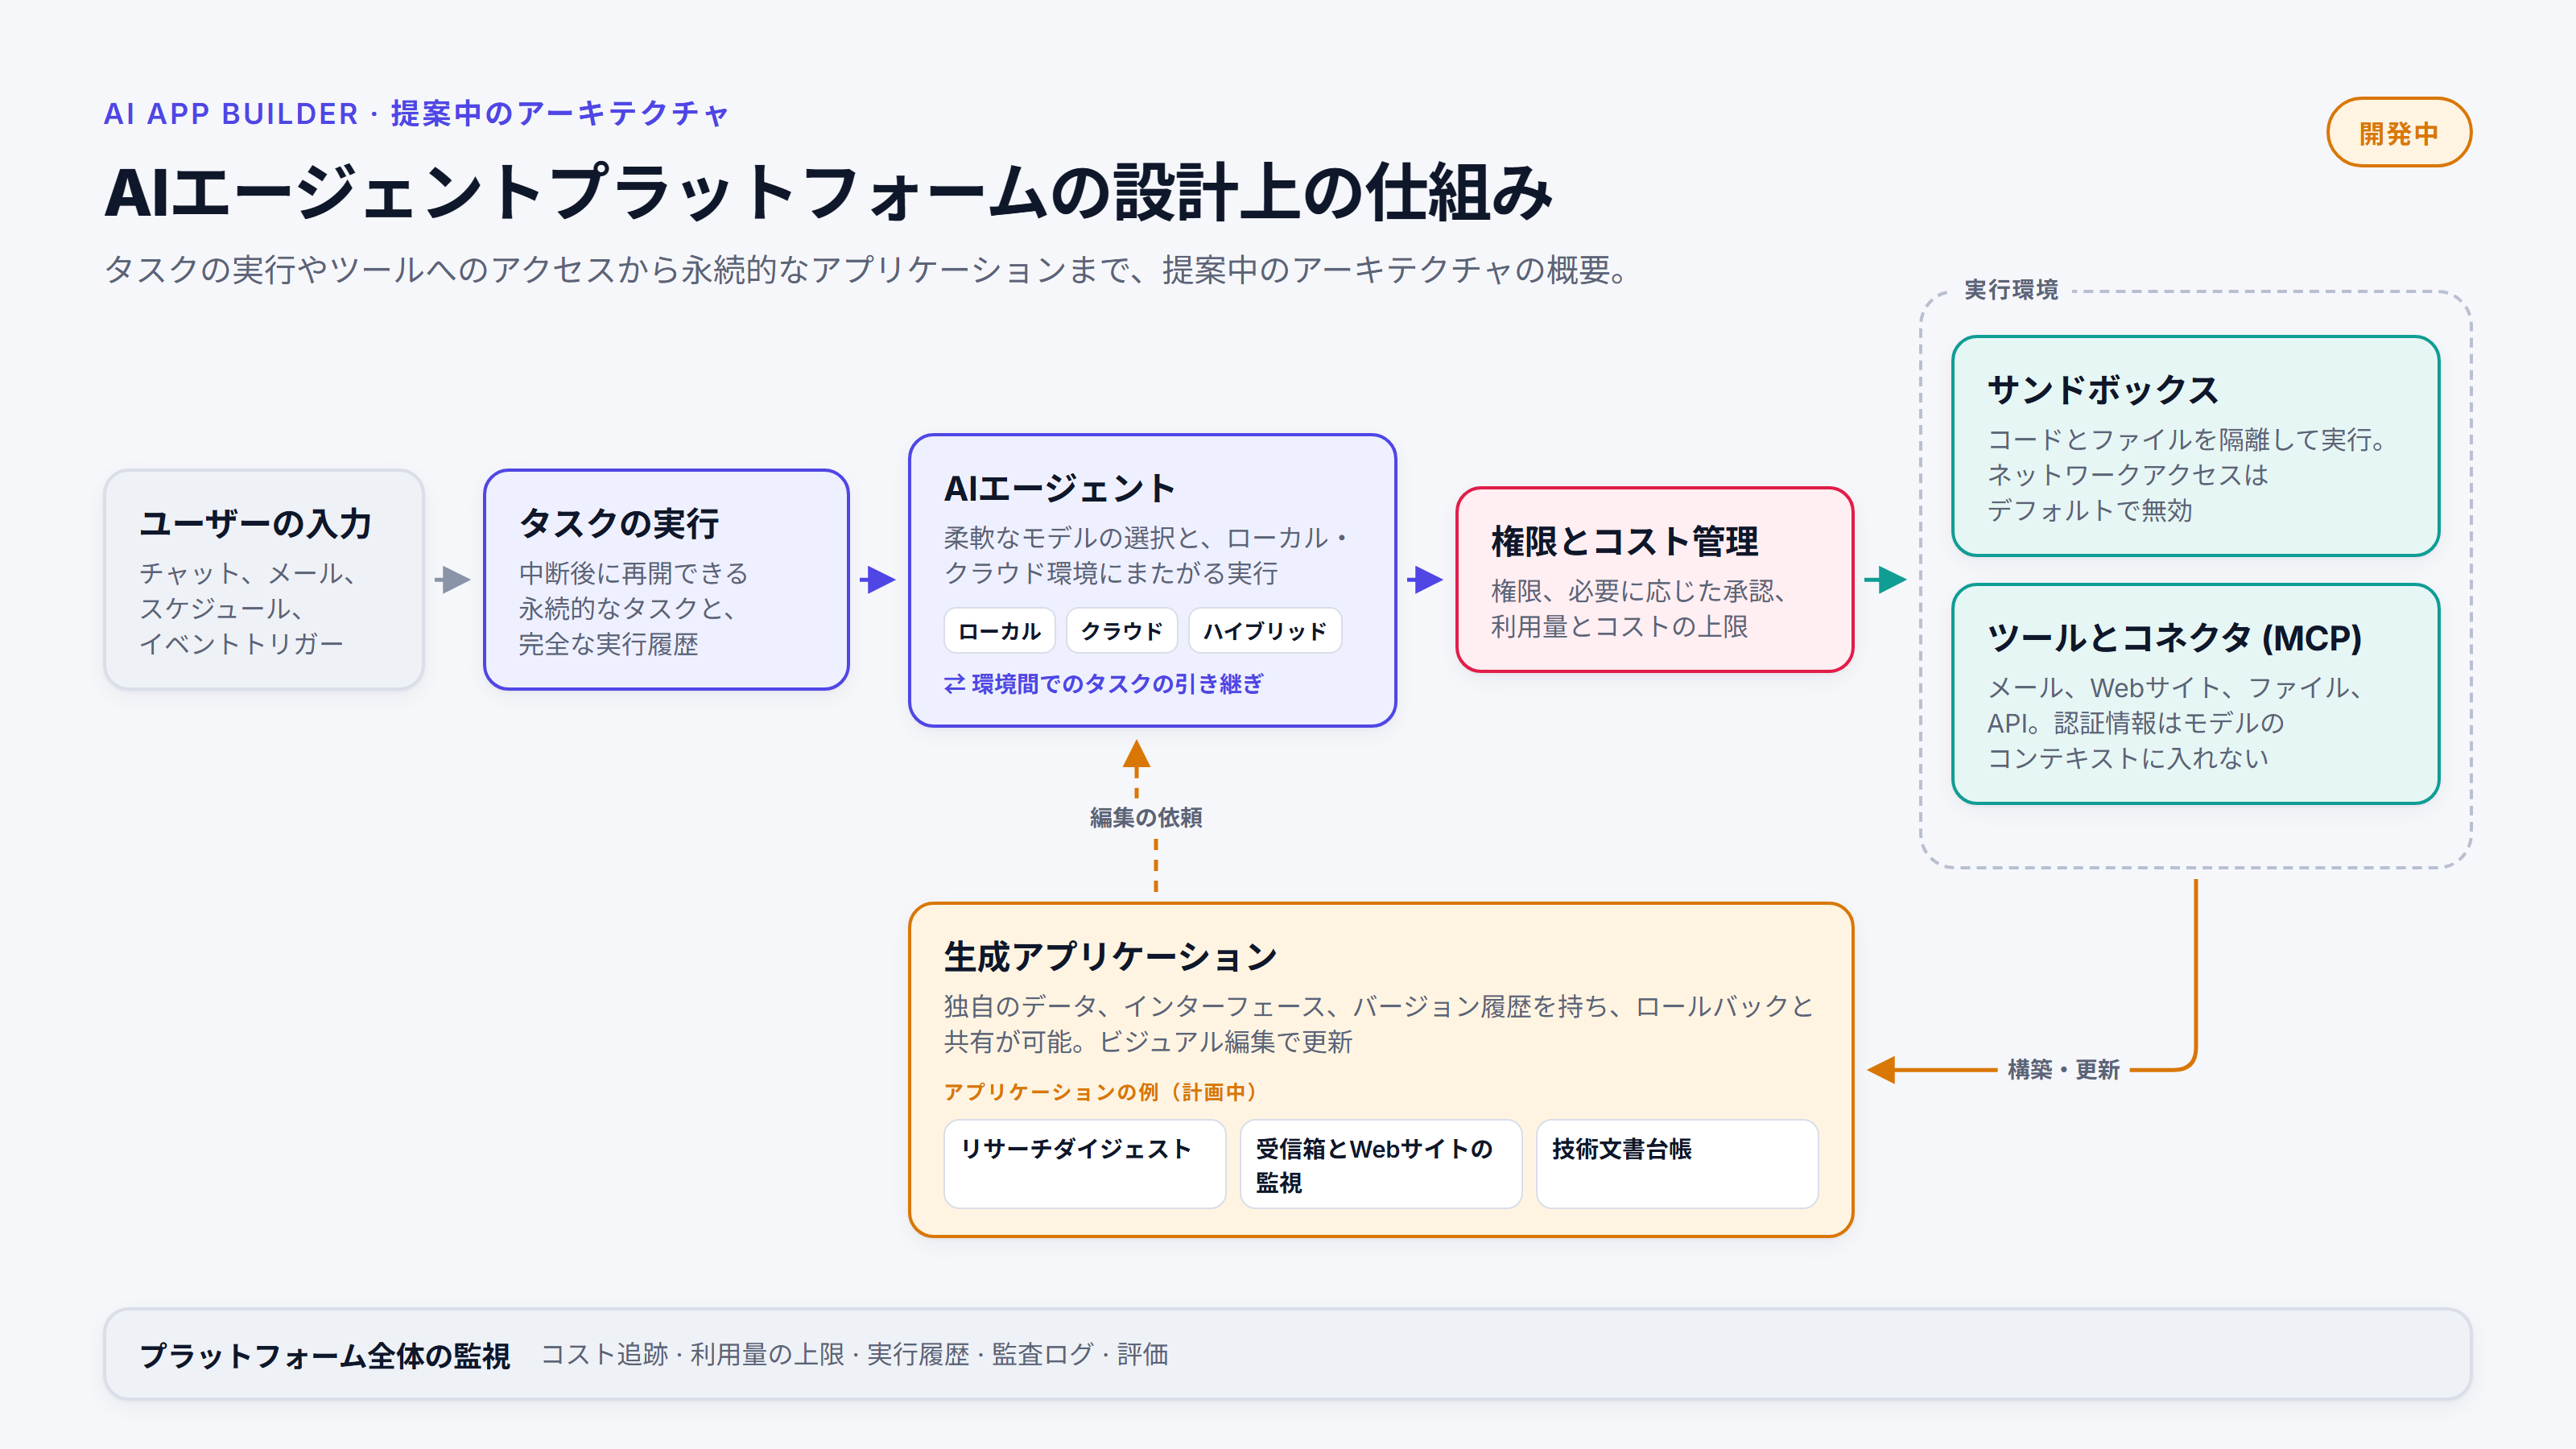
タスクとは、プラットフォームがユーザーのために実行するあらゆる作業のことです。チャット、毎週のリサーチ要約のような定期実行のエージェント、フォルダを監視するモニター、メールのスレッドは、すべて同じ種類のオブジェクトです。そのため、記録、チェックポイント、再開の仕組みがすべてに同じように適用されます。タスクに関するあらゆる事実は1つのイベントログに記録され、それが唯一の信頼できる情報源になります。
実行は、永続的 (durable) になるように設計しています。永続的なワークフローのためのライブラリであるDBOSを、ローカルではSQLite上で、クラウドではPostgres上で使う計画です。エージェントの各ステップがチェックポイントになるため、中断されたタスクは最後に完了したステップから再開します。その代わり、途中で中断されたステップは、そのステップの最初からやり直しになります。無人で進むタスクが人の承認を必要とするときは、その依頼をレコードとして保存するため、待っている間もメモリ上で何かを動かし続ける必要はありません。
アプリケーションとは、エージェントがユーザーのために作り、保持するものです。独自のデータ、インターフェース、バージョン履歴を持ち、編集や共有もできます。エージェントは、権限で許された範囲内で、ユーザーのマシン上またはクラウド上(たとえばAWS上)に、アプリケーションのためのストレージを作成することもできます。リサーチダイジェストのようなシンプルなツールから、文書台帳のような専門的なものまでを想定しています。設計では、すべての機能を次の3種類のいずれかに分類します。
- プラットフォームの小さなコア機能
- 薄く取り外し可能なケイパビリティパック(メール、音声、文書台帳など)
- エージェントが作るアプリケーション
CRM(顧客関係管理ツール)、学習ヘルパー、台帳トラッカーは、アプリケーションとして作ることを想定しています。エージェントがそのどれかを作れない場合は、専用のプラットフォームコードを追加するのではなく、コアを改善する方針です。特別扱いのコードを足すと、足りない部分が見えなくなってしまうからです。機能の提案をレビューするときにはこれをチェック項目として使い、プロダクト本来の目的から外れないようにしています。できることの幅は、エージェントが作るアプリケーションから生まれるようにし、プラットフォーム自体は小さく保つ考えです。プラットフォームに特別扱いのケースを1つ加えるたびに、それ専用のストレージ、インターフェース、障害の起こり方が加わり、2人で保守しなければならないものが増えます。
アプリケーションのインターフェースの作り方
生成UI (generative UI) では、モデルがコンテンツだけでなくインターフェースも生成します。大まかに3つの種類があります。
- モデルが選ぶ、あらかじめ用意されたコンポーネント。 カード、フォーム、グラフは開発者が作り、モデルはどれを表示するかを決めて、そこにデータを入れます。安全で一貫性がありますが、誰かが事前に想定したものに限られます。
- モデルが記述するインターフェース。 モデルが、既知のコンポーネントを並べたJSONのレイアウトのような構造化された記述を書き、アプリケーションがそれを描画します。より柔軟ですが、それでもコンポーネントの範囲に限られます。
- モデルが書くインターフェース。 モデルがHTML、CSS、JavaScriptとしてインターフェースそのものを書き、それがサンドボックスの中で動作します。どんなインターフェースでも作れますが、一貫性、アクセシビリティ、安全性を保つのは3つの中で最も難しくなります。
Googleの生成UIの研究やClaudeのアーティファクト (artifacts) など、3つ目の種類の例の多くは、1つの回答のためにインターフェースを作るものです。AI App Builderでは、アプリケーションは保持され、バージョン管理され、共有され、そのエージェントによって何か月にもわたって保守されます。そのため、インターフェースは長く使えるものでなければなりません。
AI App Builderは、3つ目の種類、つまり完全な生成UIを前提に設計しています。アプリケーションのインターフェースは、そのアプリケーションを作るエージェントが書くもので、決まった部品の組み合わせから作るのではなく、タスクに必要などんな形にもなれます。それでも、表、グラフ、フォーム、文書ビューアー、引用ビューアーなど、信頼できるコンポーネントを12個ほど用意します。現在のモデルはそれらを使ったほうが良い仕事をし、小さな編集も低コストで済むからです。これらは、今のエンジンにとっての運転支援機能のような役割を果たし、モデルが進歩していく間も品質を保ちます。新しいモデルがリリースされるたびに、評価で同じ編集タスクを再実行し、その支援がまだどれだけ必要かを確認します。ハーネスのほかの部分と同様に、私たちは今よりも高性能なエンジンを見据えて車を作っています。
完全な生成UIは、プラットフォームにレンダラー以上のものを求めます。
- 各アプリケーションは、サンドボックス化された専用のオリジンで動作します。
- すべてのバージョンを保持するので、まずい編集も1ステップで元に戻せます。
- インターフェースの一部を指し示して、変更を依頼できます。
- 変更を保存する前に、プラットフォームが3つの画面サイズで描画し、エラー、アクセシビリティの問題、アプリケーションに許可されていない呼び出しがないかをチェックします。
設計では、アプリケーションどうし、そしてアプリケーションとプラットフォームを互いに隔離します。各アプリケーションは別ドメイン上に専用のオリジンを持ち、厳格なコンテンツセキュリティポリシーを適用した、サンドボックス化されたiframeの中で動作します。プラットフォームにアクセスできるのは、MCP Appsをモデルにしたメッセージブリッジ経由のみです。(MCPはModel Context Protocolの略で、AIモデルをツールやデータに接続するためのオープン標準です。MCP Appsは、それを対話型のインターフェースに拡張したものです。)アプリケーションはAPIキーを保持せず、閲覧しているユーザーの権限で動作し、アプリケーションが行う有料の呼び出しは計測されます。すべてを1つのページで動かすよりもアプリケーションごとの準備は増えますが、不具合のあるアプリケーションや悪意のあるアプリケーションを、他のアプリケーションやユーザーの認証情報に近づけないことが狙いです。
バージョンは追記のみなので、変更を元に戻すには、以前のバージョンを指し直すだけで済みます。バージョン履歴を後回しにすることも検討しましたが、使い勝手を大きく左右する主要な機能なので、最初から組み込みます。
ローカル、クラウド、ハイブリッド
このプラットフォームは、3つの形で動作するように設計しています。ユーザーのマシン上でローカルまたはホスト型のモデルを使って動かすローカル、クラウド、そして1つのタスクがローカルとクラウドの両方のリソースを使うハイブリッドです。タスクごとに異なるAIモデルを使い分けられる設計です。
目標は、意味のある場面でタスクを環境間で引き継げるようにすることです。たとえば、ノートPCで始めた作業をクラウドで続けるといった使い方です。設計では、1つのタスクを担当する環境は常に1つだけです。引き継ぎはステップの途中ではなく、エージェントのステップとステップの間、つまり復旧に使うのと同じチェックポイントで行います。その代わり、引き継ぎは実行中のステップが終わるまで待つことになります。当面、処理の移行はチェックポイントで行います。実行中の任意の処理を移行することは、後で検討する課題です。
権限とコスト
設計では、ツール呼び出しの手前にポリシー層を置きます。ポリシー層は、各呼び出しをリスクとコンテキストに応じて確認し、許可するか、拒否するか、人に承認を求めるかを決めます。フェイルクローズ方式で、判断できない場合、その呼び出しは実行されません。リスクの低い読み取りはそのまま通り、リスクのある操作は人の判断を待つことになります。設計のその他の要素は次のとおりです。
- ファイルやコードを扱うツールはサンドボックスの中で動作し、外部へのネットワーク通信はデフォルトで無効にします。
- モデルにはシークレットの代わりにプレースホルダーを見せ、送信プロキシ (outbound proxy) が実際の値に差し替えます。これにより、認証情報がモデルのコンテキストに入らないようにします。
- 予算ガードが、各呼び出しの前に金額を確保し、呼び出しの後に精算します。
段階2では、これらをエージェントランタイムと並行して構築し、サンドボックスと権限チェックなしではどのエージェントも動かないようにする予定です。
コスト追跡は、最初から設計に組み込んでいます。APIリクエストごとに使用量を1行記録し、リクエストの時点の価格で計算して、後から再計算はしない設計です。そのため、過去の実行は、課金された時点のコストのまま残ります。リトライもそれ自体が1つのリクエストなので、専用の行を持ちます。タイムアウトしたリクエストやリトライがコストログから漏れていたときに何が起きたかは、『6倍の乖離』に書きました。トレースはデバッグ用、台帳はお金の管理用、そしてハッシュチェーン化したログ(各エントリーが直前のエントリーのハッシュを含むログ)は監査用です。当初は、どのユーザーにも自分のモデルのAPIキーを持ち込んでもらう形を想定しています。
ロードマップ
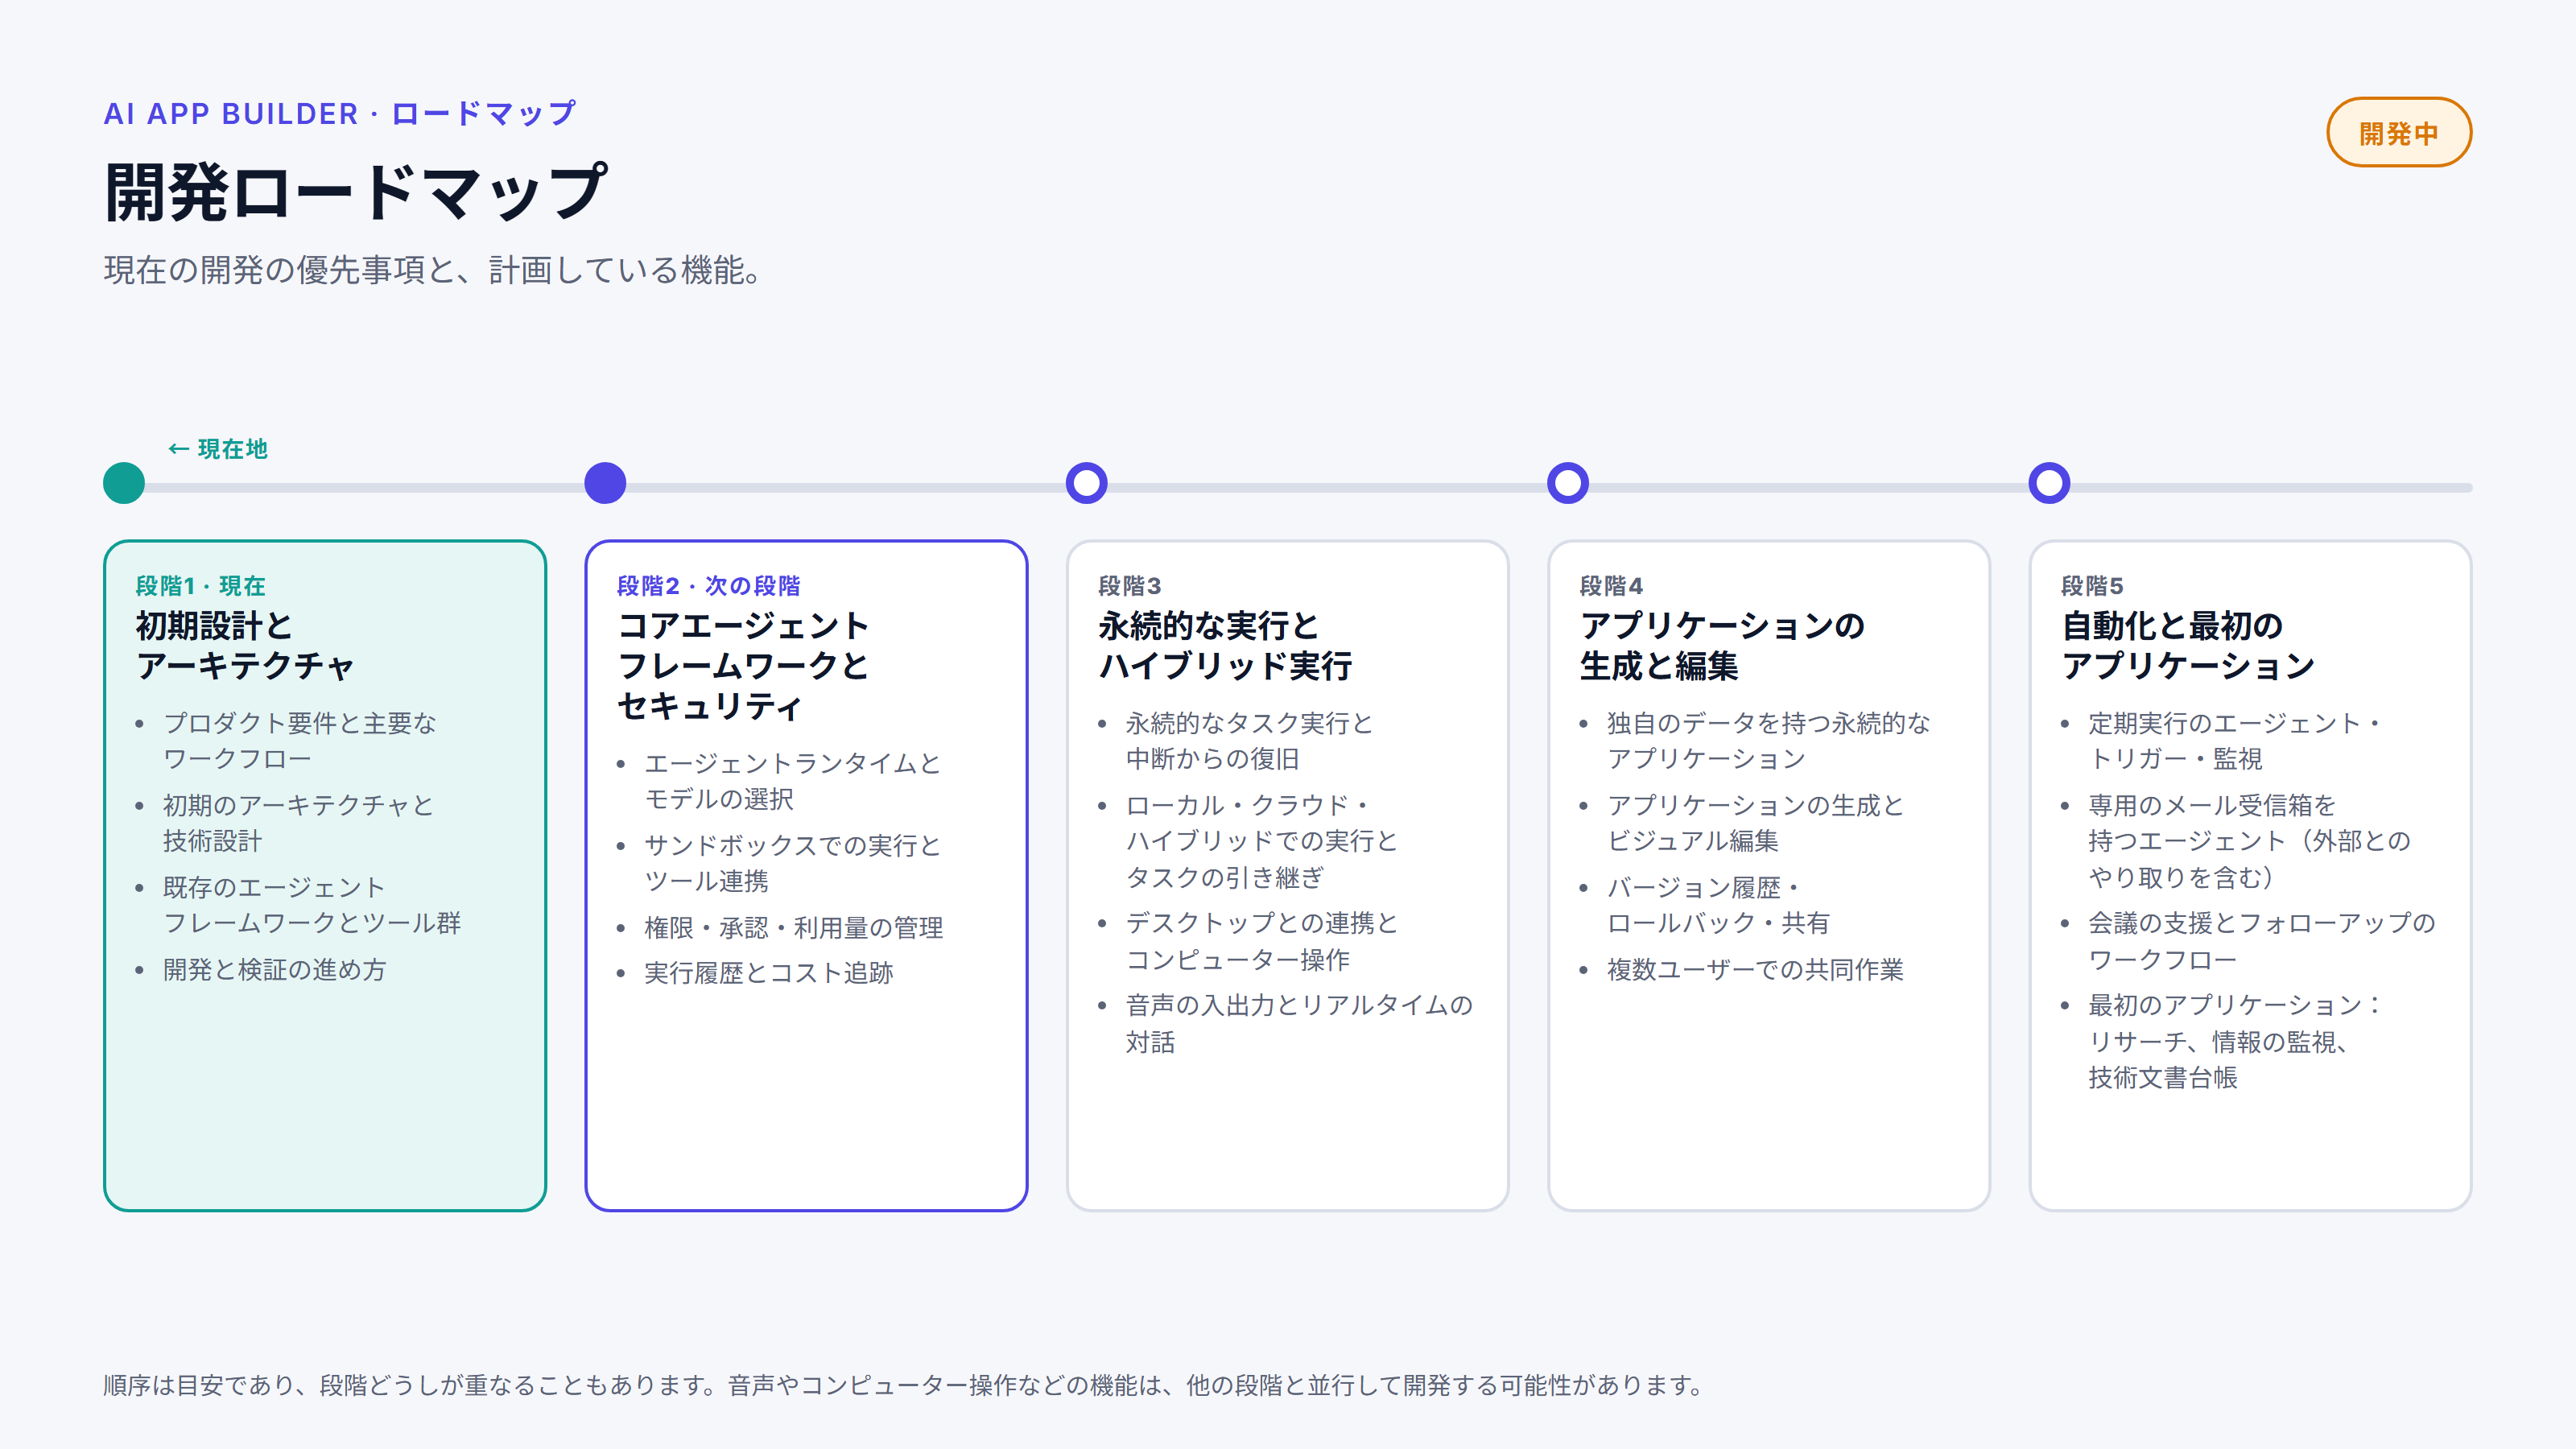
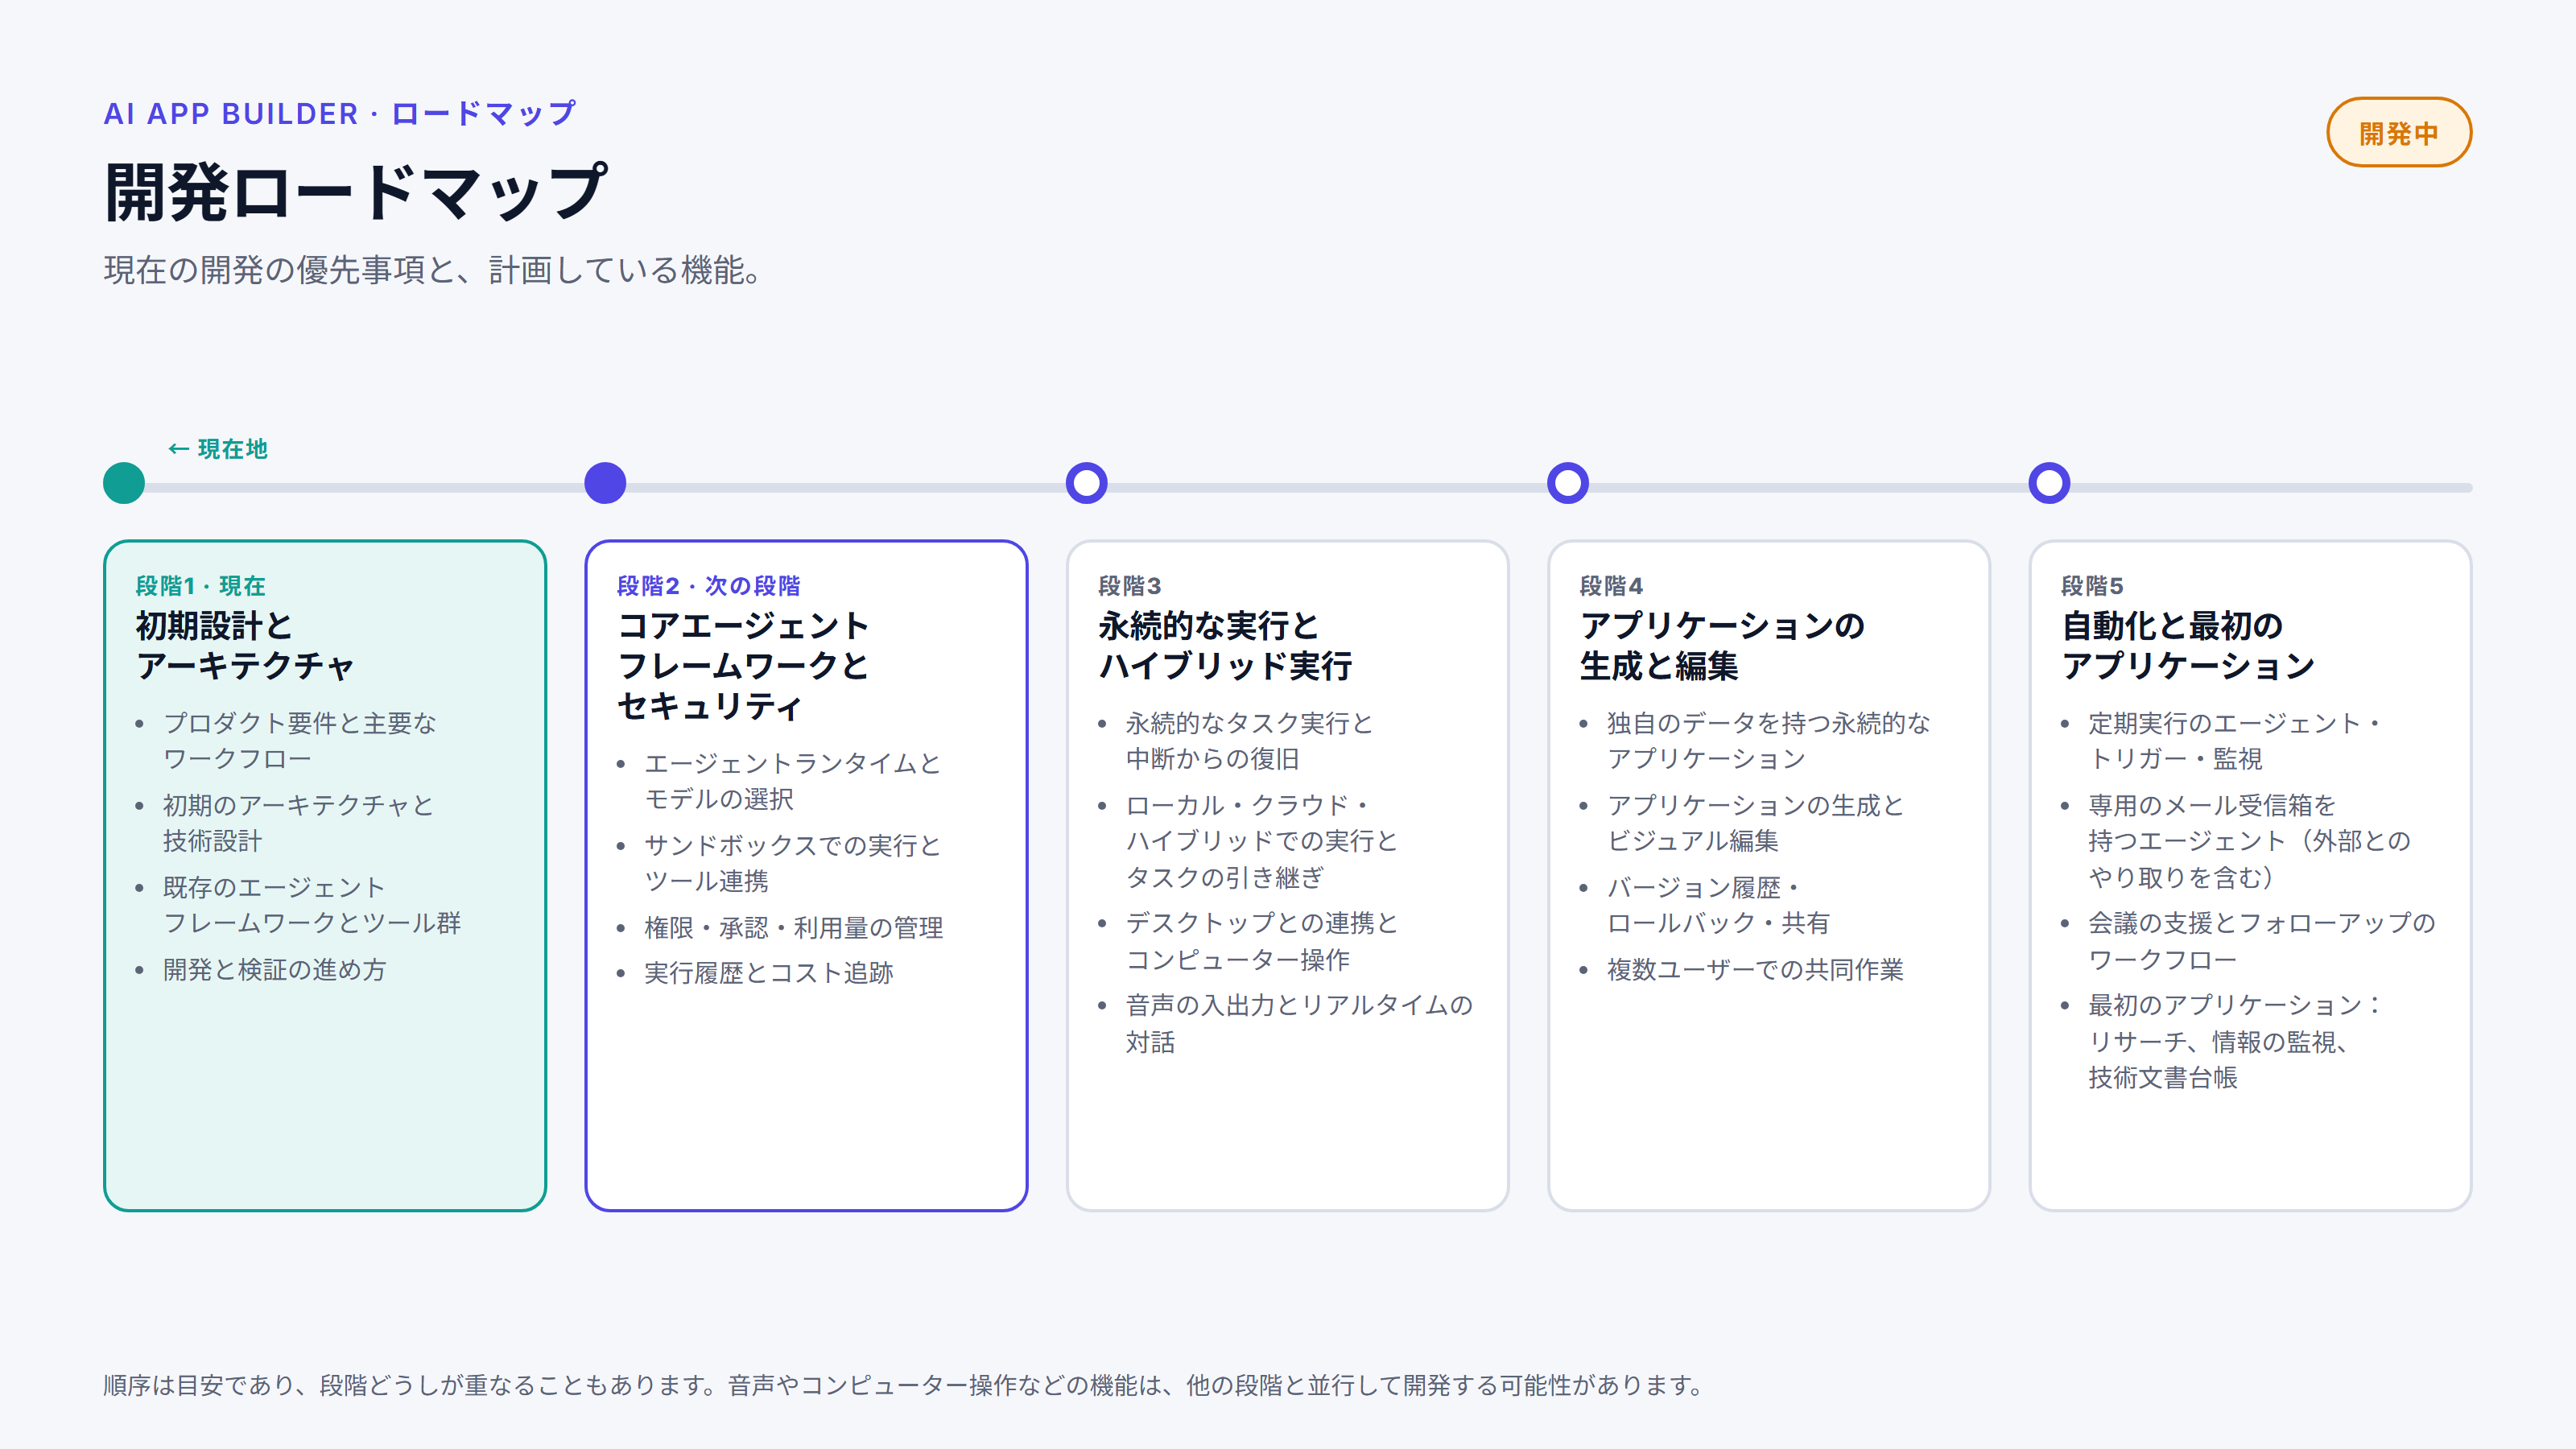
ロードマップは5つの段階で構成しています。順序は目安であり、段階どうしが重なることもあります。音声やコンピューター操作 (computer use) などの機能は、他の機能と並行して開発する可能性があります。ロードマップはまだ調整中なので、あえて日付は設けていません。設計作業では、AIの支援があっても2人ですぐに作れる量をはるかに超える数の、最初のバージョン向けのアイデアが出ました。そのため、ロードマップはスコープで順序を決めています。
| 段階 | 内容 |
|---|---|
| 1. 初期設計とアーキテクチャ(現在) | プロダクト要件と主要なワークフロー、初期のアーキテクチャと技術設計、既存のエージェントフレームワークとツール群、開発と検証の進め方 |
| 2. コアエージェントフレームワークとセキュリティ(次の段階) | エージェントランタイムとモデルの選択、サンドボックスでの実行とツール連携、権限・承認・利用量の管理、実行履歴とコスト追跡 |
| 3. 永続的な実行とハイブリッド実行 | 永続的なタスク実行と中断からの復旧、ローカル・クラウド・ハイブリッドでの実行とタスクの引き継ぎ、デスクトップとの連携とコンピューター操作、音声の入出力とリアルタイムの対話 |
| 4. アプリケーションの生成と編集 | 独自のデータを持つ永続的なアプリケーション、アプリケーションの生成とビジュアル編集、バージョン履歴・ロールバック・共有、複数ユーザーでの共同作業 |
| 5. 自動化と最初のアプリケーション | 定期実行のエージェント・トリガー・監視、外部とのやり取りにも対応する専用メール受信箱を持つエージェント、会議の支援、リサーチ・情報の監視・技術文書管理のための最初のアプリケーション |
この順序の背景には、いくつかの判断があります。
- 永続化よりもセキュリティを先にします。サンドボックスと権限チェックなしでエージェントを動かすべきではないため、これらはランタイムと並行して段階2で構築します。
- 監視とは、フォルダ、Webサイト、受信箱、データフィードなどをエージェントが見張り、変化があったときに対応することです。監視は、コストを抑える設計として計画しています。低コストで決定的なプローブ(モデルを使わない通常のコード)が、監視対象のフィンガープリント(内容が変わると変わる短い値)を計算し、意味のある変化があったときだけエージェントの実行を開始する想定です。1分ごとにモデルを呼び出すフォルダ監視なら、1日に1,440回のモデル呼び出しが発生します。ただし、変化が重要かどうかの判断にモデルが必要なモニターもあるため、モデルは必要な場面でだけ使うことを目指しています。
- 各エージェントは専用のメールアドレスを持てるようにする予定で、CCに入れたり、転送したり、メッセージを送ったりできます。外部の相手とのやり取りはスレッドごとの権限と承認の範囲内で行う計画で、設計では相手からのメッセージを指示ではなくデータとして扱います。ただし、他のポリシーと同様に、これも実装してテストするまでは、プロンプトインジェクション(メッセージ内のテキストがエージェントの行動を別の方向へそらそうとすること)への防御とはみなせません。
- 会議の支援には、情報の記録、要約、フォローアップのアクションが含まれます。どのように動作させるかは、細部をまだ詰めているところです。
- 各段階は、実際の作業でのテストで締めくくる計画です。たとえば、中断したタスクが止まったところから再開できること、プロンプトインジェクションが認証情報に到達できないことなどです。
未解決の課題
設計の中には、実際に作ってみないと決まらない部分もあります。
- ローカル実行とクラウド実行の間の引き継ぎ(進行中のタスクを、ユーザーのマシンとクラウドの間で受け渡すこと)が、実際にどこまで可能か
- どのモニターを決定的なまま(モデルを呼び出さず、通常のコードでチェックする形)にでき、どのモニターにモデルが必要になるか
- 会議の支援をどのように動作させるべきか
- 私自身のエージェントフレームワークをコアに残し続けるかどうか。設計には、どのような場合に置き換えるかを記録しています。保守にかかるコストが、それによって節約できる分を上回った場合です。
ご意見をお寄せください
開発の進捗に合わせて、更新を投稿していきます。技術文書台帳を扱うお仕事をされている方には、台帳業務のうちどの作業に最も時間を取られているかを、ぜひ伺いたいと思っています。最初のアプリケーションで確実に押さえるべきなのは、まさにその点だからです。ご意見やご感想があれば、お問い合わせページからご連絡ください。