完了リサーチ · AIエージェント · AI評価
大型設備投資プロジェクトのデータ向けAIリサーチエージェント
顧客の大型設備投資プロジェクトのレコードにある欠損を埋めるために構築した、マルチエージェントのツール。レコードは顧客のデータベースに取り込める形式で出力し、アナリストがレビューできるよう、出典の引用とチェックの結果を示します。
約9分で読めます
ソースコードは非公開ですが、仕組みのご説明やデモのご案内は喜んでいたします。
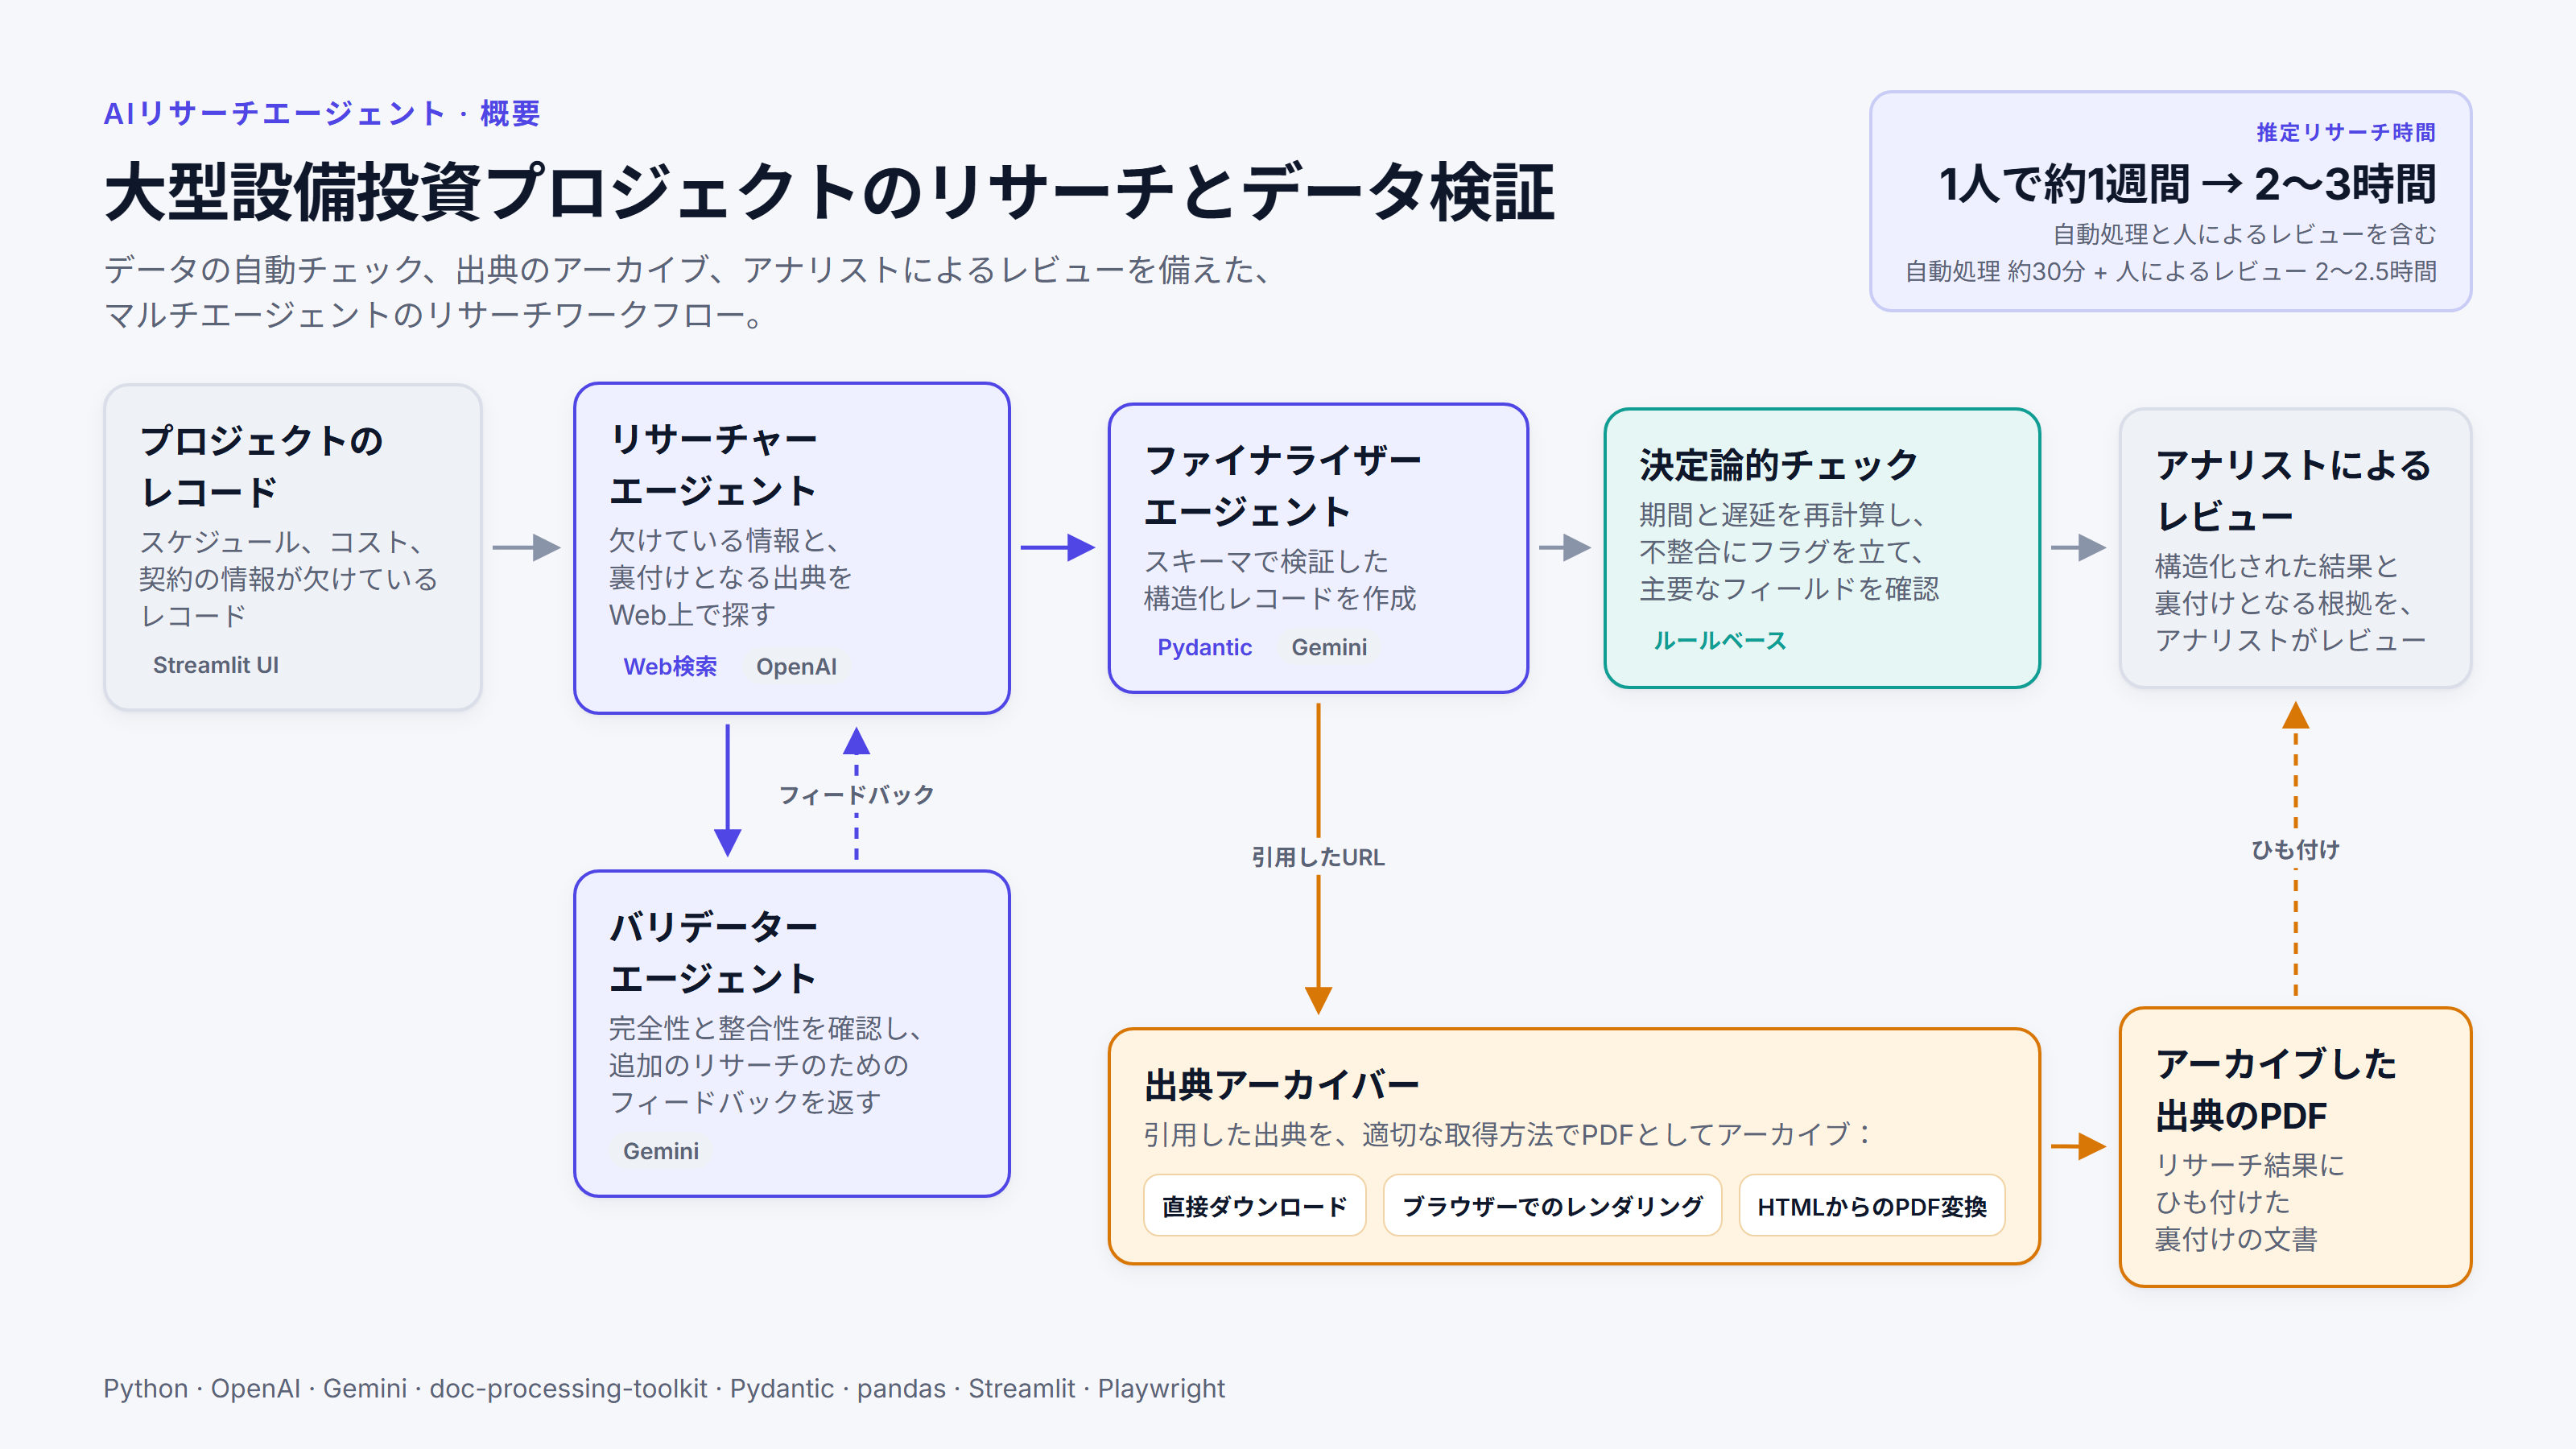
- 顧客での利用における1バッチあたりの推定リサーチ時間(アナリストによるレビューを含む)
- 約1週間 → 2〜3時間
- 1レコードのデモ実行(2025年10月21日):19フィールド中19フィールドを埋め、出典14件中13件をアーカイブ
- 219秒
使用技術
- Python
- OpenAI API
- Google Gemini API
- doc-processing-toolkit
- Pydantic
- pandas
- Streamlit
- Playwright
課題
ある顧客のデータ・アナリティクスチームは、大型設備投資プロジェクトのベンチマーク用データセットを管理していました。多くのレコードには、スケジュール上の日付、コストの変更、契約の詳細といった欠損がありました。それを埋めるには、デスクリサーチが必要でした。Webを検索し、発表資料やレポートを読み、日付のつじつまが合っているかを確認する作業です。1バッチに、1人でおよそ1週間かかっていました。手作業では、データを二度扱うことにもなりました。リサーチの後、完成したレコードを別のデータベースに取り込めるよう、誰かが値をそのデータベースが求める構造に整形し直す必要があったためです。
チームはこの作業を速くしたいと考えていました。同時に、ツールが埋めた値の一つひとつを、アナリストが確認できる出典までたどれる必要がありました。また、アナリストがデータを手直しせずに内容をレビューできるよう、ツールはそのデータベースの形式でレコードを出力する必要もありました。
リサーチの仕組み
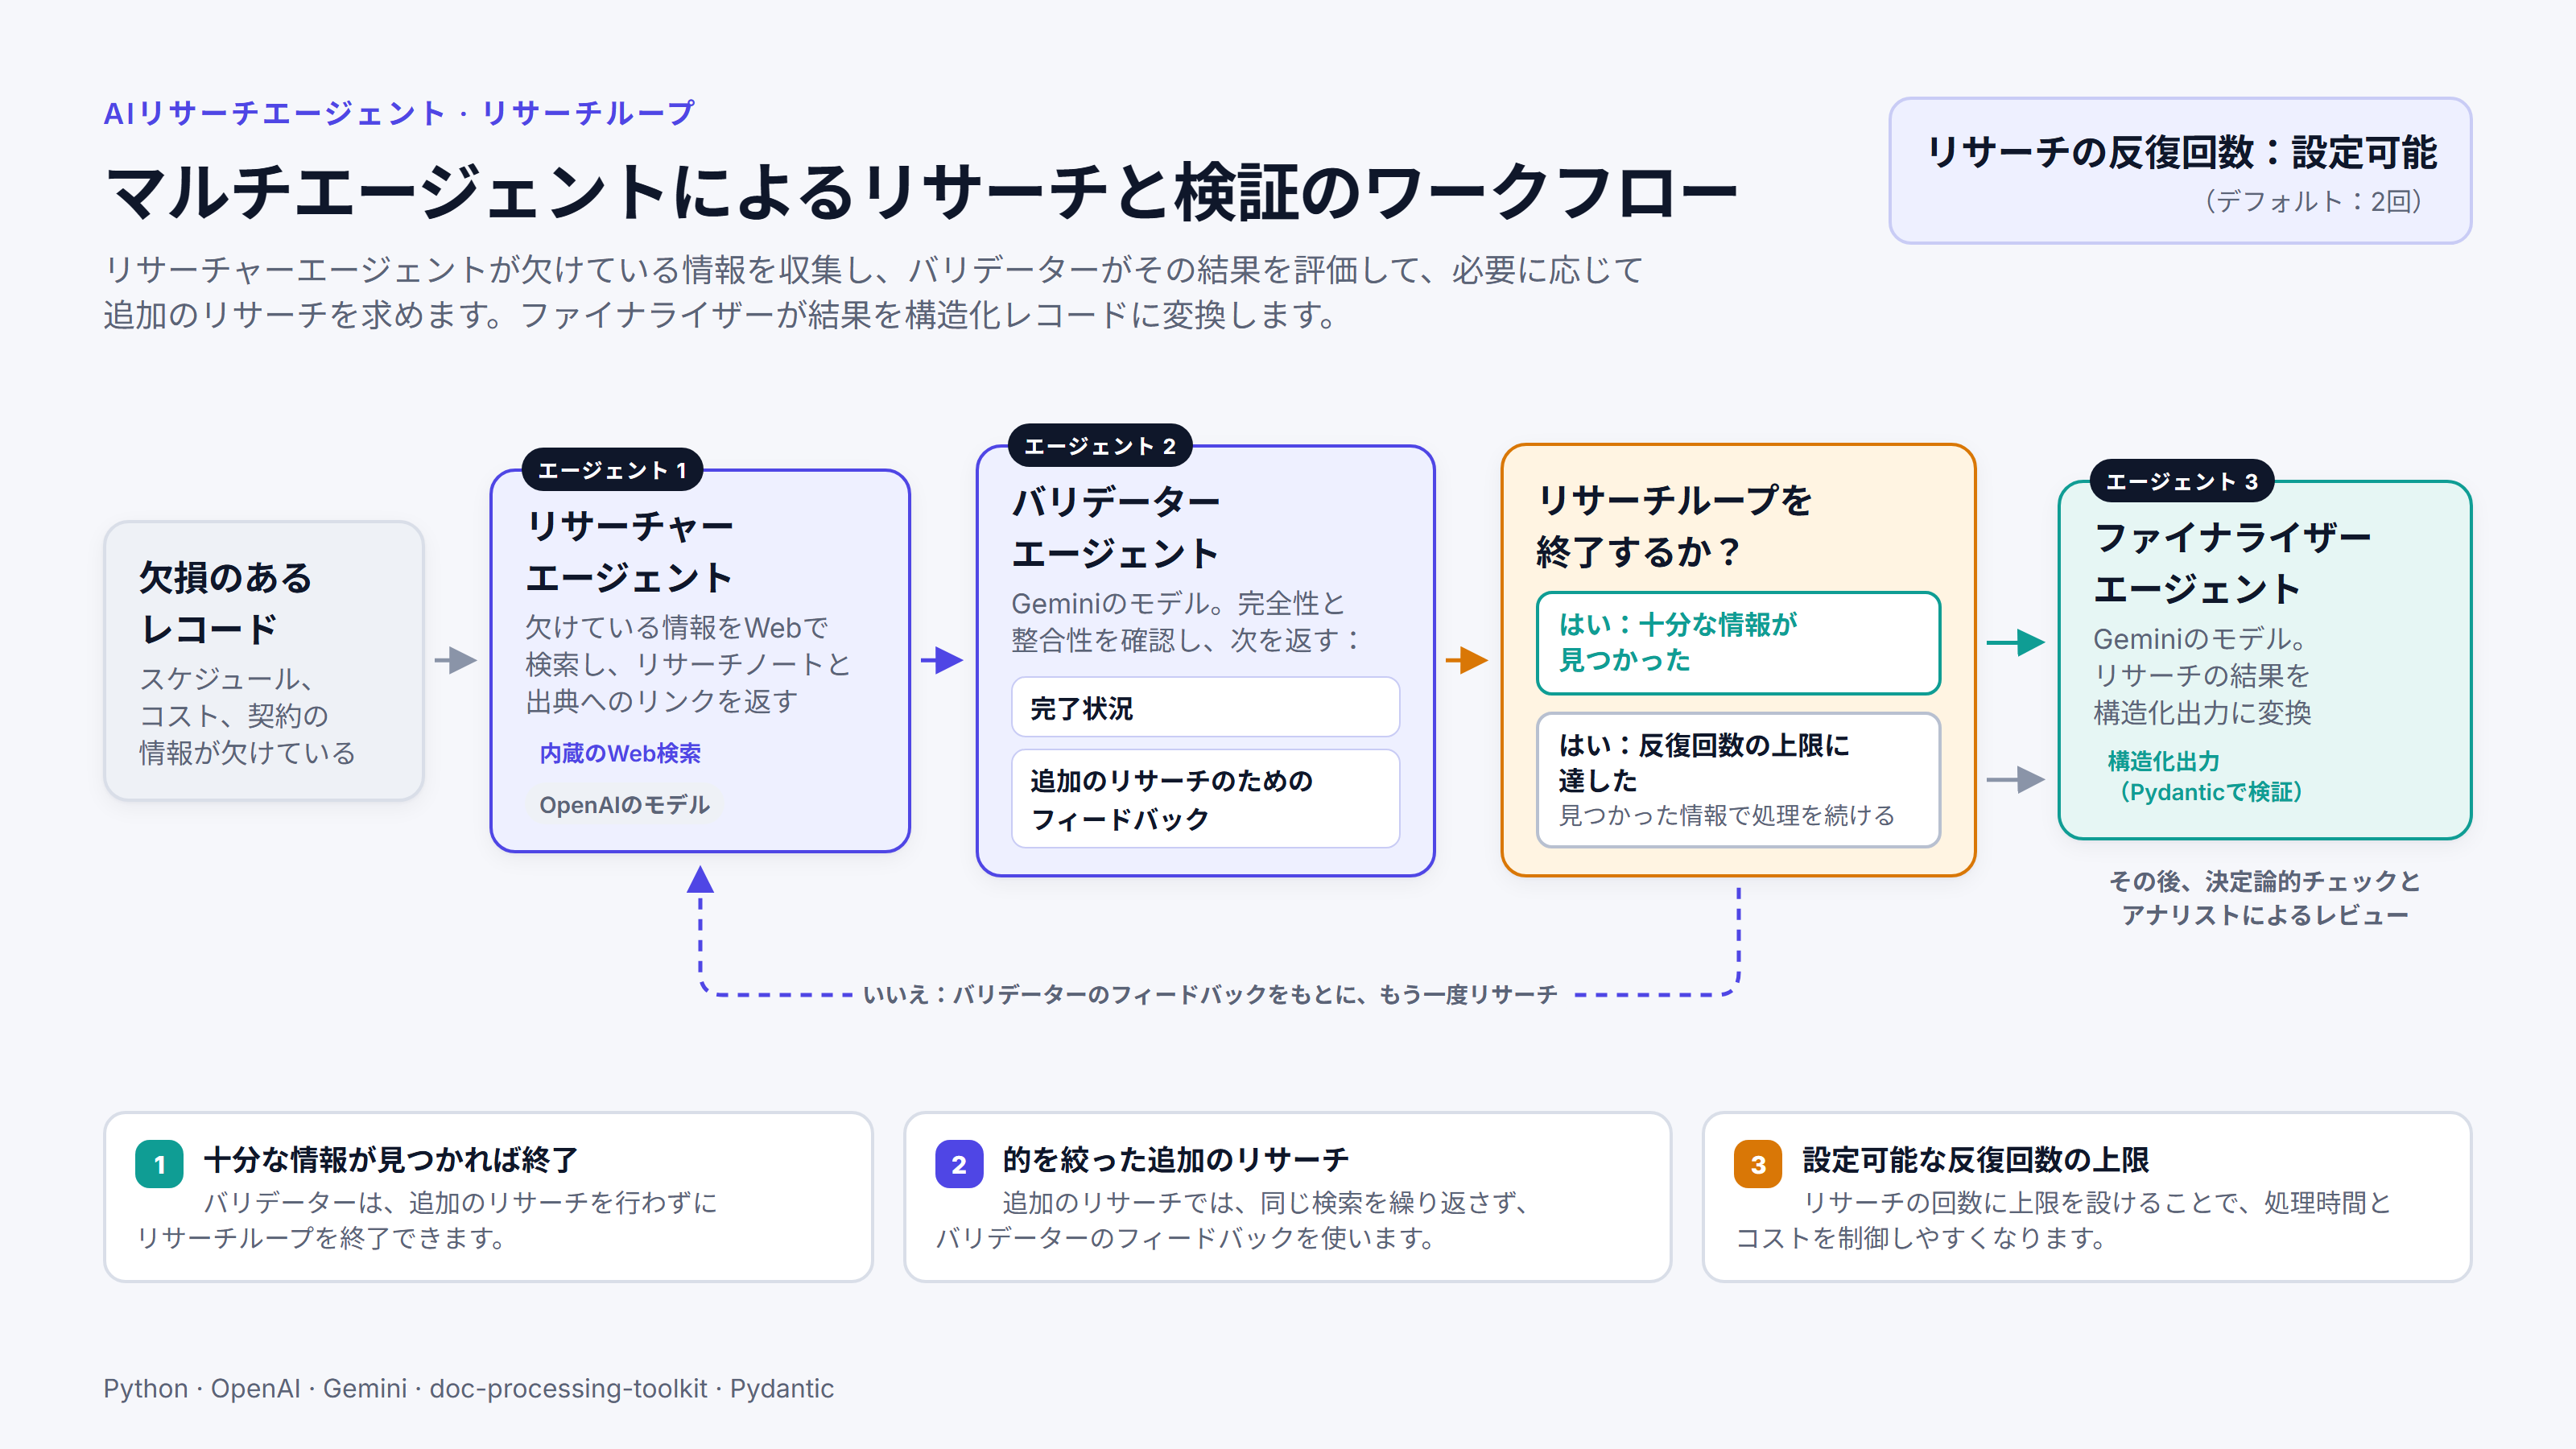
そのために、マルチエージェントのリサーチシステムを設計・開発しました。基盤には、私のエージェントフレームワーク(現在のdoc-processing-toolkit)の初期版で、このプロジェクト専用に作ったものを使いました。各レコードは、3つのエージェントを順に通ります。
たとえば、完了日と契約の詳細が欠けているレコードがあるとします。まず、リサーチャーエージェント(Web検索機能を内蔵したOpenAIのモデル)がその情報を探し、出典へのリンク付きのリサーチノートを返します。次に、Gemini上で動くバリデーターエージェントが、そのノートを完全性、日付の論理、出典の信頼性の観点から確認します。このバリデーターは、現在LLM-as-a-judgeと呼ばれている手法の一種です。役割の異なる2つ目のモデルが、1つ目のモデルの作業が十分かどうかを判断します。バリデーターは完了状況を返し、必要に応じて、もう一度リサーチするためのフィードバックも返します。たとえば2025年10月21日に録画したデモでは、プロジェクト途中のマイルストーンがプロジェクトの開始日として扱われていたため、バリデーターは1回目のリサーチを差し戻し、2回目のリサーチは承認されました。
繰り返しのリサーチを意味のあるものにしたのは、このフィードバックです。指示のないリトライは同じ検索を繰り返しがちですが、何が問題かを伝えられたリトライなら、たいてい新しい情報が見つかります。
ループは、バリデーターが情報は十分だと判断した時点、または設定可能なリサーチ回数の上限(デフォルトは2回)に達した時点で終了します。上限は処理時間とコストを抑えるためのもので、上限に達したからといって、必ずしもリサーチが完了したわけではありません。上限の値をどう選ぶかは、コストと正確さのトレードオフです。その後、同じくGemini上で動くファイナライザーエージェントが、結果を顧客のデータベースが必要とする形式の構造化レコードに変換し、Pydantic(Pythonのデータ検証ライブラリ)を使ってスキーマで検証します。ループが上限で止まった場合、ファイナライザーはそれまでに見つかった情報で処理を進めるため、一部のフィールドが空のまま、または不確かなまま残ることがあります。その場合も、レコードはチェックとアナリストによるレビューを経ます。
モデルは、開発の初期に他の候補を試したうえで選びました。測定には評価セットを使いました。顧客のチームがすでに手作業でリサーチしていて、正しい値がわかっているレコードです。その後、同じセットをシステム全体のベンチマークにも使いました。このタスクでは、Web検索を内蔵したOpenAIのリサーチャーと、検証と最終化を担うGeminiの組み合わせが、コストと品質のバランスで最も優れていました。
チームのデータモデルに基づく設計
レコードは、チーム独自のデータモデルに従っていました。フィールドは19個で、そのうち2つは定められたリストから値を取り、値ごとに定義があります。プロジェクトのスケジュールやコストが変わった理由15種類と、契約戦略7種類です。私はこのモデルをスキーマとして一度だけ書き、3つのエージェントすべての指示をそこから生成しました。新しいフィールドやカテゴリーは、リサーチャー、バリデーター、ファイナライザーに同時に反映され、完成したレコードも同じ定義に照らしてチェックされるので、エージェントはチーム自身の用語を使います。
チェックとアナリストによるレビュー
日付の計算や整合性ルールの適用はモデルに任せたくなかったので、エージェントの作業が終わった後は、ルールベースのPythonのチェックが引き継ぎます。言語モデルは出典を探して読むのは得意ですが、モデルによる計算は、毎回同じ答えを出すコードで同じ計算をするよりもコストがかかり、信頼性も低くなります。それぞれを得意なことに使うのは、機能する設計のなかで最もシンプルなものでもありました。チェックでは、日付からプロジェクトの期間と遅延を再計算し、不整合にフラグを立て、主要なフィールドを確認します。その後、アナリストが、引用された出典とチェックでフラグが立った点をあわせてレコードをレビューし、何を採用するかを決めます。
出典のアーカイブ
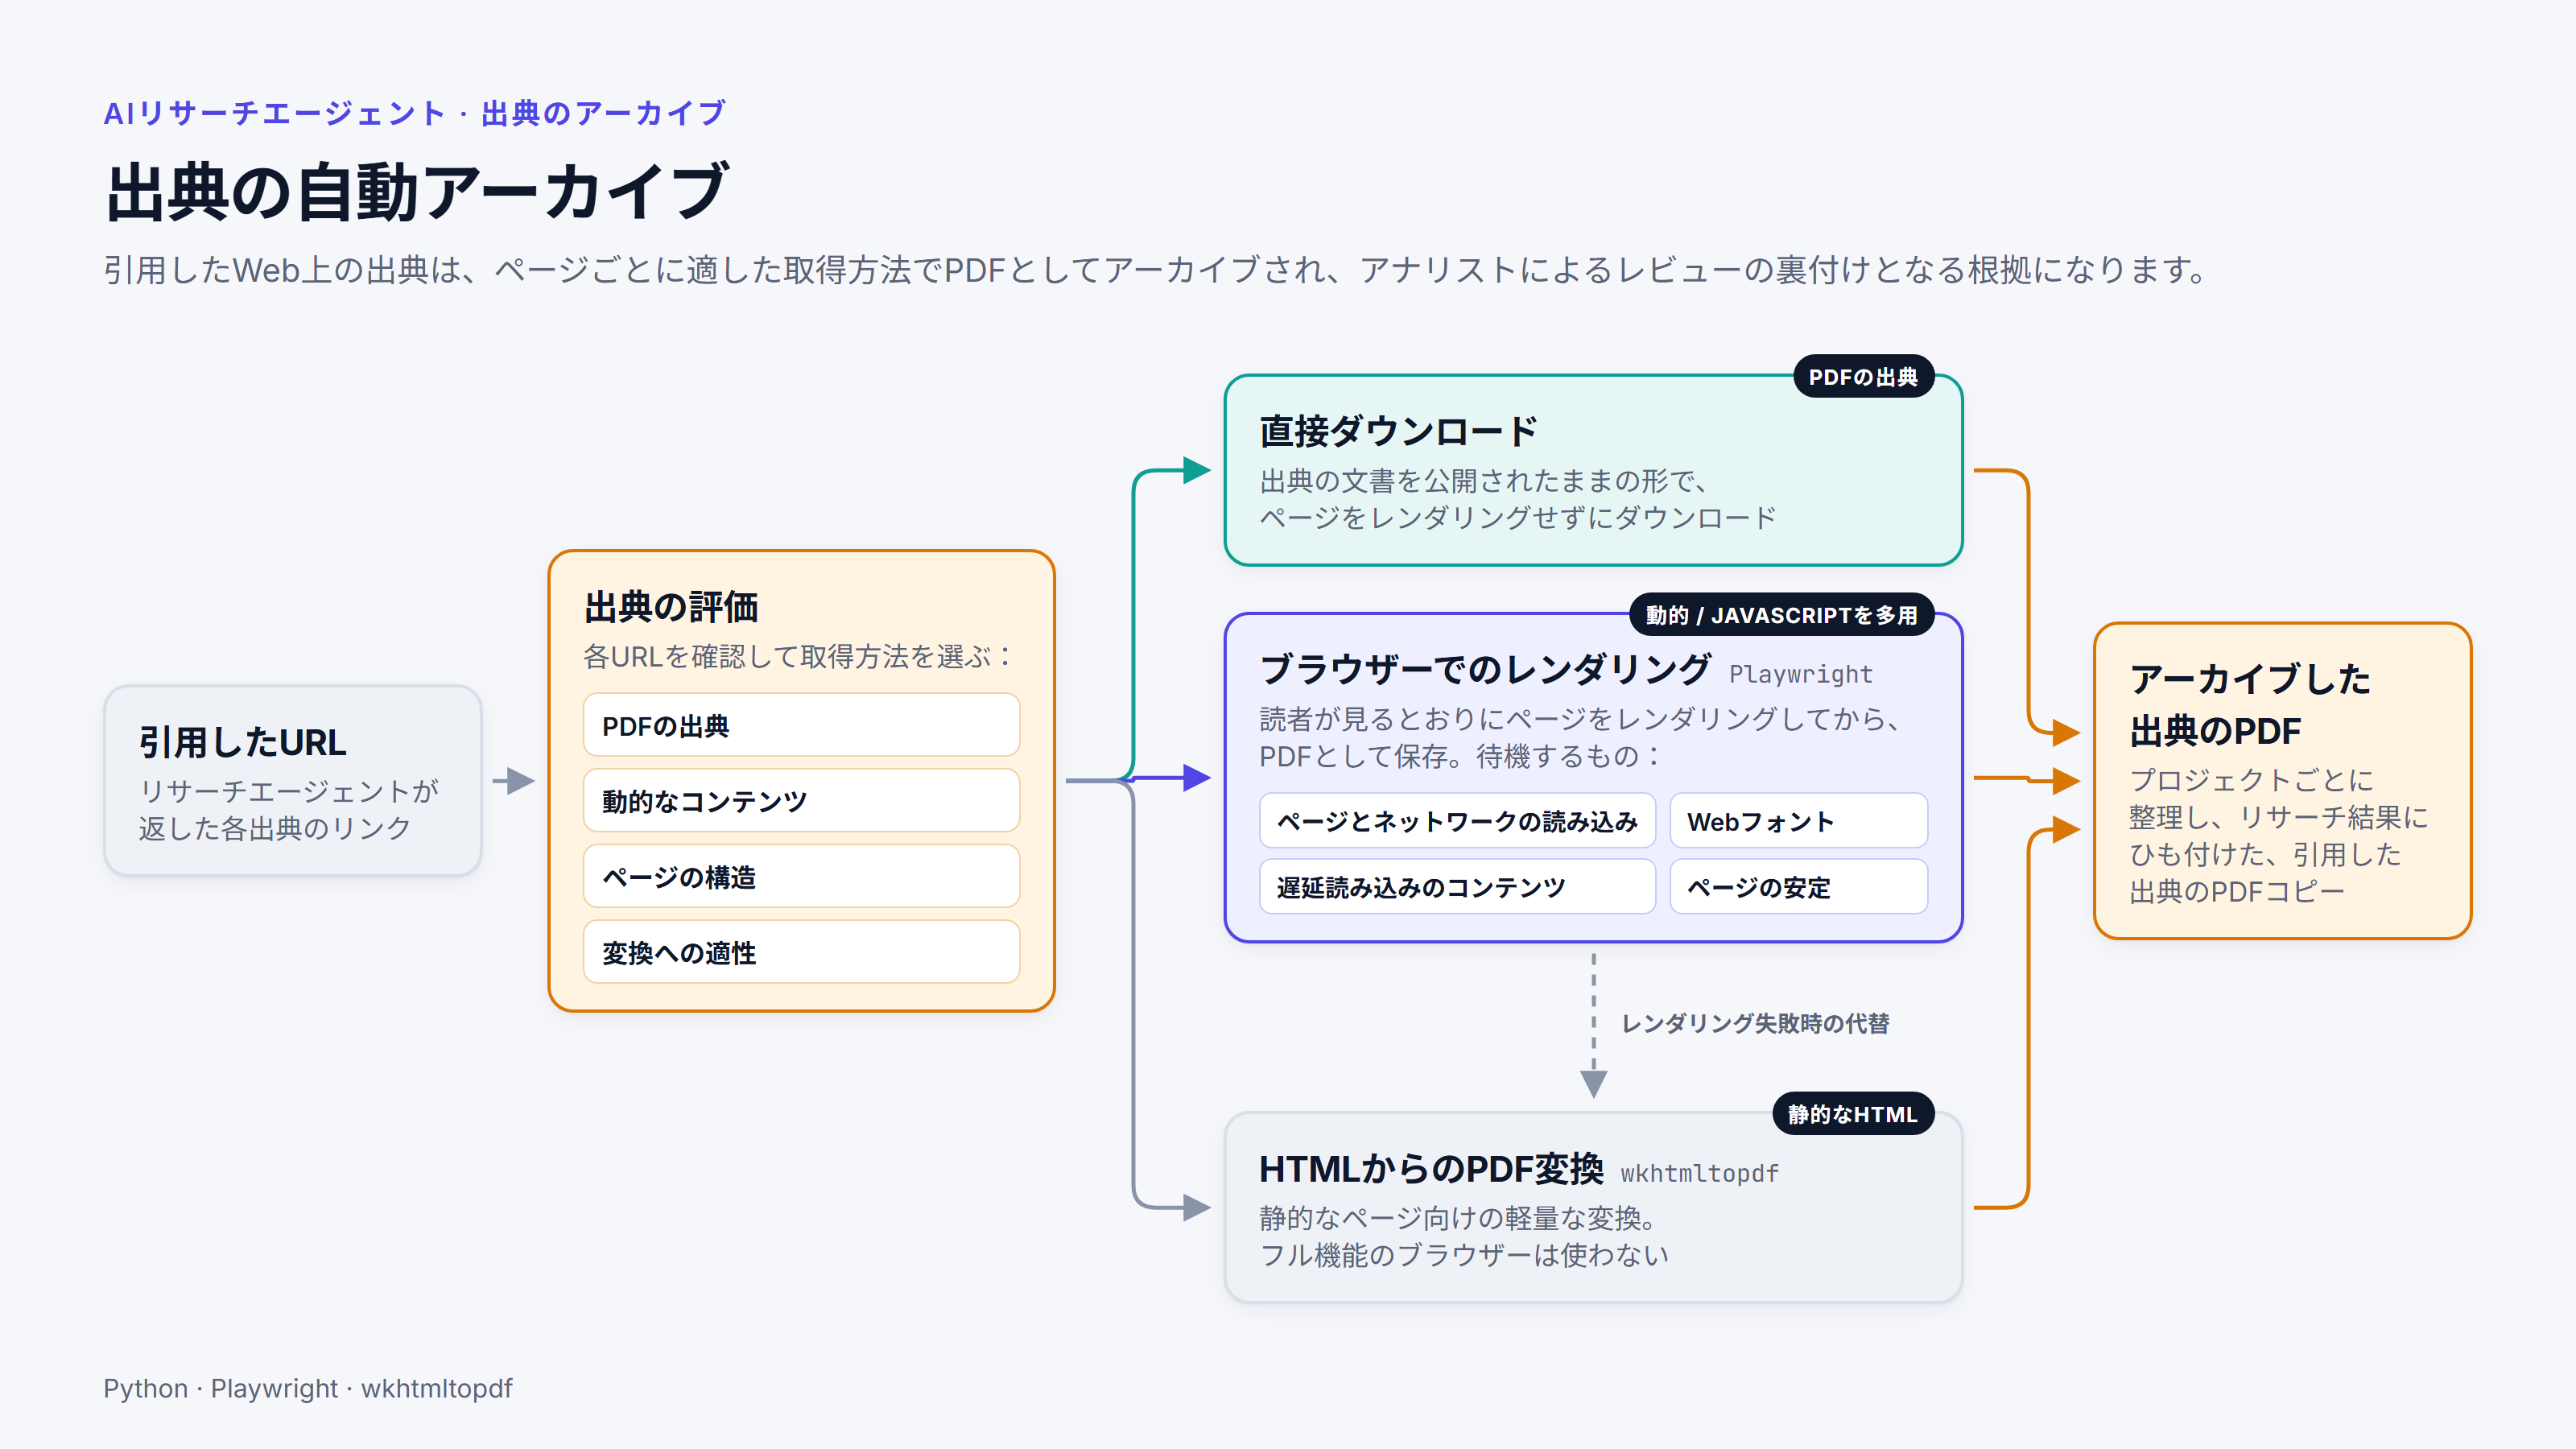
Webページは変わったり消えたりするため、リンクだけでは、アナリストが頼りにするには不十分でした。そこで補助ツールが、引用した各出典をPDFとして保存します。取得方法は、ページに合わせて選びます。出典がもともとPDFならファイルを直接ダウンロードし、JavaScriptを多用する動的なページはPlaywrightを使ってブラウザーでレンダリングし、静的なページはHTMLをPDFに変換するツールのwkhtmltopdfで変換します。ブラウザーでのレンダリングに失敗した場合は、HTMLからのPDF変換で代替します。
PDFはプロジェクトごとに整理され、リサーチ結果にひも付けられるので、アナリストは各出典をリサーチ時点の状態で確認できます。アーカイブはほとんどの出典でうまくいきましたが、いくつかの例外的なケースでは、引き続きアナリストが元の出典を確認する必要があります。
測定の方法
顧客のチームはこれらのレコードを手作業で埋めていたので、その成果を測定の基準にできました。最初の10件のプロジェクトのうち、4件は完全にリサーチされていてすべての値に出典があり、6件はデータの一部がそろっていました。
完全な4件のプロジェクトはシステムの調整に使い、実行のたびに結果を既知の値と比べました。その差分から、何を変えるべきかがわかりました。現在の指示では、どの出典を優先するか、どのような不整合に注意するかを示し、フィールドを「見つからない」とする前に根拠を求めています。また、スキーマを厳密にし、日付に対するルールベースのチェックを追加し、モデルも変更しました。2025年8月の第1週に、リサーチャーはgpt-4.1-miniからo4-miniに、バリデーターとファイナライザーはGeminiのFlash-LiteモデルからGemini 2.5 Proに切り替えました。
続いて、残りの6件のプロジェクトについて、レコードに欠けていたフィールドを対象にシステムを実行し、その回答を自分で出典と照らし合わせて確認しました。私の確認では、正しく埋められたフィールドの割合は、これらのラウンドを通じて約半分から約90%に上がりました。最も難しかったのは日付です。出典によって、同じマイルストーンについて複数の日付が示されていることが多いためです。57件のプロジェクトの全件実行の後、引き渡しの前にいくつかを手作業で抜き取り確認しました。後に顧客から、実際の利用で結果がおよそ90%正確だという確認を得ました。
チェックは通常の運用でも有効なままです。全件実行では、57件中26件のプロジェクトにアナリストが確認すべきフラグを立てました。最も多かった理由は、プロジェクトが予定より早く完了したように見えることでした。人が関与するこのレビューにかかる時間は、すべてのレコードを手作業でリサーチしていたときと比べればわずかで、このレビューによって、データセットは頼りにできる正確さに保たれています。
成果と引き渡し
2025年10月21日に録画したデモでは、1件のレコードの処理に219秒かかりました。この実行では、19フィールド中19フィールドを埋め、引用した出典14件中13件をアーカイブしました。
バッチ単位の数字は、引き渡し後に顧客が本番で利用した際の私の推定です。1バッチあたり1人でおよそ1週間かかっていたリサーチが、人によるレビューを含めて2〜3時間に短縮されました。そのうち約30分が自動処理で、残りの2〜2.5時間がアナリストによるレビューです。
システムは、チーム向けのStreamlitのWebインターフェースとドキュメントを添えて納品し、2025年11月に顧客へ引き渡しました。現在は、顧客のチームが運用しています。
学んだこと
改善を測定できたのは、評価セットがあったからです。正しい値がわかっているレコードがなければ、プロンプトやモデルへの変更を、出力がもっともらしく見えるかどうかで判断することになっていたでしょう。そして、誤ったマイルストーンから取った日付も、正しい日付と同じくらいもっともらしく見えることがあります。
すべてのフィールドを埋めるようモデルに強いるプロンプトは、捏造された回答を招きます。エージェントが見つからなかったと答えられるようにし、その正確さをフィールドごとに確認する必要があります。今回は、リサーチャーが探したことの根拠を示せば、フィールドを「見つからない」とすることができました。これにより、アナリストはどの値が欠けているかがわかり、評価では各フィールドを個別に採点しました。このプロジェクトで最も安上がりだった品質向上策は、リサーチャーと出力の間にバリデーターを置くことでした。「まだ足りない」と伝えてその理由を説明することだけが役割の、2つ目のモデルです。
このシステムを拡張するなら、役割ごとのモデル選択機能のつなぎ込みを完成させ、新しいモデルが出るたびに、評価セットを使ってコストと品質の比較をやり直せるようにします。
プロジェクトのその他の画像